الشبكة العصبية للنصوص: كيف نقيس الجودة ونحسّنها
وصف أحد مطوّري Bitrix24 كيف بنى نظام تقييم شاملًا (eval) لمساعد الذكاء الاصطناعي «مارتا»، ويشمل مجموعة بيانات خبيرة وأخرى اصطناعية. ويشرح لماذا لا ترتبط مقاييس الاسترجاع (retrieval) بالجودة الفعلية للإجابات. كما يوضح كيف أغلق حلقة الوكيل (agentic loop) بحيث يُختبر كل تجربة تلقائيًا، لا «بالعين المجردة».
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News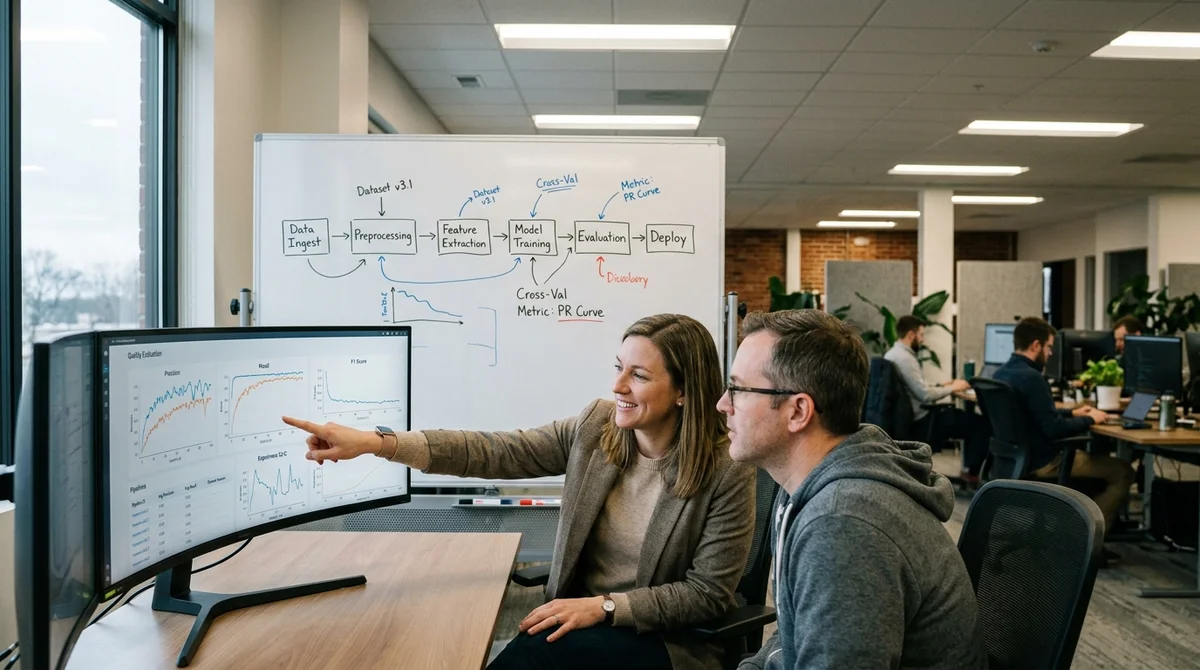
نشر فريق Bitrix24 تحليلًا تقنيًا لنظام قائم على شبكة عصبية لمعالجة النصوص. ويتناول التحليل كيفية قياس جودة السلسلة كاملةً، ولماذا لا تكفي مقاييس البحث وحدها، وكيف يمكن أتمتة دورة التجارب.
لماذا لا تكفي المقاييس الكلاسيكية للشبكة العصبية؟
تُظهر مقاييس البحث (precision وrecall وMRR) مدى دقة العثور على المستندات المطلوبة، لكنها لا تجيب عن السؤال الأهم: هل حصل المستخدم على إجابة مفيدة؟
كيف نؤتمت تحسين الشبكة العصبية للنصوص؟
يجب أتمتة دورة التجارب بحيث يمكن التحقق من كل تغيير بصورة منهجية. وبذلك لا نقيس مقاييس منفصلة، بل جودة سلسلة معالجة المعلومات كاملةً.
Delegate Deep Research, Coding & Workflows to an AI Agent
Deploy autonomous multi-step execution with NomadNet Agent (agent.nomadnet.ai) — automated web research, data synthesis, code generation, and complex task orchestration.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.