شبكة عصبية صغيرة تتفوق على Claude Opus وGPT-5
تفوّق النموذج المتخصص Dharma-OCR (3B معامل) على Claude Opus وGemini وGPT-5 في التعرف على النصوص البرتغالية. كانت دقته أعلى، وتشويهه للنص أقل، وتكلفته أقل بـ 52 مرة. والخلاصة أن التخصص في المهام الضيقة أهم من حجم النموذج.
معالج بواسطة الذكاء الاصطناعي من Hugging Face Blog؛ بتحرير Hamidun News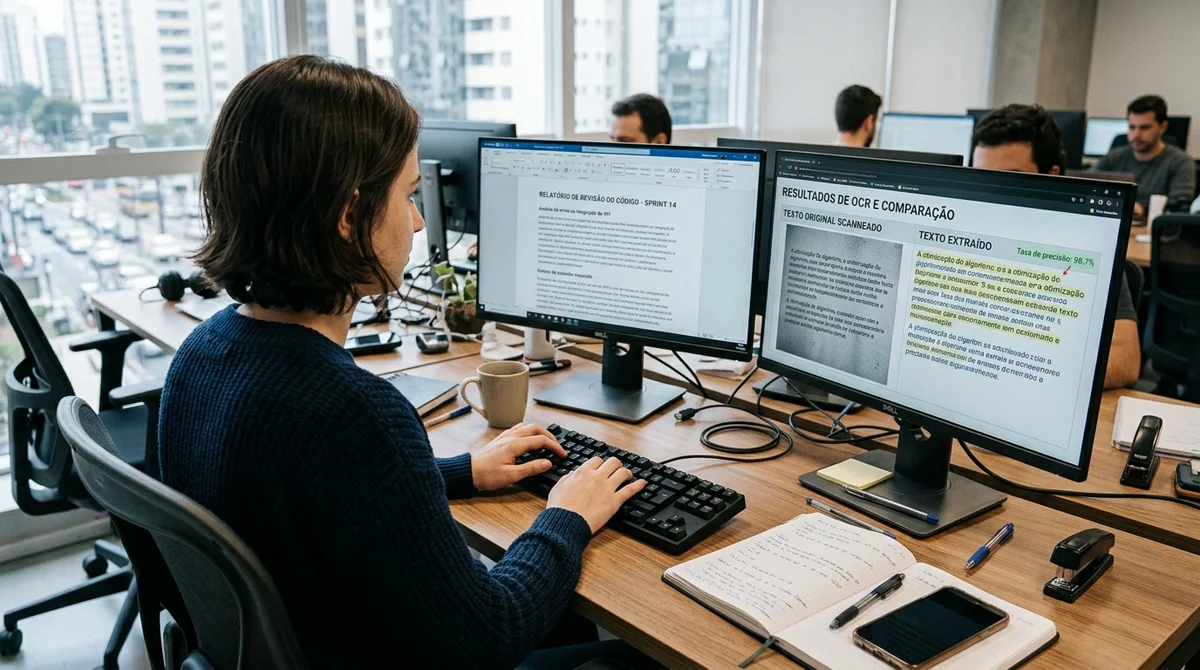
نشرت Dharma AI اختبار أداء (بنشمارك) يشكّك في فرضية أساسية في الذكاء الاصطناعي المؤسسي، وهي أن زيادة عدد المعاملات تعني نتيجة أفضل. فقد تفوقت شبكتها العصبية بثلاثة مليارات معامل، المدرَّبة خصيصًا على التعرف الضوئي على الحروف (OCR) للغة البرتغالية، على Claude Opus 4.6 وGemini 3.1 Pro وGPT-5.4 في آنٍ واحد، من حيث الجودة والاستقرار والتكلفة.
لماذا تتفوق الشبكة العصبية المتخصصة على نماذج الذكاء الاصطناعي الكبيرة؟
حسّنت Dharma AI شبكتها العصبية بثلاثة مليارات معامل خصيصًا للتعرف الضوئي على الحروف في اللغة البرتغالية. وتفوق النموذج على Claude Opus من حيث الدقة (0.911 مقابل 0.833)، ولا تتجاوز نسبة تشويه النص فيه 0.20%، وتكلفته أقل بـ 52 مرة.
هل يمكن لشبكة عصبية صغيرة أن تتفوق على ChatGPT وClaude؟
نعم، إذا كانت متخصصة في مهمة بعينها. فقد حصل Dharma OCR على 0.911 نقطة في اللغة البرتغالية، متفوقًا على Claude Opus (0.833) وGPT-5.4، وبتكلفة أقل بـ 52 مرة.
كيف تفوقت شبكة عصبية صغيرة على Claude Opus وGPT-5؟
بفضل التخصص في التعرف على النصوص. ففي اختبار الأداء، سجّل Dharma-OCR 0.911 نقطة مقابل 0.833 لـ Claude Opus، فيما بلغت نسبة تشويه النص 0.20% فقط.
كم مرة تقل تكلفة الشبكة العصبية المتخصصة؟
تقل بـ 52 مرة عن تكلفة Claude Opus، مع جودة نتائج أعلى.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.