Локальные LLM
Локальные LLM — это языковые модели, которые работают прямо на вашем железе: ноутбуке, ПК с видеокартой или домашнем сервере — без облака, подписок и передачи данных наружу. Ollama, llama.cpp и LM Studio плюс квантованные GGUF-версии Llama, Qwen и Gemma делают это доступным даже на видеокарте десятилетней давности. Здесь — все наши материалы о локальном запуске ИИ: гайды, тесты железа, квантизация и приватность.
Локальный ИИ на M1: почему магия Apple разбилась о суровую реальность
Попытка запустить нейросети локально на старом добром M1 обернулась поучительным уроком. Рассказываем, почему ваш верный макбук может не вывезти революцию.
Apple тратит $2 млрд на Q.AI: в Купертино перестали экономить?
Вторая по величине сделка в истории Apple. Покупка израильского стартапа Q.AI за такие деньги — это не просто поглощение, это признание: в гонке ИИ пора играть…
Дистилляция разума: почему нейросетям вредны слишком умные учителя
Ученые из Фуданьского университета нашли способ обучать маленькие LLM в десять раз эффективнее, используя концепцию «знакомых незнакомцев».
ИИ-суверенитет: миф или реальность в эпоху глобализации?
Страны инвестируют триллионы в «суверенный ИИ», стремясь к независимости в сфере искусственного интеллекта. Но возможно ли это в современном мире?
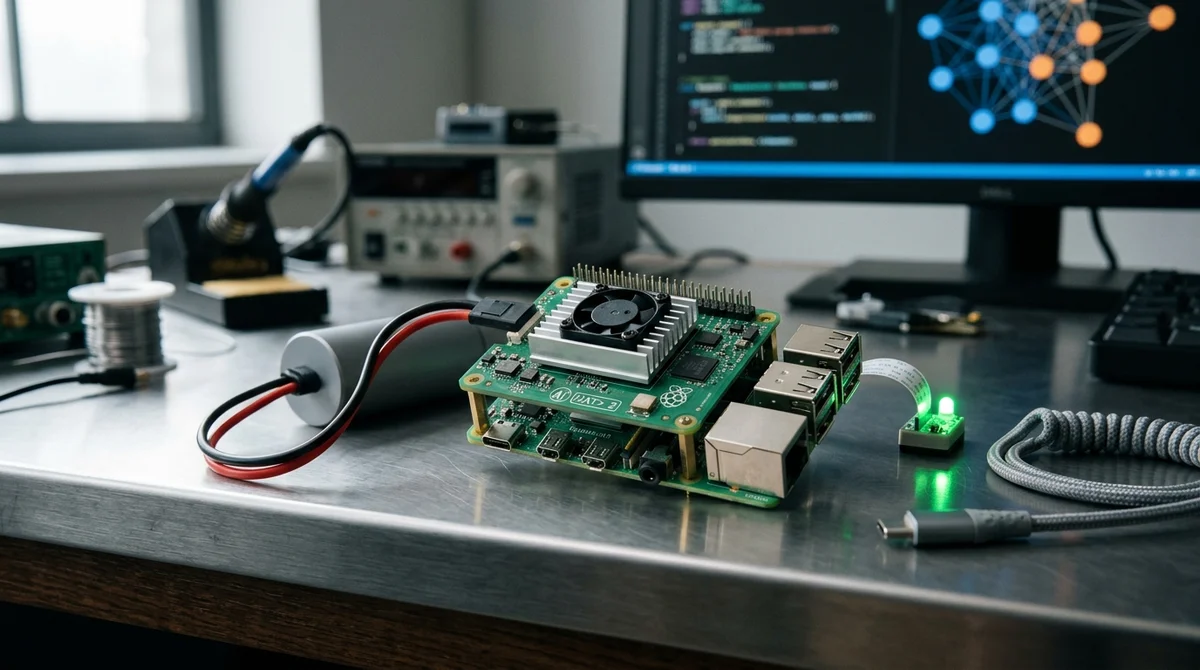
Raspberry Pi запускает плату для локального запуска генеративного ИИ
Новая плата AI HAT+ 2 от Raspberry Pi за 130 долларов оснащена 8 ГБ ОЗУ и чипом Hailo 10H, позволяя запускать модели генеративного ИИ локально на Raspberry Pi 5.