Автор оживил картину XIX века по слоям: на 1 удачный клип — 4–5 неудачных
Если отдать видеомодели картину целиком, она перерисует лица, мундиры и мост. Поэтому автор разобрал картину Альма-Тадемы про переправу через Березину на слои в Photoshop, оживил фигуры по одной в MiniMax H3 и собрал сцену в After Effects. Цена контроля — время: на один годный клип приходилось 4–5 неудачных. Для сложных сцен выгоднее дробить задачу и проверять каждый кусок.
AI-обработка оригинала Habr AI; редакция Hamidun News
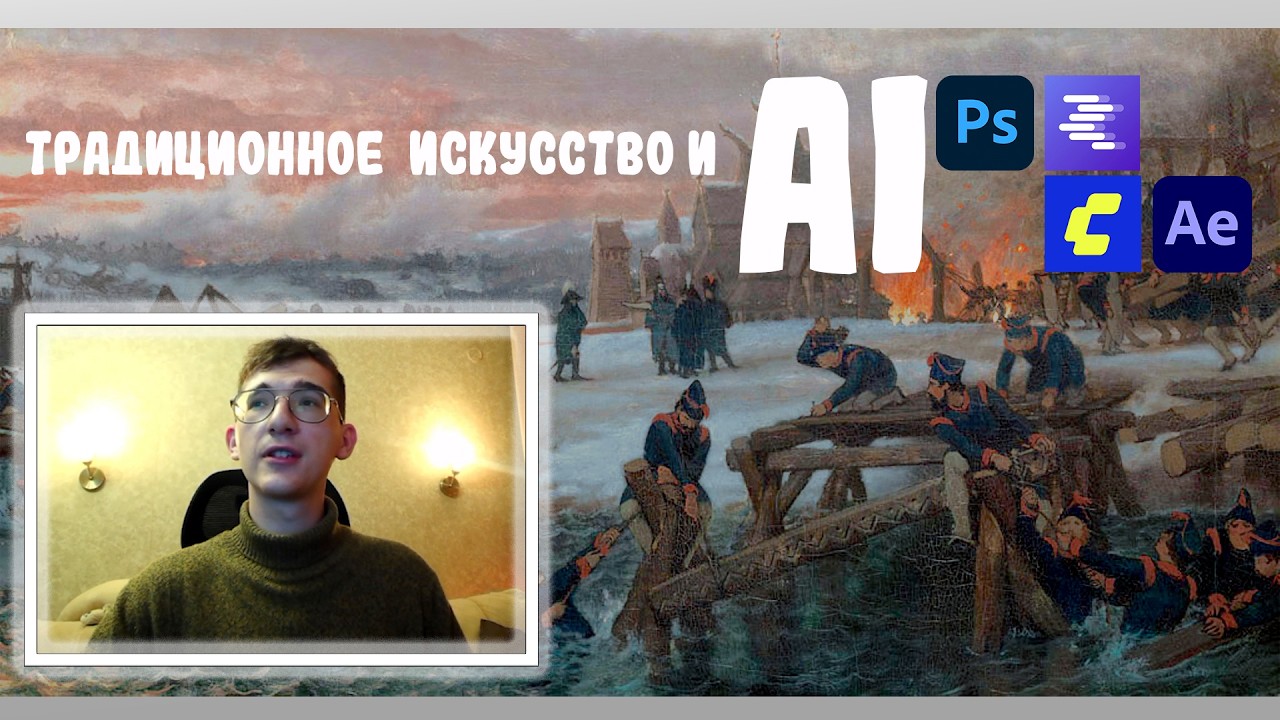
Видеогенераторы научились красиво двигать картинку, но стоит дать им сложную сцену с десятками людей, и они начинают придумывать своё: меняют лица, мундиры, архитектуру и даже число рук. Представьте, что вы просите модель оживить историческую картину, а в результате у солдата вместо шинели появляется другая одежда, а мост строится в другую сторону. Автор Habr Дмитрий (канал Dmitrii DAK) обошёл эту проблему на примере картины Лоуренса Альма-Тадемы «Anno 1812.
Kapitein Benthien aan de Beresina»: на ней голландские понтонёры строят переправу через Березину во время отступления армии Наполеона. Вместо одного запроса «оживи всё» он разбил работу на маленькие управляемые куски. Цена такого контроля — время: по его наблюдению, на один годный клип приходится 4–5 неудачных или «почти» удачных генераций.
Это опыт одного процесса, а не универсальная статистика, но он хорошо показывает, где на самом деле уходят силы.
Сначала слои, потом движение
Первый этап проходит в Photoshop. Автор выделяет персонажей и объекты, переносит каждый на отдельный слой и группирует слои по смыслу: вода, люди, конструкции. Главное правило: фрагменты сохраняются в исходной системе координат холста, то есть без обрезки до минимального прямоугольника. Тогда в After Effects слои ложатся друг на друга без ручной подгонки масштаба и позиции.
Дальше возникает проблема дыр. Если вынуть солдата, за ним должны оказаться доски, плечо другого человека, снег. Эти участки дорисовываются через inpainting (дорисовку фона нейросетью) так, чтобы совпали цвет, свет, направление мазков и перспектива. На статичной картинке шов можно не заметить, а в движении фон начинает «плыть» относительно фигуры, поэтому стыки автор проверяет особенно тщательно.
Отдельный шаг — лица. На картине многие фигуры маленькие, и при анимации «мыльное» лицо выдаёт подмену. Персонажей прогоняют через улучшение детализации с условием не менять позу, пропорции и живописный характер. Заодно фон за ними заменяют на зелёный: позже его убирают в композитинге пипеткой, потому что позади стоят другие анимируемые герои.
Локальная LLM пишет промты, MiniMax H3 двигает фрагменты
Чтобы не сочинять длинные описания вручную, автор запускает в LM Studio локальную мультимодальную модель Qwen 3.8 27B в кванте Q5_K_XL (сжатой версии, которая помещается в видеопамять). Ей передают три вещи: базовое описание желаемого движения, сам фрагмент картины и список ограничений (одежда, внешность, положение соседей, фиксированная камера). Модель смотрит на изображение и выдаёт подробный английский промт. Например: восемь солдат в тёмных мундирах идут слева направо по снежному берегу и несут брёвна, камера статичная, средний план на 35 мм, фактура холста.
Видео генерируется в ComfyUI на видеомодели MiniMax H3. Для ускорения автор использует LoRA на 10 шагов (небольшую надстройку, позволяющую считать быстрее), SageAttention и ноду Spectrum. Ближний план делался в разрешении 1,8 мегапикселя (1824×1024), остальные планы — в 0,3 мегапикселя (736×416).
Результат оценивается не по принципу «красиво или нет», а по пригодности для монтажа:
- сохранилась ли исходная поза;
- не изменилось ли число объектов и конечностей;
- не проходит ли рука или нога одного героя сквозь другого;
- соответствует ли движение физике среды.
Именно по этим критериям набегают те самые 4–5 неудачных попыток на одну удачную. Сцену с офицерами и брёвнами пришлось пересобирать больше 15 раз: офицер проходил сквозь солдата, чинящего мост. Люди в ледяной воде по пояс, которые толкают брёвна и держатся друг за друга, получаются хуже, чем фигуры на берегу.
Сборка в After Effects и цена эксперимента
В After Effects слои и сгенерированные клипы расставляются по исходным координатам. Для отделения фигур от фона используется Roto Brush: автор проверяет стабильность маски, правит границы и отдельно смотрит на одежду, руки и ноги, где ошибки заметнее всего. В конце он сводит цвет и свет, чтобы фрагменты не выбивались из общей живописи.
Работа шла на станции с Intel Core i9-14900K и NVIDIA GeForce RTX 5090 на 32 ГБ видеопамяти, полностью локально. Автор подчёркивает, что эта видеокарта не обязательна: этапы можно выполнять на более слабом железе, брать облегчённые версии моделей или выносить генерацию в облако. Тогда изменятся разрешение, скорость и набор доступных моделей.
Что из этого следует практику
Статья описывает опыт одного автора, а не воспроизводимый бенчмарк, и это её главное ограничение. Но вывод применим шире. Чем сложнее сцена, тем выгоднее дробить её на независимые куски и вставлять человека в проверку каждого шага. Длина итогового ролика плохо отражает трудоёмкость: несколько секунд анимации могут стоить десятков генераций и ручной доработки. Если считать то же в облаке, это будут токены или кредиты, и бюджет стоит закладывать с запасом в 4–5 попыток на каждый фрагмент. Для музейных инсталляций, выставок и образовательных проектов такой конвейер даёт то, чего не даёт один запрос к видеомодели: сохранённую композицию оригинала.
- 22 нояб. 2026 г.Хобби-проект LangChain за четыре года стал стартапом за $3 млрд и привлёк $300 млн
- 22 нояб. 2026 г.Cursor может отказаться от китайских моделей, на которых построен Composer 2
- 22 нояб. 2026 г.Signal ограничил скриншоты на Android и iOS: ИИ-агенты ОС могут читать экран чатов
- 21 нояб. 2026 г.GigaChat — 7-й в мире в слепом рейтинге на русском, но на 78 баллов Elo позади лидера
Вопросы и ответы по материалу
Что известно по теме: сначала слои, потом движение?
Первый этап проходит в Photoshop. Автор выделяет персонажей и объекты, переносит каждый на отдельный слой и группирует слои по смыслу: вода, люди, конструкции. Главное правило: фрагменты сохраняются в исходной системе координат холста, то есть без обрезки до минимального прямоугольника. Тогда в After Effects слои ложатся друг на друга без ручной подгонки масштаба и позиции. Дальше возникает проблема дыр. Если вынуть солдата, за ним должны оказаться доски, плечо другого человека, снег.
Что известно по теме: локальная LLM пишет промты, MiniMax H3 двигает фрагменты?
Чтобы не сочинять длинные описания вручную, автор запускает в LM Studio локальную мультимодальную модель Qwen 3.8 27B в кванте Q5_K_XL (сжатой версии, которая помещается в видеопамять). Ей передают три вещи: базовое описание желаемого движения, сам фрагмент картины и список ограничений (одежда, внешность, положение соседей, фиксированная камера). Модель смотрит на изображение и выдаёт подробный английский промт.
Что известно по теме: сборка в After Effects и цена эксперимента?
В After Effects слои и сгенерированные клипы расставляются по исходным координатам. Для отделения фигур от фона используется Roto Brush: автор проверяет стабильность маски, правит границы и отдельно смотрит на одежду, руки и ноги, где ошибки заметнее всего. В конце он сводит цвет и свет, чтобы фрагменты не выбивались из общей живописи. Работа шла на станции с Intel Core i9-14900K и NVIDIA GeForce RTX 5090 на 32 ГБ видеопамяти, полностью локально.
Протестируйте новые LLM и мультимодальные модели в одном окне
Платформа Nomad AI (nomadnet.ai) даёт прямой доступ к Claude Opus 5.5, GPT-6, Gemini 3.1, DeepSeek и автономным агентам без VPN, зарубежных карт и зоопарка подписок.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.