MarkTechPost
Fonte de notícias de IA. Os artigos são selecionados e adaptados pela redação do Hamidun News.
Últimas publicações
Ferramenta para a API do Claude: o framework SuperClaude
O SuperClaude Framework oferece aos desenvolvedores componentes integrados para criar workflows de IA avançados: comandos, agentes, modos de trabalho e memória de sessão em um só sistema.
Memória para agentes de IA: o sistema local da Tencent
A Tencent abriu o código do TencentDB Agent Memory, sistema de memória local para agentes de IA que reduz o uso de tokens em 61% e aumenta a precisão em 28%.
Como a nova rede neural da NVIDIA economiza memória: Gated DeltaNet-2
A NVIDIA criou o Gated DeltaNet-2, um mecanismo de atenção linear que melhora o gerenciamento de memória em grandes modelos de linguagem com portas separadas de apagamento e escrita, em vez de uma só.
Perplexity abre o código do Bumblebee, scanner com IA para proteger o código de desenvolvedores
A Perplexity publicou o código-fonte do Bumblebee, ferramenta que procura vulnerabilidades em dependências de sistemas de desenvolvimento sem executar código.
Gemini 3.5 para programação: novo modelo é mais barato e mais rápido
No I/O 2026, o Google apresentou o Gemini 3.5 Flash, modelo 75% mais barato que a versão principal, 4 vezes mais rápido e mais eficiente com código e automação.
Alibaba lança rede neural para tradução simultânea de vídeo
A Alibaba apresentou um modelo que traduz vídeo e fala em tempo real em 60 idiomas, com atraso mínimo e preservando a voz de quem fala.
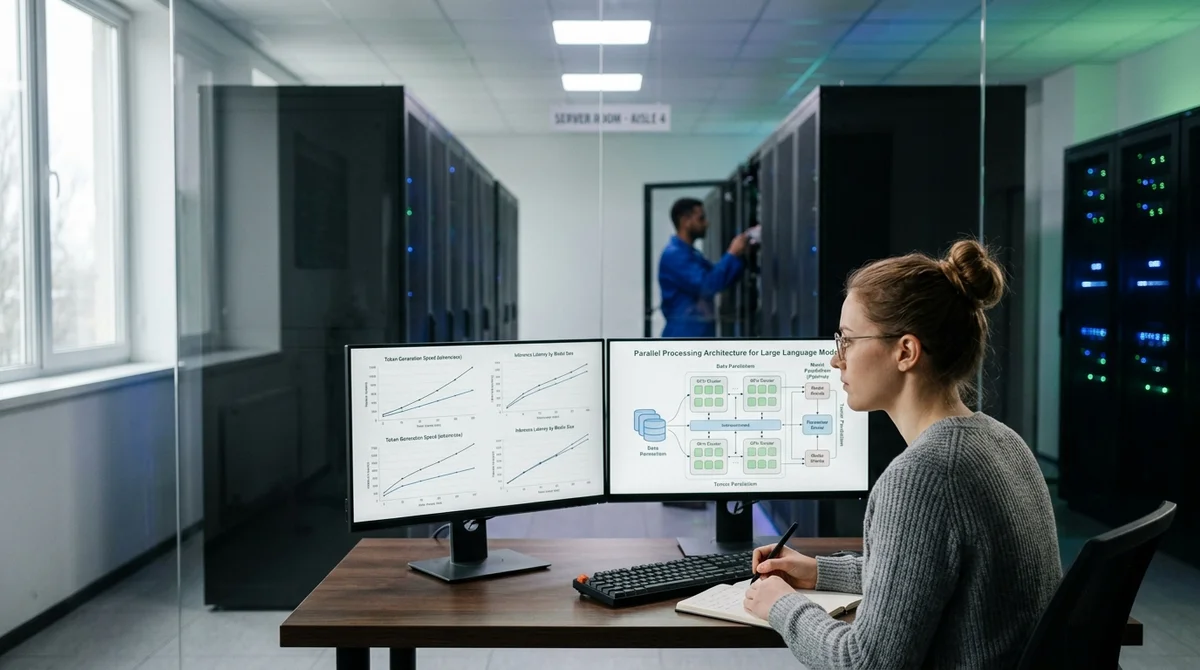
Nemotron, da NVIDIA, é modelo de texto com três modos de geração
A NVIDIA lançou o Nemotron-Labs-Diffusion, modelo de linguagem que combina três modos de decodificação e processa tokens 6 vezes mais rápido que o Qwen3-8B.
Grafos de conhecimento para análise de texto: como a IA extrai informações
Tutorial sobre extração automática de entidades e relações de textos com kg-gen, criação de grafos de conhecimento interativos e análise com NetworkX.
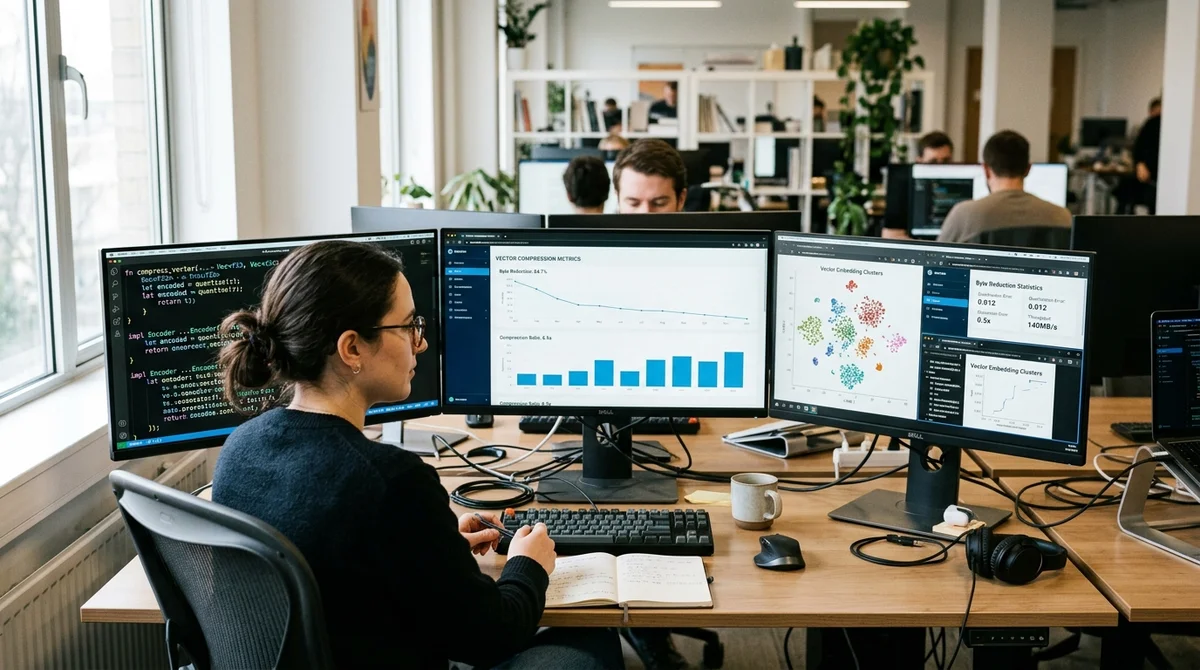
Turbovec: índice vetorial em Rust com o algoritmo TurboQuant, do Google Research
O Turbovec usa o algoritmo TurboQuant, do Google, para comprimir vetores em 16 vezes sem treinamento prévio, simplificando a implantação de aplicações RAG.
Melhores plataformas de IA agêntica em 2026: ranking de Salesforce, Microsoft e outras
Empresas saem dos pilotos e vão para produção. A MarkTechPost listou as 10 melhores plataformas de IA agêntica, com preços verificados e dados de implantações reais.
NVIDIA cria método para treinar redes neurais com precisão de 4 bits
A NVIDIA apresentou o NVFP4, metodologia para treinar modelos grandes com precisão de 4 bits em vez dos 8 bits padrão, reduzindo a memória pela metade sem perda de qualidade.
OpenAI apresenta MRC, protocolo de rede para supercomputadores com milhões de GPUs
A OpenAI criou o MRC, novo protocolo de rede aberto para grandes clusters de IA. Ele distribui os dados por centenas de caminhos e se recupera de falhas em microssegundos, permitindo supercomputadores com mais de 100 mil
Meta AI apresenta o NeuralBench, framework para testar modelos de atividade cerebral
A Meta lançou o NeuralBench, framework aberto para testes padronizados de modelos de IA baseados em EEG, reunindo 36 tarefas, 94 datasets e 13,603 horas de registros cerebrais em uma só interface.
Como reduzir um modelo de linguagem em 3 vezes: guia de FP8, GPTQ e SmoothQuant
Um guia passo a passo mostra como comprimir grandes modelos de linguagem com o llmcompressor e compara a quantização FP8, GPTQ e SmoothQuant para reduzir a carga no hardware.
OpenAI lança três modelos de áudio: tradução, transcrição e raciocínio em tempo real
A OpenAI ampliou a Realtime API com três modelos de áudio: agentes de raciocínio, tradução multilíngue e transcrição em streaming.
Anthropic cria ferramenta que traduz os 'pensamentos' do Claude para linguagem humana
A Anthropic desenvolveu os Natural Language Autoencoders, técnica que converte as ativações internas do Claude em explicações em texto e revela como a rede neural funciona.
NVIDIA Star Elastic: economia de 360× no treinamento de redes neurais
A NVIDIA apresentou o Star Elastic, método que reúne três modelos de tamanhos diferentes em um único checkpoint e treina 360 vezes mais eficientemente.

NVIDIA lança cuda-oxide, compilador de Rust para GPU
A NVIDIA abriu o cuda-oxide, ferramenta que compila funções em Rust diretamente para código de GPU PTX. Ela deve simplificar o desenvolvimento de aplicações CUDA em Rust e tornar a computação paralela mais acessível.
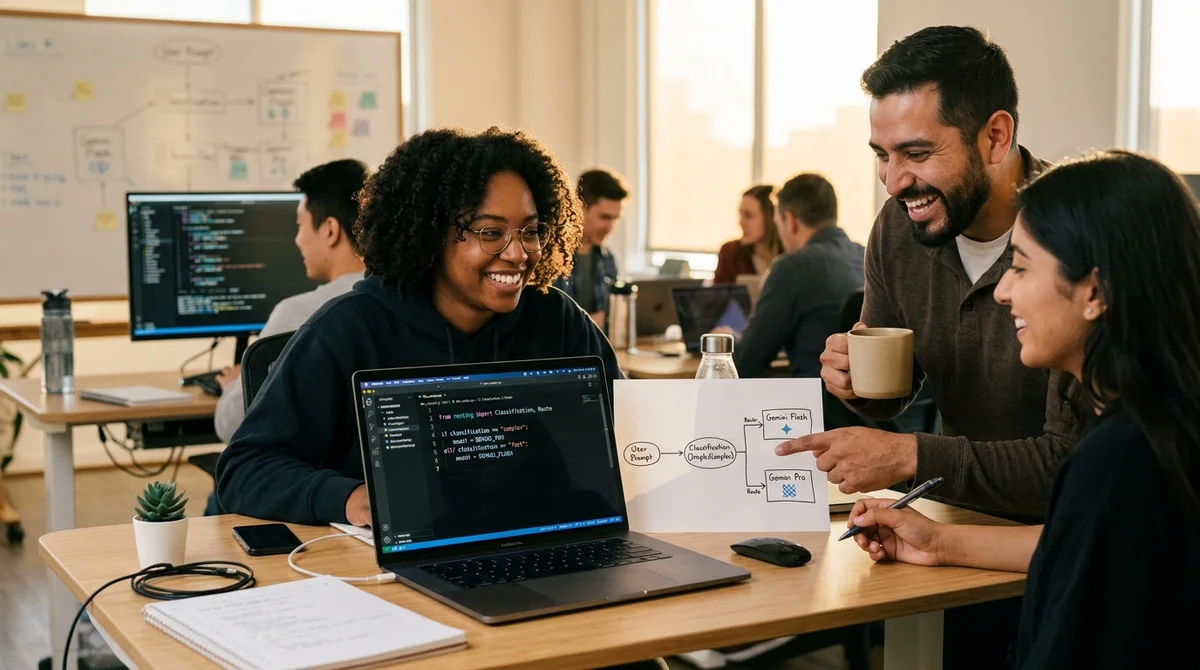
NadirClaw: economia em IA com roteamento de requisições
O NadirClaw é uma ferramenta de roteamento inteligente de prompts que classifica requisições em simples e complexas e as envia ao modelo adequado para reduzir custos.
Hermes, agente de IA aberto, lidera o consumo de tokens no OpenRouter
O agente de IA aberto Hermes, da Nous Research, ultrapassou a plataforma fechada OpenClaw e assumiu o primeiro lugar no OpenRouter, com 224 bilhões de tokens por dia.
Redes neurais para busca em 2026: como escolher entre nove sistemas
Nove bancos de dados vetoriais líderes são hoje infraestrutura essencial para RAG e IA agêntica. Uma análise de arquitetura, preço e escalabilidade ajuda a escolher conforme a tarefa.
IA para programar: a linguagem Zero, da Vercel
A Vercel lançou o Zero, uma linguagem de programação cujo compilador devolve JSON em vez de texto, para que agentes de IA escrevam, corrijam e implantem programas nativos sozinhos.
Como o Memori cria memória persistente para agentes e LLMs multissessão
O Memori é uma infraestrutura de memória para aplicações com LLM que permite aos agentes manter o contexto entre sessões e atender vários usuários ao mesmo tempo.
SHAP para machine learning: comparação de explainers e guia prático
Novo guia mostra como escolher entre quatro métodos SHAP para interpretar modelos, do rápido Tree ao versátil Kernel.
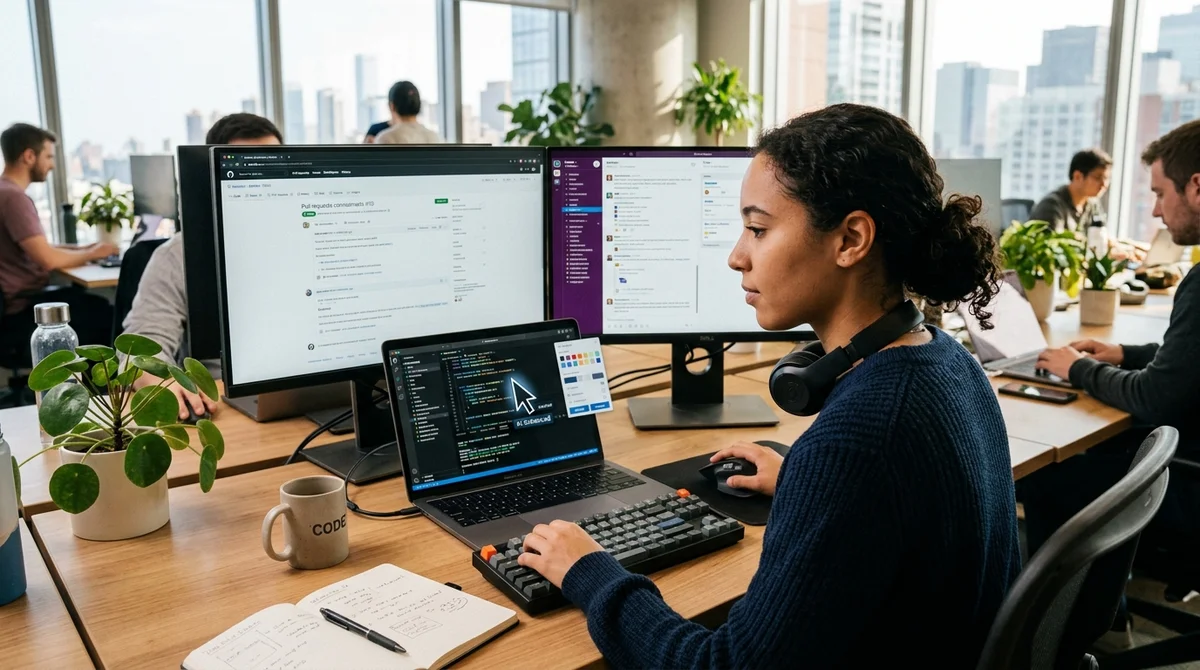
DeepMind cria mouse com IA baseado no Gemini para que usuários não precisem trocar para chats
O Google DeepMind apresentou um mouse com IA baseado no Gemini que analisa o contexto ao redor do cursor e aceita comandos de voz sem abrir uma janela separada.
Mira Murati apresenta o primeiro sistema de diálogo natural com IA em tempo real
A Thinking Machines Lab apresentou o TML-Interaction-Small, modelo que ouve e responde ao mesmo tempo, processando fala, vídeo e texto sem atrasos. É a primeira IA capaz de conversar como uma pessoa.
Nous Research apresenta Lighthouse Attention para acelerar o treinamento de LLMs
A Nous Research publicou o Lighthouse Attention, novo mecanismo de atenção que acelera em 1,4 a 1,7 vez o treinamento de grandes modelos de linguagem com contextos longos.
GLiGuard, da Fastino Labs: modelo de segurança 16 vezes mais rápido que concorrentes bem maiores
A Fastino Labs abriu o GLiGuard, modelo de moderação de 300 milhões de parâmetros que verifica um prompt em quatro frentes em uma única passada e roda 16 vezes mais rápido que equivalentes.
IA invisível em 63% das empresas: ferramentas passaram à frente das políticas corporativas
A maioria das empresas ainda não tem políticas formais de governança de IA, mas os funcionários já adotam ferramentas por conta própria, o que cria sérios riscos de segurança.
Nous Research acelera em 2,5 vezes o pré-treinamento de LLMs sem mudar a arquitetura
A Nous Research desenvolveu o Token Superposition Training, método que reduz em 2,5 vezes o tempo de pré-treinamento de modelos de linguagem sem alterar a arquitetura nem o comportamento na inferência.