ICLR 2026 no Rio: o que pensam os pesquisadores sobre o escalonamento de grandes modelos
A ICLR 2026 reuniu, no fim de abril, pesquisadores de ponta no Rio de Janeiro. Na conferência mais prestigiada do ano, o debate girou em torno de como escalar modelos com mais eficiência (os chips estão ficando mais caros), onde a IA é perigosa e como se proteger, e se haverá espaço para modelos abertos quando as gigantes mantêm fechados seus sistemas mais poderosos. A AIRI esteve lá e compartilha suas primeiras impressões.
Processado por IA de Habr AI; editado por Hamidun News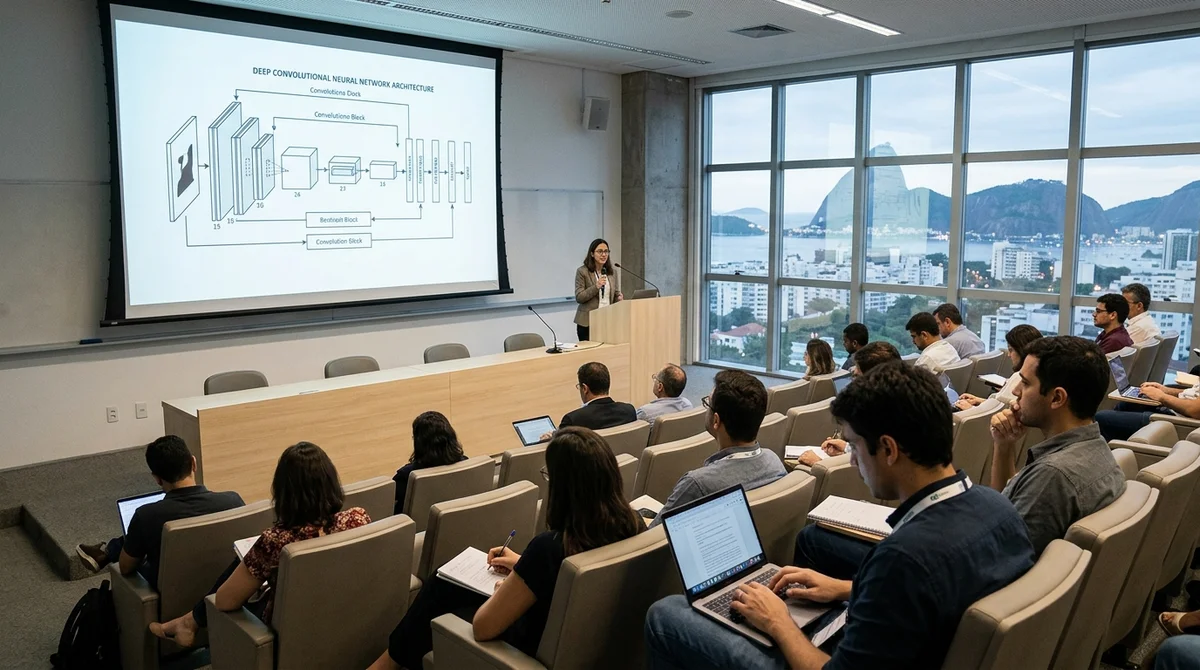
A ICLR 2026 aconteceu no fim de abril, no Rio de Janeiro, e confirmou seu status de principal encontro anual de pesquisadores de IA. Para a comunidade científica, é mais do que uma publicação prestigiada em periódico: é o lugar onde nascem e são testadas ideias que, um ano depois, viram padrão da indústria.
Escalonamento de olho na eficiência
A era do "mais parâmetros = modelo melhor" caminha, devagar mas com segurança, para o fim. Na ICLR, falou-se menos do tamanho dos novos modelos e mais de retorno sobre o investimento: investir 100 milhões para obter uma melhoria de 3% já não faz sentido econômico. Os pesquisadores cansaram de fingir que o escalonamento garante progresso.
Por que isso aconteceu? Os chips estão ficando mais caros, não mais baratos. Dobrar os parâmetros já não dobra o desempenho. As empresas passaram a calcular com honestidade quanto custa treinar um modelo base, mais o fine-tuning para cada tarefa específica.
- Contextos longos (200K+ tokens) viram padrão, e não exotismo
- Engenheiros otimizam a velocidade de inferência e a eficiência energética, não apenas o tamanho dos pesos
- Surgem métodos de escalonamento dinâmico de computação conforme os dados de entrada
- Modelos de mistura de especialistas (MoE) substituem as arquiteturas densas clássicas
Na conferência, notou-se uma mudança de mentalidade: os pesquisadores falam em long-lived foundation models, modelos que vivem muito tempo e melhoram de forma iterativa. Em vez de retreinar do zero o tempo todo, adicionam-se novos dados, adaptadores especializados e novas camadas. É mais barato, mais simples em produção e está virando a nova norma.
Segurança como prioridade
Houve visivelmente mais discussões sobre segurança e garantias do que um ano antes. Na ICLR 2025, o tema era exótico. Em 2026, é mainstream. Os pesquisadores defendem que os grandes modelos precisam ser treinados não só para desempenho, mas também para robustez: resistência a exemplos adversariais, a mudanças de distribuição e a tentativas de manipulação.
"Não podemos mais lançar um modelo e torcer para que ninguém o quebre
em condições reais" — uma posição típica nos painéis da conferência.
Não se trata apenas de regulação (embora os governos estejam criando novas exigências). A própria comunidade científica percebeu que a corrida por resultados SOTA é perigosa se os custos reais dos danos não forem contabilizados.
Pesos abertos à sombra dos sistemas corporativos
A pergunta mais tensa da conferência: o código aberto em IA terá chance se Anthropic, OpenAI e Meta* mantêm fechados seus modelos mais avançados?
Na ICLR, a opinião estava dividida. Uma parte da comunidade científica insiste que os modelos abertos são infraestrutura crítica e devem ser desenvolvidos apesar dos riscos. A outra já é realista: os melhores modelos ficarão com as corporações, que têm recursos para treinar e prestam contas a investidores. A ciência aberta pode ficar em papel de apoio, desenvolvendo metodologia, mas sem ocupar a linha de frente.
O que isso significa
A ICLR 2026 mostrou que a era do escalonamento exponencial está acabando, mas a IA não está desacelerando: está mudando de direção. Vem aí uma era de otimização sistêmica: como usar melhor os recursos, como tornar os modelos mais confiáveis e como fazer a ciência aberta continuar relevante.
Para startups e engenheiros, isso significa que a vantagem competitiva não está mais em treinar um modelo ainda maior, mas em implantar os modelos existentes de forma mais barata, rápida e segura.
*A Meta foi designada organização extremista e é proibida na Rússia.
- 2 de nov. de 2026Assistente Muse, da Meta, mantém dossiê sobre pessoas próximas e recebe root no Ubuntu por padrão
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Kimi marca 96,2% em teste de análise em base 1C e vira reserva caso o Claude seja bloqueado
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
Perguntas frequentes sobre a notícia
O que se sabe sobre Escalonamento de olho na eficiência?
A era do "mais parâmetros = modelo melhor" caminha, devagar mas com segurança, para o fim. Na ICLR, falou-se menos do tamanho dos novos modelos e mais de retorno sobre o investimento: investir 100 milhões para obter uma melhoria de 3% já não faz sentido econômico. Os pesquisadores cansaram de fingir que o escalonamento garante progresso. Por que isso aconteceu? Os chips estão ficando mais caros, não mais baratos. Dobrar os parâmetros já não dobra o desempenho. As empresas passaram a calcular com honestidade quanto custa treinar um modelo base, mais o fine-tuning para cada t
O que se sabe sobre Segurança como prioridade?
Houve visivelmente mais discussões sobre segurança e garantias do que um ano antes. Na ICLR 2025, o tema era exótico. Em 2026, é mainstream. Os pesquisadores defendem que os grandes modelos precisam ser treinados não só para desempenho, mas também para robustez: resistência a exemplos adversariais, a mudanças de distribuição e a tentativas de manipulação. "Não podemos mais lançar um modelo e torcer para que ninguém o quebre em condições reais" — uma posição típica nos painéis da conferência. Não se trata apenas de regulação (embora os governos estejam criando novas exigênci
O que se sabe sobre Pesos abertos à sombra dos sistemas corporativos?
A pergunta mais tensa da conferência: o código aberto em IA terá chance se Anthropic, OpenAI e Meta mantêm fechados seus modelos mais avançados? Na ICLR, a opinião estava dividida. Uma parte da comunidade científica insiste que os modelos abertos são infraestrutura crítica e devem ser desenvolvidos apesar dos riscos. A outra já é realista: os melhores modelos ficarão com as corporações, que têm recursos para treinar e prestam contas a investidores. A ciência aberta pode ficar em papel de apoio, desenvolvendo metodologia, mas sem ocupar a linha de frente.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.