Anthropic cria ferramenta que traduz os 'pensamentos' do Claude para linguagem humana
A Anthropic apresentou os Natural Language Autoencoders, um método que transforma as ativações internas do Claude em explicações em texto. A técnica permite ver em tempo real como o modelo processa informações e toma decisões, transformando a caixa-preta da rede neural em um mecanismo transparente. Em vez de tentar adivinhar a partir da resposta final, os pesquisadores podem observar o que o modelo "pensa" internamente.
Processado por IA de MarkTechPost; editado por Hamidun News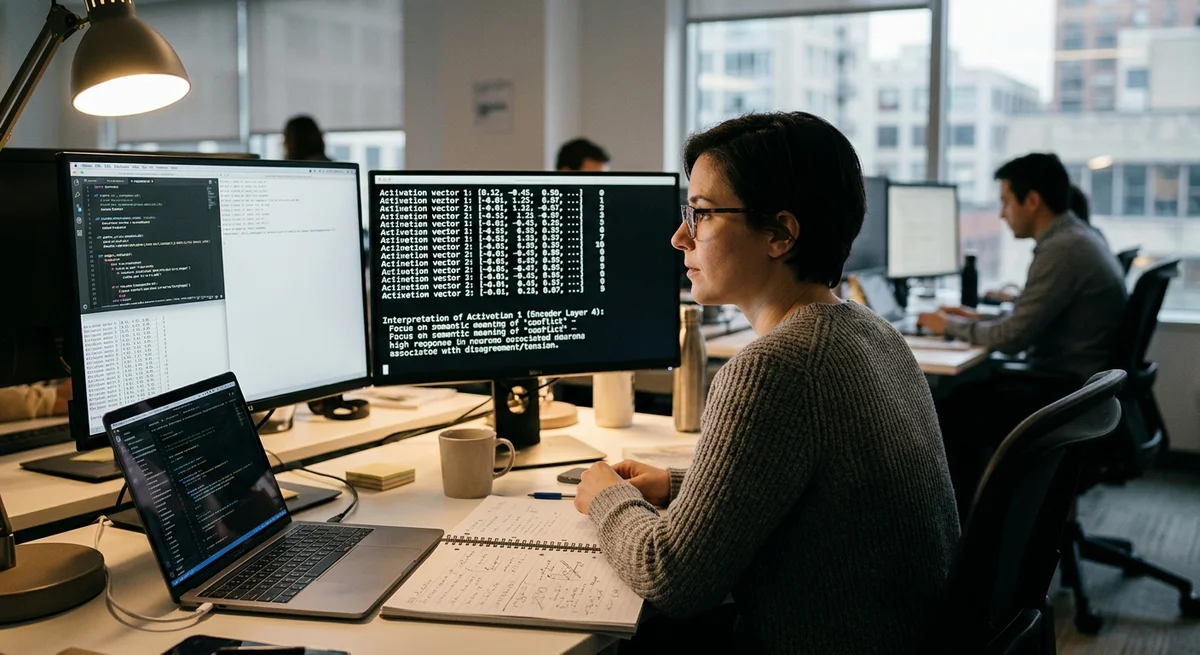
A Anthropic desenvolveu os Natural Language Autoencoders, uma nova técnica que traduz as ativações internas da rede neural Claude em explicações em texto. Isso significa que agora é possível ver o que o modelo "pensa" por dentro, em vez de tentar adivinhar a partir da resposta final.
O que são os Natural Language Autoencoders?
Quando você envia uma mensagem ao Claude, ela passa por uma cadeia de transformações ocultas. O texto é codificado em vetores longos de números, chamados de ativações. É nesse nível que o modelo analisa o significado, conecta informações e toma decisões.
O problema é que, para uma pessoa, esses vetores são apenas números. A Anthropic criou uma ferramenta que pega essas representações numéricas e as converte de volta em linguagem natural: explicações compreensíveis do que aconteceu em cada etapa do processamento.
Como funciona?
Os Natural Language Autoencoders trabalham em duas etapas. Primeiro, um codificador comprime as ativações do modelo em uma representação compacta. Depois, um decodificador desdobra essa representação em texto.
A ideia central é que explicações em texto são muito mais informativas para análise do que tentar interpretar os vetores brutos. Em vez de montes de números, você recebe frases como "o modelo percebeu que esta é uma pergunta de matemática" ou "aqui é preciso verificar o contexto da mensagem anterior".
Por que isso importa?
A interpretabilidade dos modelos é um dos principais problemas da IA. Até agora, as redes neurais permaneceram, em sua maioria, como caixas-pretas. Com essa ferramenta, a Anthropic avança em direção à transparência:
- Depuração: dá para ver em que etapa o modelo começou a errar
- Segurança: fica mais fácil identificar comportamentos indesejados no nível das ativações
- Treinamento: os pesquisadores entendem melhor a lógica interna do modelo
- Confiança: a transparência reforça a confiança dos usuários na IA
O que isso significa?
Os Natural Language Autoencoders não são apenas um projeto de pesquisa. São um primeiro passo prático para que os grandes modelos de linguagem deixem de ser caixas-pretas. Quanto melhor entendemos como as redes neurais pensam, melhor podemos controlá-las e aprimorá-las. Para os desenvolvedores, isso abre novas possibilidades de diagnóstico e otimização.
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Kimi marca 96,2% em teste de análise em base 1C e vira reserva caso o Claude seja bloqueado
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Google admite que o AI Mode reduz a receita da Busca; ações caem 15%
Perguntas frequentes sobre a notícia
O que são os Natural Language Autoencoders?
Quando você envia uma mensagem ao Claude, ela passa por uma cadeia de transformações ocultas. O texto é codificado em vetores longos de números, chamados de ativações. É nesse nível que o modelo analisa o significado, conecta informações e toma decisões. O problema é que, para uma pessoa, esses vetores são apenas números. A Anthropic criou uma ferramenta que pega essas representações numéricas e as converte de volta em linguagem natural: explicações compreensíveis do que aconteceu em cada etapa do processamento.
Como funciona?
Os Natural Language Autoencoders trabalham em duas etapas. Primeiro, um codificador comprime as ativações do modelo em uma representação compacta. Depois, um decodificador desdobra essa representação em texto. A ideia central é que explicações em texto são muito mais informativas para análise do que tentar interpretar os vetores brutos. Em vez de montes de números, você recebe frases como "o modelo percebeu que esta é uma pergunta de matemática" ou "aqui é preciso verificar o contexto da mensagem anterior".
Por que isso importa?
A interpretabilidade dos modelos é um dos principais problemas da IA. Até agora, as redes neurais permaneceram, em sua maioria, como caixas-pretas. Com essa ferramenta, a Anthropic avança em direção à transparência: Depuração: dá para ver em que etapa o modelo começou a errar Segurança: fica mais fácil identificar comportamentos indesejados no nível das ativações Treinamento: os pesquisadores entendem melhor a lógica interna do modelo Confiança: a transparência reforça a confiança dos usuários na IA
O que isso significa?
Os Natural Language Autoencoders não são apenas um projeto de pesquisa. São um primeiro passo prático para que os grandes modelos de linguagem deixem de ser caixas-pretas. Quanto melhor entendemos como as redes neurais pensam, melhor podemos controlá-las e aprimorá-las. Para os desenvolvedores, isso abre novas possibilidades de diagnóstico e otimização.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.