Vários LLMs em um mesmo chat do Telegram: como combinar Groq e Google AI
Um desenvolvedor criou um bot de Telegram em que vários LLMs trabalham ao mesmo tempo no mesmo chat, cada um fingindo ser funcionário de uma corporação. O usuário pode alternar entre eles sob demanda. A integração usa APIs gratuitas: Groq (Llama) e Google AI Studio (Gemma e Gemini).
Processado por IA de Habr AI; editado por Hamidun News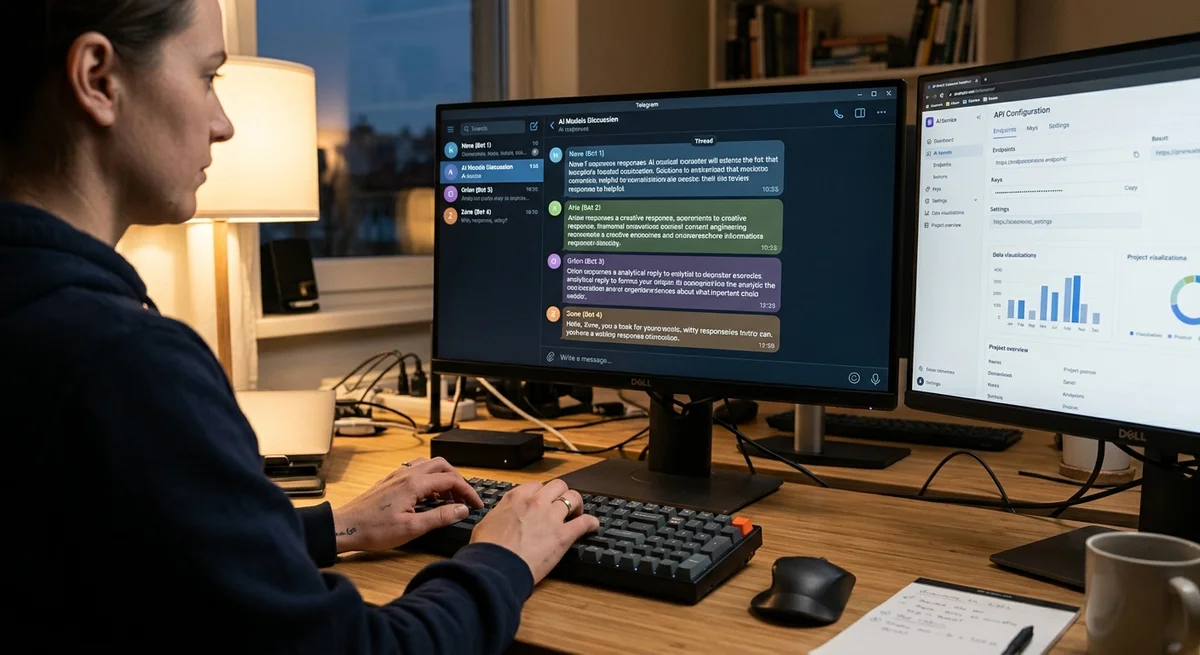
Um desenvolvedor do Habr criou um bot de Telegram divertido em que vários LLMs trabalham simultaneamente em um único chat e cada um finge ser funcionário de uma corporação. A ideia surgiu como piada para um encontro com amigos, mas logo virou um caso técnico interessante sobre integração de vários modelos usando apenas APIs gratuitas.
Como enfiar modelos diferentes em um só chat
A ideia original era simples e divertida: criar um chat em que várias redes neurais "trabalham" ao mesmo tempo, achando que são funcionários reais de uma corporação. Cada modelo recebe seu próprio papel e sua própria história, e o usuário pode alternar entre eles a qualquer momento, fazendo a mesma pergunta a LLMs diferentes. Não é apenas um teste em paralelo: é uma tentativa de fazer as redes aprenderem e manterem suas personas dentro de um único diálogo.
Onde conseguir API sem gastar
A primeira tarefa prática era banal, mas crítica: encontrar um conjunto de ferramentas com limites gratuitos razoáveis. O desenvolvedor pesquisou e ficou com três opções principais:
- Groq — para Llama, com velocidade de inferência recorde
- Google AI Studio — para Gemma e Gemini, com planos gratuitos decentes
- Requisições HTTP simples para conectar os componentes
Na etapa inicial, o código ficou relativamente simples: escolher o modelo pelo comando do usuário, redirecionar a requisição para a API certa e inserir a resposta no contexto comum do chat. A lógica era mínima; a dificuldade estava em gerenciar ao mesmo tempo o estado e o contexto de cada modelo.
Quando o modelo esquece quem é
Logo apareceu um problema curioso, mas teimoso: ao alternar entre modelos, um deles não queria passar a vez e simplesmente fingia ser outro, perdendo totalmente a própria identidade. O desenvolvedor resolveu a maior parte do problema com um prompt de sistema bem elaborado, que "lembra" explicitamente a cada modelo quem ele deve ser naquele diálogo.
Mesmo assim, não foi possível eliminar o bug por completo. Os modelos ainda se confundem às vezes com seus papéis, principalmente em diálogos longos com muitas interações. Segundo o desenvolvedor, trata-se de uma limitação fundamental dos próprios LLMs: eles geram texto bem e copiam estilo, mas frequentemente perdem o contexto de identidade quando o foco de atenção muda.
O que isso significa
O caso mostra que é possível montar uma interface multimodelo até com APIs gratuitas, desde que se trabalhe bem a arquitetura e o prompting. Confiabilidade total no gerenciamento de contexto e identidade ainda não é alcançável, mas para experimentos, prototipagem e aprendizado é mais do que suficiente.
- 1 de nov. de 2026Teste com 16 modelos em 7 buscadores: Exa fez em média 10,5 pontos de 14; SearXNG, cerca de 3
- 1 de nov. de 2026Agente de vídeo StreamVibe, do Google, supera outros modelos em 10,7% em timing e qualidade das respostas
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Bots de voz com LLM usam o classificador rápido Jev: decisão em 200–500 ms
Perguntas frequentes sobre a notícia
Como enfiar modelos diferentes em um só chat?
A ideia original era simples e divertida: criar um chat em que várias redes neurais "trabalham" ao mesmo tempo, achando que são funcionários reais de uma corporação. Cada modelo recebe seu próprio papel e sua própria história, e o usuário pode alternar entre eles a qualquer momento, fazendo a mesma pergunta a LLMs diferentes. Não é apenas um teste em paralelo: é uma tentativa de fazer as redes aprenderem e manterem suas personas dentro de um único diálogo.
Onde conseguir API sem gastar?
A primeira tarefa prática era banal, mas crítica: encontrar um conjunto de ferramentas com limites gratuitos razoáveis. O desenvolvedor pesquisou e ficou com três opções principais: Groq — para Llama, com velocidade de inferência recorde Google AI Studio — para Gemma e Gemini, com planos gratuitos decentes Requisições HTTP simples para conectar os componentes Na etapa inicial, o código ficou relativamente simples: escolher o modelo pelo comando do usuário, redirecionar a requisição para a API certa e inserir a resposta no contexto comum do chat. A lógica era mínima; a dific
Quando o modelo esquece quem é?
Logo apareceu um problema curioso, mas teimoso: ao alternar entre modelos, um deles não queria passar a vez e simplesmente fingia ser outro, perdendo totalmente a própria identidade. O desenvolvedor resolveu a maior parte do problema com um prompt de sistema bem elaborado, que "lembra" explicitamente a cada modelo quem ele deve ser naquele diálogo. Mesmo assim, não foi possível eliminar o bug por completo. Os modelos ainda se confundem às vezes com seus papéis, principalmente em diálogos longos com muitas interações. Segundo o desenvolvedor, trata-se de uma limitação fundam
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.