Target Encoding sem vazamento de dados: LOO e K-Fold contra a ilusão de qualidade
Target encoding parece uma forma simples de tratar features categóricas — mas uma implementação ingênua vaza silenciosamente o target para o conjunto de treino. As métricas na validação parecem ótimas, mas o modelo não funciona em produção. O artigo explica onde exatamente o leakage surge e mostra implementações corretas com Leave-One-Out e K-Fold — para obter um resultado honesto, e não números bonitos no dashboard.
Processado por IA de Habr AI; editado por Hamidun News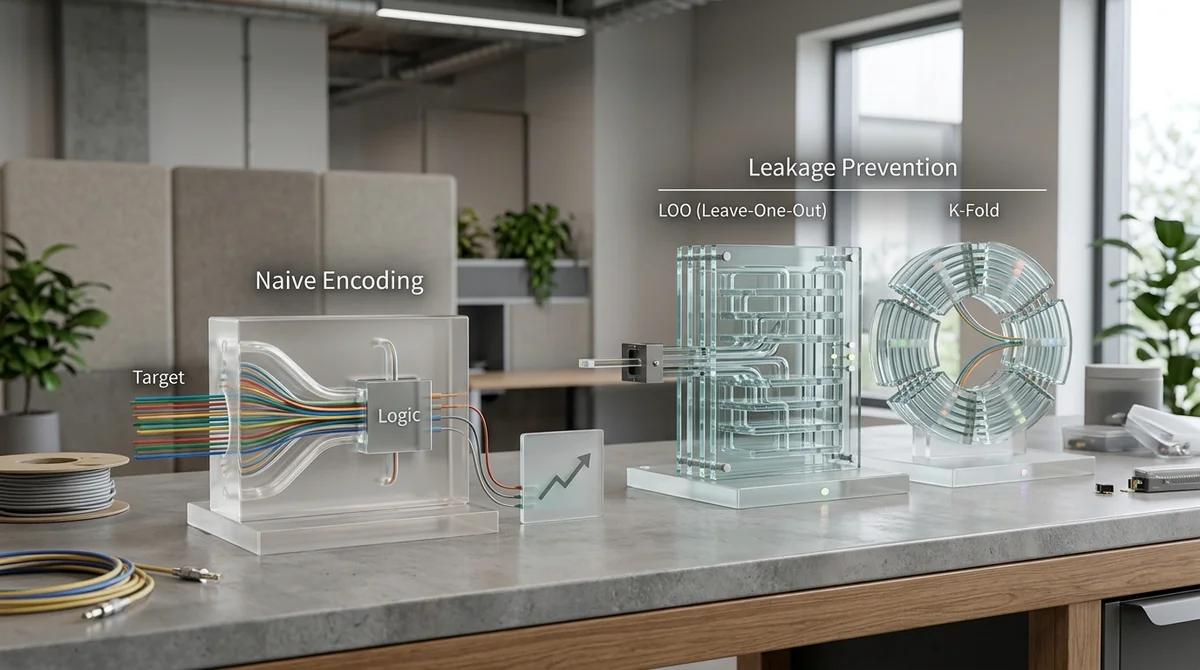
Target encoding é um método popular para codificar features categóricas, mas sua implementação ingênua sistematicamente inflaciona métricas e cria a ilusão de um modelo bom que desaba em produção.
O que é target encoding
Target encoding substitui cada valor único de uma feature categórica pelo valor médio da variável alvo em todos os objetos dessa categoria. Para a feature "cidade", cada cidade recebe a venda média em todos os clientes dela. Para a feature "navegador" — a conversão média em todas as sessões com esse navegador. Uma coluna numérica em vez de centenas de binárias.
O método é especialmente atrativo com alta cardinalidade: em vez de centenas de colunas binárias do One-Hot Encoding, fica uma única feature numérica compacta que carrega diretamente informação sobre a relação categoria-alvo. É por isso que target encoding é usado ativamente em competições do Kaggle e em pipelines ML industriais — o modelo recebe uma entrada informativa que treina rápido e é fácil de interpretar.
De onde vem o vazamento
O problema surge no momento de calcular a média. Uma implementação ingênua computa o encoding em toda a amostra de treino — incluindo o objeto atual. Como resultado, o alvo desse objeto participa do cálculo da feature que depois é passada ao modelo como entrada durante o treinamento. O modelo efetivamente vê a variável alvo de forma oculta — não diretamente, mas através dessa feature.
As consequências de tal vazamento são previsíveis:
- Métricas no treino e validação cruzada parecem excelentes — o modelo "sabe" a resposta através da feature
- O modelo memoriza ruído e outliers de objetos específicos, não padrões reais
- No teste ou em produção, a qualidade cai drasticamente — lá o encoding é calculado do treino sem o objeto atual
- Quanto menor o número de objetos na categoria — mais forte o vazamento: com um objeto, o encoding simplesmente iguala o alvo
- O efeito é invisível sob verificações de métricas padrão, mas se manifesta em testes A/B em produção
Essa é uma armadilha clássica: tudo parece perfeito até o deploy, após o qual o modelo acaba sendo inútil. Muitas soluções competitivas do Kaggle mostraram CV brilhante exatamente por essa razão, mas não sobreviveram à verificação final.
LOO e K-Fold: como calcular corretamente
Ambas as abordagens resolvem uma tarefa: ao calcular o encoding, não usar o valor alvo do objeto.
Leave-One-Out (LOO) ao codificar cada objeto exclui seu valor do cálculo da média. Formalmente: a média do alvo em todos os objetos da mesma categoria, exceto o atual. A dependência direta é quebrada, informação sobre a distribuição da categoria é preservada. A implementação é simples e determinística.
Encoding K-Fold funciona diferentemente. A amostra de treino é dividida em K folds. Para cada fold, o encoding é computado apenas dos K-1 folds restantes, depois aplicado ao fold "retido". O esquema é análogo à validação cruzada: nenhum objeto participa do cálculo do seu próprio encoding.
"Uma feature honesta é aquela calculada durante o treinamento
exatamente como será calculada em produção."
Cada método tem suas nuances: LOO é determinístico e adiciona ruído mínimo, mas com categorias pequenas (1-2 objetos) permanece vulnerável a vazamento residual. K-Fold introduz ruído de regularização por causa da divisão aleatória — isso é uma característica útil, não um bug. Para ambos os métodos, uma regra é importante: o encoding para a amostra de teste é sempre calculado de toda a amostra de treino como um todo, sem LOO ou K-Fold — é exatamente assim que funcionará em produção.
O que isso significa
Target encoding permanece uma ferramenta poderosa para trabalhar com features categóricas, mas requer implementação cuidadosa. A abordagem ingênua cria uma ilusão de qualidade — métricas bonitas que não sobrevivem à produção. LOO e K-Fold fornecem features honestas: números de validação refletem a verdadeira capacidade de generalização do modelo, não um artefato de vazamento de dados. Se as métricas parecem boas demais — o encoding deve ser verificado em primeiro lugar.
Perguntas frequentes sobre a notícia
O que é target encoding?
Target encoding substitui cada valor único de uma feature categórica pelo valor médio da variável alvo em todos os objetos dessa categoria. Para a feature "cidade", cada cidade recebe a venda média em todos os clientes dela. Para a feature "navegador" — a conversão média em todas as sessões com esse navegador. Uma coluna numérica em vez de centenas de binárias. O método é especialmente atrativo com alta cardinalidade: em vez de centenas de colunas binárias do One-Hot Encoding, fica uma única feature numérica compacta que carrega diretamente informação sobre a relação catego
O que se sabe sobre De onde vem o vazamento?
O problema surge no momento de calcular a média. Uma implementação ingênua computa o encoding em toda a amostra de treino — incluindo o objeto atual. Como resultado, o alvo desse objeto participa do cálculo da feature que depois é passada ao modelo como entrada durante o treinamento. O modelo efetivamente vê a variável alvo de forma oculta — não diretamente, mas através dessa feature. As consequências de tal vazamento são previsíveis: Métricas no treino e validação cruzada parecem excelentes — o modelo "sabe" a resposta através da feature O modelo memoriza ruído e outliers
O que se sabe sobre LOO e K-Fold: como calcular corretamente?
Ambas as abordagens resolvem uma tarefa: ao calcular o encoding, não usar o valor alvo do objeto. Leave-One-Out (LOO) ao codificar cada objeto exclui seu valor do cálculo da média. Formalmente: a média do alvo em todos os objetos da mesma categoria, exceto o atual. A dependência direta é quebrada, informação sobre a distribuição da categoria é preservada. A implementação é simples e determinística. Encoding K-Fold funciona diferentemente. A amostra de treino é dividida em K folds. Para cada fold, o encoding é computado apenas dos K-1 folds restantes, depois aplicado ao fold
Build & Ship Production AI Apps with Vibe Coding
Join Zhemal Khamidun's hands-on Vibe Coding Intensive at hamidun.com/vibecoding — master Claude Code, Cursor, and autonomous agentic workflows.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.