Habr AI mostrou como funciona a câmera virtual para Shorts e Reels com face tracking
No Habr AI saiu uma análise detalhada da câmera virtual para Shorts e Reels. Em vez de um autocrop simples, o autor montou um production pipeline com cascata de detectores, face tracking, filtragem anti-jerk e um modelo físico de movimento de câmera. No fim, o enquadramento vertical se comporta não como um crop instável, mas como um operador com inércia e modo fallback. Também há uma transição suave no estilo Ken Burns se o rosto desaparecer do quadro.
Processado por IA de Habr AI; editado por Hamidun News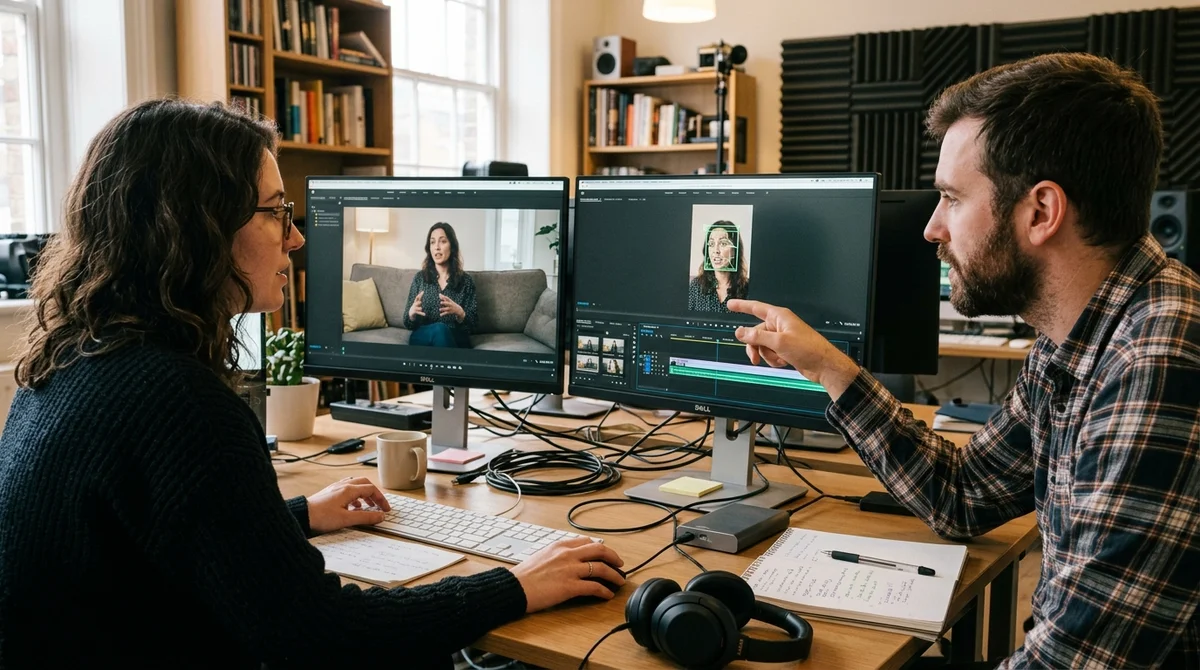
O Habr AI demonstrou como funciona uma câmera virtual para vídeo vertical, convertendo gravação horizontal comum em Shorts ou Reels sem o corte automático nervoso típico dessas conversões. O autor descreve um pipeline de produção onde a câmera rastreia o rosto como um sistema dinâmico separado, em vez de seguir um único bounding box.
Por que o Corte Automático Falha
No papel, a tarefa parece simples: pegue um quadro 16:9, extraia uma janela 9:16 e mantenha a pessoa centralizada. Em vídeo real, essa abordagem falha rapidamente. O rosto pode se deslocar para esquerda ou direita, uma segunda pessoa pode aparecer no quadro e o próprio detector introduzirá ruído, perderá o alvo em rotações de cabeça, reflexos ou gestos. O resultado é um vídeo vertical que parece autofoco antigo: a imagem tremulha nervosamente e constantemente gerencia mal a composição.
O autor propõe ver o problema não como corte automático, mas como uma câmera virtual com sua própria inércia, restrições de velocidade, atraso de reação e lógica de fallback. O sistema não pode simplesmente "seguir o centro da caixa". Ele deve existir no tempo, tolerar dados imprecisos, não entrar em pânico durante breves perdas de rosto e manter movimento significativo mesmo em cenas onde nenhum rosto aparece. Isso é crítico para clipes mais longos.
"Uma câmera não é uma coordenada, mas um sistema dinâmico."
Como o Pipeline Funciona
A solução principal usa uma cadeia de detecção de rosto em três níveis: MediaPipe → YuNet → Haar Cascade. O primeiro detector funciona como o principal, o segundo atua como backup de backend ONNX via OpenCV, e o terceiro permanece como última linha de defesa quando tudo o mais está indisponível ou funciona mal. Juntos produzem um formato de dados unificado: centro do rosto, tamanho, confiança e bounding box. Desta forma, o resto do sistema é independente do detector específico e pode funcionar de forma estável mesmo em modo degradado.
No topo da detecção vem rastreamento simples mas prático: o sistema compara o centro do rosto do quadro anterior com os candidatos atuais e seleciona o objeto mais próximo. Se o rosto desaparecer brevemente, um período de tolerância ativa—a câmera confia na última posição conhecida por um curto tempo para evitar tremidas em um único erro. Depois disso, o sinal é limpo em dois passos adicionais e recebe um fallback separado para cenas sem rostos.
- Anti-tremida remove saltos de coordenadas excessivamente grandes entre quadros
- Filtro passa-baixa suaviza ruído residual e microvibração
- Fallback Ken Burns lida com a cena se o rosto for perdido ou ausente
- Interpolação de caminho converte análise em 8 FPS em movimento suave para saída final em 30 ou 60 FPS
No estágio final, o sistema não apenas armazena estados discretos da câmera—constrói um caminho contínuo. Então para cada quadro, ele pega o centro e zoom, calcula o ROI, extrai a região necessária e a dimensiona para o formato vertical final. Isso mantém o pipeline computacionalmente razoável: a análise pode ser feita em uma cópia reduzida do vídeo, enquanto o corte final funciona com o original, sem perder suavidade de movimento na renderização final.
Como a Câmera se Torna um Operador
A parte mais interessante é o modelo de movimento. Em vez de saltos instantâneos para o ponto alvo, a câmera é descrita como um oscilador amortecido: tem "massa", rigidez, amortecimento, limites de aceleração e velocidade máxima. Este esquema fornece inércia e torna o movimento autêntico. Se uma pessoa começar a se mover mais rápido, você pode adicionar lead preditivo para que a câmera olhe ligeiramente para frente em vez de apenas perseguir o alvo. Paradoxalmente, um leve atraso artificial—lag humano—também melhora o resultado: reações perfeitamente precisas muitas vezes parecem menos naturais do que as levemente atrasadas.
No topo da física, o autor aplica regras composicionais. A câmera pode deslocar o rosto em direção às linhas de terços, elevar o ponto de foco mais próximo ao nível dos olhos, ignorar micro-movimentos dentro de uma zona morta e manter uma margem segura de rosto para evitar cortar orelhas, cabelo e gestos nas bordas do quadro. Para cenas de talking-head, existe um modo single-face dedicado com velocidade mais conservadora e estabilização reforçada, e para vídeos sem rostos—uma transição suave para Ken Burns com panoramização e zoom em vez de um centro "congelado".
O Que Isso Significa
Este detalhamento mostra para onde os ferramentas de edição de vídeo AI estão indo. A qualidade aqui não nasce de um único modelo "mágico", mas de montagem de engenharia: detectores de fallback, rastreamento, filtragem, física de movimento e composição funcionam juntos. Para criadores de conteúdo e equipes que produzem em massa vídeos longos cortados em Shorts e Reels, isso não é mais um corte automático de brinquedo, mas um modelo prático de câmera de produção que pode ser replicado e adaptado para diferentes estilos de gravação.
Perguntas frequentes sobre a notícia
Por que o Corte Automático Falha?
No papel, a tarefa parece simples: pegue um quadro 16:9, extraia uma janela 9:16 e mantenha a pessoa centralizada. Em vídeo real, essa abordagem falha rapidamente. O rosto pode se deslocar para esquerda ou direita, uma segunda pessoa pode aparecer no quadro e o próprio detector introduzirá ruído, perderá o alvo em rotações de cabeça, reflexos ou gestos. O resultado é um vídeo vertical que parece autofoco antigo: a imagem tremulha nervosamente e constantemente gerencia mal a composição. O autor propõe ver o problema não como corte automático, mas como uma câmera virtual com
Como o Pipeline Funciona?
A solução principal usa uma cadeia de detecção de rosto em três níveis: MediaPipe → YuNet → Haar Cascade. O primeiro detector funciona como o principal, o segundo atua como backup de backend ONNX via OpenCV, e o terceiro permanece como última linha de defesa quando tudo o mais está indisponível ou funciona mal. Juntos produzem um formato de dados unificado: centro do rosto, tamanho, confiança e bounding box. Desta forma, o resto do sistema é independente do detector específico e pode funcionar de forma estável mesmo em modo degradado. No topo da detecção vem rastreamento si
Como a Câmera se Torna um Operador?
A parte mais interessante é o modelo de movimento. Em vez de saltos instantâneos para o ponto alvo, a câmera é descrita como um oscilador amortecido: tem "massa", rigidez, amortecimento, limites de aceleração e velocidade máxima. Este esquema fornece inércia e torna o movimento autêntico. Se uma pessoa começar a se mover mais rápido, você pode adicionar lead preditivo para que a câmera olhe ligeiramente para frente em vez de apenas perseguir o alvo. Paradoxalmente, um leve atraso artificial—lag humano—também melhora o resultado: reações perfeitamente precisas muitas vezes p
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.