STM32N6, da STMicroelectronics, faz reconhecimento de fala local, sem nuvem, com 0,2 W
O microcontrolador STM32N6, com NPU integrada, conseguiu reconhecer fala livre diretamente no dispositivo, sem nuvem e com consumo de cerca de 0,215 W. Por enquanto, só o modelo acústico está pronto: ele gera fonemas em tempo real, enquanto o decodificador e o modelo de linguagem ainda estão em desenvolvimento. Mesmo assim, o projeto mostra que interfaces de voz locais para casa inteligente, indústria e eletrônicos vestíveis estão se tornando práticas.
Processado por IA de Habr AI; editado por Hamidun News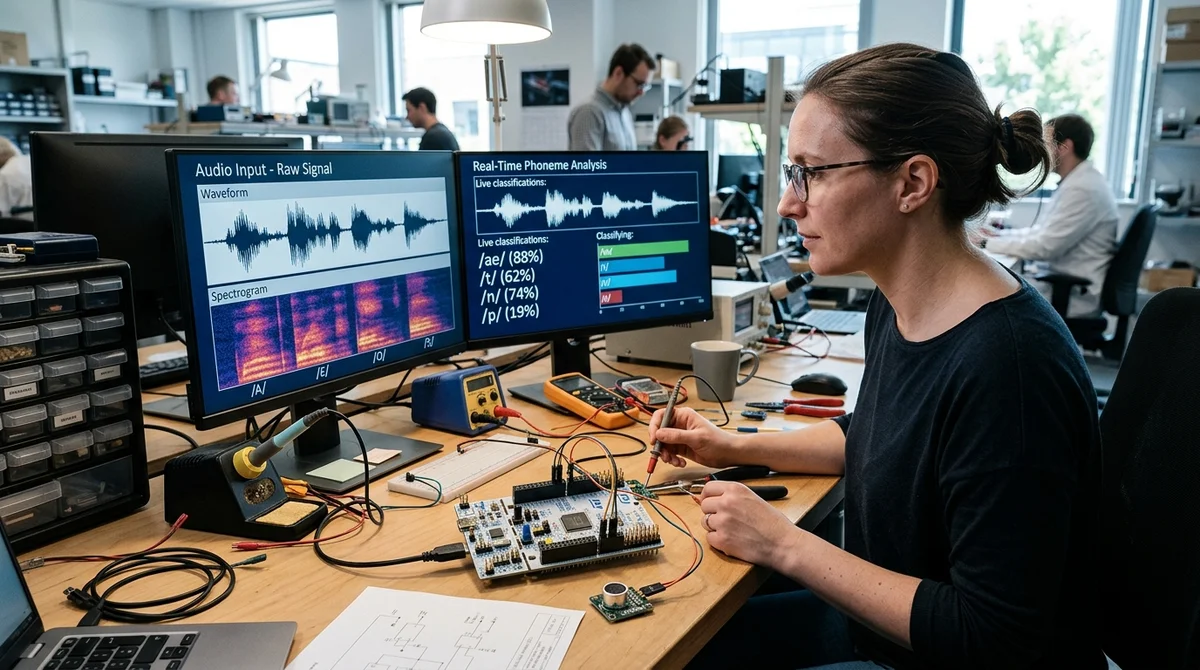
Microcontroladores com NPU integrada começam a avançar sobre um território que antes pertencia quase por completo aos serviços de reconhecimento de fala na nuvem. Um experimento com o STM32N6 mostrou que o reconhecimento local de fala livre já pode rodar direto no dispositivo, sem internet, quase em tempo real e com consumo de cerca de 0,215 W.
Como o sistema funciona
O autor do projeto montou o reconhecimento de fala em três blocos: um modelo acústico, um decodificador e um módulo de rescoring. A parte mais pesada é a acústica: ela recebe o sinal de áudio bruto do microfone e o transforma em uma sequência de fonemas. O decodificador deve montar palavras a partir desses fonemas, e o bloco de rescoring, rechecar o resultado levando o contexto em conta. Nesta etapa, o que já roda no STM32N6 é o modelo acústico, ou seja, a base fundamental de todo o sistema.
Na prática, o dispositivo ouve a fala em tempo real, processa na NPU e emite um fluxo de fonemas. Na demonstração, aparecem palavras e números na parte de cima e, embaixo, os fonemas "brutos" previstos pelo modelo. Por ora, a conversão de fonemas em palavras é feita por correspondência rígida, e não por um decodificador de linguagem completo. Por isso o sistema ainda é limitado, mas o fato de o modelo acústico rodar localmente em um microcontrolador já pesa mais do que a estrutura que existe em volta dele hoje.
Números e limitações
O resultado mais forte é o consumo de energia. Durante o reconhecimento ativo, todo o sistema consome cerca de 215 mW. Desse total, aproximadamente 160 mW vão para a NPU e o núcleo Cortex-M55, outros 45 mW para a memória externa Flash e PSRAM, e cerca de 10 mW para os pinos externos. E este não é um modo otimizado: o núcleo ainda não usa suspensão agressiva e a NPU está carregada em apenas 10,4%, então ainda há margem para reduzir o consumo.
Em qualidade, o quadro também é sério para uma classe de hardware como essa. O modelo tem 8,5 milhões de parâmetros, quase não perdeu precisão após a quantização para int8 e, no dispositivo-alvo, atingiu PER de 5,3% no dev_clean e 14,4% no dev_other. A inferência na NPU levou 52 ms para cada 500 ms de áudio, e a latência total foi de 985 ms. Quase metade desse atraso não vem do hardware, mas da "janela para o futuro" que o modelo usa para prever os fonemas com mais precisão.
- Tamanho do modelo acústico: 8,5 milhões de parâmetros
- Consumo durante o reconhecimento: cerca de 0,215 W
- Tempo de inferência da NPU: 52 ms para 500 ms de áudio
- Perda de qualidade após a quantização para int8: menos de 0,5%
- Uso de RAM: 18%, carga da NPU: 10,4%
A comparação com sistemas maiores merece destaque. Em PER, o modelo ficou comparável ao wav2vec 2.0 Base e ao HuBERT Base, embora esses sejam cerca de 11 vezes maiores e não tenham sido feitos para rodar em microcontroladores. O autor também deixa claros os limites do projeto: ainda não é um substituto para o ditado de texto completo, mas sim um motor local para comandos e frases curtas, em que autonomia e economia de energia são críticas.
Onde o microcontrolador leva vantagem
O ponto forte dessa abordagem não é a universalidade a qualquer custo, mas preencher a lacuna entre o simples keyword spotting e o pesado ASR em nuvem. As interfaces de voz locais comuns esperam uma correspondência exata do comando, enquanto aqui o dispositivo já consegue interpretar diferentes formulações do mesmo pedido. Em vez de uma frase rígida, o usuário pode dizer "esquenta um pouco", "aumenta uns cinco graus" ou "temperatura para cima", e o sistema entenderá uma única ação.
Daí surgem cenários bem práticos: casa inteligente sem enviar a voz para fora, entrada de números e parâmetros por voz na produção, e uso em armazéns, equipamentos médicos e transporte, onde a rede é instável ou simplesmente não existe.
Outra vantagem é a folga para crescer. Hoje o STM32N6 usa apenas 18% da RAM, e a NPU é aproveitada em cerca de um décimo. Os próximos passos são claros: adicionar um decodificador de fonemas, um modelo de linguagem e supressão de ruído. São eles que devem transformar um protótipo técnico convincente em uma interface realmente útil.
O que isso significa
O STM32N6 não elimina o reconhecimento de fala na nuvem, mas mostra que parte das tarefas já pode ser levada com segurança para a borda da rede. Onde importam autonomia, privacidade, preço e baixo consumo, MCUs com NPU começam a parecer não um experimento, mas uma nova classe prática de interfaces de voz.
Perguntas frequentes sobre a notícia
Como o sistema funciona?
O autor do projeto montou o reconhecimento de fala em três blocos: um modelo acústico, um decodificador e um módulo de rescoring. A parte mais pesada é a acústica: ela recebe o sinal de áudio bruto do microfone e o transforma em uma sequência de fonemas. O decodificador deve montar palavras a partir desses fonemas, e o bloco de rescoring, rechecar o resultado levando o contexto em conta. Nesta etapa, o que já roda no STM32N6 é o modelo acústico, ou seja, a base fundamental de todo o sistema. Na prática, o dispositivo ouve a fala em tempo real, processa na NPU e emite um flu
O que se sabe sobre Números e limitações?
O resultado mais forte é o consumo de energia. Durante o reconhecimento ativo, todo o sistema consome cerca de 215 mW. Desse total, aproximadamente 160 mW vão para a NPU e o núcleo Cortex-M55, outros 45 mW para a memória externa Flash e PSRAM, e cerca de 10 mW para os pinos externos. E este não é um modo otimizado: o núcleo ainda não usa suspensão agressiva e a NPU está carregada em apenas 10,4%, então ainda há margem para reduzir o consumo. Em qualidade, o quadro também é sério para uma classe de hardware como essa. O modelo tem 8,5 milhões de parâmetros, quase não perdeu
Onde o microcontrolador leva vantagem?
O ponto forte dessa abordagem não é a universalidade a qualquer custo, mas preencher a lacuna entre o simples keyword spotting e o pesado ASR em nuvem. As interfaces de voz locais comuns esperam uma correspondência exata do comando, enquanto aqui o dispositivo já consegue interpretar diferentes formulações do mesmo pedido. Em vez de uma frase rígida, o usuário pode dizer "esquenta um pouco", "aumenta uns cinco graus" ou "temperatura para cima", e o sistema entenderá uma única ação. Daí surgem cenários bem práticos: casa inteligente sem enviar a voz para fora, entrada de núm
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.