AvatarBox, baseado no HeyGen, transforma foto em vídeo falado dentro do Telegram em 2 minutos
O Telegram ganhou o AvatarBox, um bot baseado na API do HeyGen que monta um vídeo talking-head a partir de uma única foto e de um texto em 1–3 minutos. O usuário envia um retrato, escolhe a voz e o formato do quadro e recebe um clipe com legendas automáticas. A ferramenta serve para vídeos de apresentação pessoal, apresentações e conteúdo sem precisar gravar. Vídeos longos, músicas e expressões faciais complexas ainda são os pontos fracos.
Processado por IA de Habr AI; editado por Hamidun News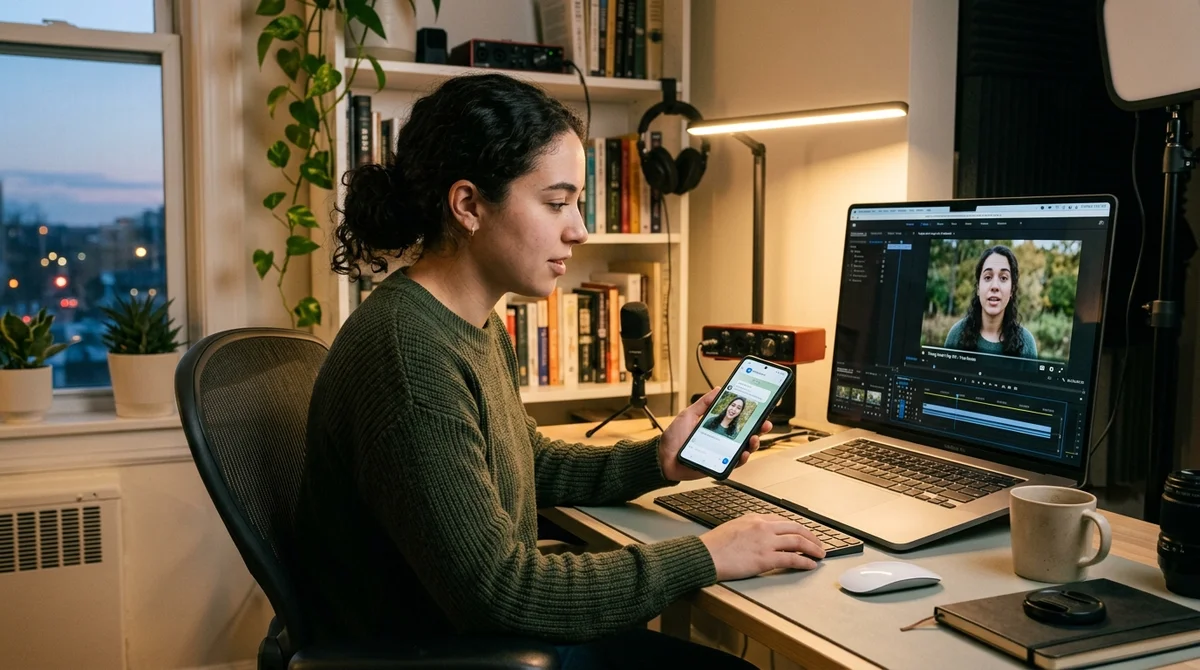
O Telegram ganhou o AvatarBox, um bot baseado na API do HeyGen que transforma uma única foto e um texto curto em um vídeo com avatar falante. O usuário envia um retrato, escolhe a voz e o formato do quadro, e o clipe pronto chega ao chat em cerca de 1–3 minutos.
Como funciona o AvatarBox
O serviço é uma camada simples sobre a API do HeyGen: o usuário não entra em um painel separado, não monta uma cena em um editor de vídeo nem configura a edição manualmente. Toda a lógica se resume ao fluxo familiar de um bot do Telegram. Primeiro é preciso enviar um retrato em close, depois colar o texto que o avatar deve falar e, por fim, escolher a voz. O bot devolve um vídeo talking-head pronto, com o rosto sincronizado à fala e expressões naturais o bastante para formatos curtos.
O serviço tem várias opções práticas que o tornam uma ferramenta de trabalho para clipes rápidos, e não apenas uma demonstração:
- Mais de 2000 vozes em russo, inglês e centenas de outros idiomas
- Três formatos de quadro: 9:16, 1:1 e 16:9
- Ajuste de emoções e da expressividade da fala
- Legendas automáticas no clipe final
- O primeiro vídeo é grátis e sem necessidade de cadastrar cartão
A etapa mais importante é preparar o material de origem. As fotos funcionam melhor de frente, com o olhar direto para a câmera, fundo neutro e boa iluminação. Fotos em grupo, de perfil, escuras, com óculos escuros ou com rostos desfocados dão resultados fracos. Para o texto, o autor recomenda ficar entre 80 e 150 palavras, o suficiente para 30–60 segundos de fala. Depois, basta escolher a voz, ouvir a prévia e iniciar a geração. O bot processa o pedido e devolve o vídeo sem cadastro em plataformas de terceiros.
Cenários práticos
O AvatarBox foi pensado como ferramenta para blogueiros, mas na prática os cenários se mostraram mais amplos. O formato funciona bem em vídeos de apresentação pessoal, quando é preciso se apresentar rapidamente a um recrutador ou cliente sem gravar em frente à câmera. O mesmo vale para apresentações curtas, pitches e onboarding: em vez de um conjunto de slides com narração, dá para montar um clipe em que o avatar expõe os pontos principais e prende a atenção melhor que um texto simples na tela.
«Eu achava que o público principal eram os blogueiros.
Mas não era».
Outra categoria é o conteúdo sem presença pessoal no vídeo. Isso ajuda quem não quer mostrar o rosto, mas quer publicar clipes com regularidade no Telegram, no Shorts ou em canais corporativos internos. Mais um cenário são os vídeos educativos, em que é preciso produzir rapidamente explicações parecidas, sem estúdio nem microfone.
Há também usos mais leves: felicitações, memes e clipes personalizados com fotos de amigos. Esses formatos costumam ser os mais virais, porque aqui a personalização importa mais que a produção.
Onde estão as limitações
O principal problema de serviços assim é que eles funcionam bem apenas em uma faixa estreita de tarefas. Vídeos longos logo denunciam a origem artificial: depois de um minuto, a fala e as expressões começam a parecer repetitivas. Emoções complexas, como surpresa intensa, choro ou raiva, ainda parecem pouco convincentes. Mãos e gestos também não ganham vida, porque a animação é construída em torno do rosto, e não do corpo inteiro. Se a foto original mostra as palmas das mãos ou uma pose ativa, isso tende a atrapalhar mais do que ajudar.
Há ainda limitações técnicas de estabilidade do personagem. Cada geração pode diferir um pouco da anterior, então, para uma série de clipes, é melhor usar a mesma foto e não esperar consistência perfeita. Canto e frases musicais também são um ponto fraco: o lip sync é ajustado para fala comum, não para vocal. Se você precisa de um apresentador virtual próprio, o caminho lógico é primeiro gerar um retrato realista em qualquer gerador de imagens e depois usar esse quadro como base fixa dos clipes.
O que isso significa
A barreira de entrada para o vídeo talking-head continua caindo. Antes, esse formato exigia câmera, luz, microfone e tempo de gravação; agora bastam uma foto, um texto e alguns minutos de espera no Telegram. Para criadores de conteúdo, recrutamento, treinamento interno e apresentações rápidas, já é uma ferramenta útil. Mas ainda não substitui o vídeo ao vivo: assim que o roteiro exige fala longa, expressões complexas ou linguagem corporal, as limitações ficam evidentes demais.
Perguntas frequentes sobre a notícia
Como funciona o AvatarBox?
O serviço é uma camada simples sobre a API do HeyGen: o usuário não entra em um painel separado, não monta uma cena em um editor de vídeo nem configura a edição manualmente. Toda a lógica se resume ao fluxo familiar de um bot do Telegram. Primeiro é preciso enviar um retrato em close, depois colar o texto que o avatar deve falar e, por fim, escolher a voz. O bot devolve um vídeo talking-head pronto, com o rosto sincronizado à fala e expressões naturais o bastante para formatos curtos. O serviço tem várias opções práticas que o tornam uma ferramenta de trabalho para clipes r
O que se sabe sobre Cenários práticos?
O AvatarBox foi pensado como ferramenta para blogueiros, mas na prática os cenários se mostraram mais amplos. O formato funciona bem em vídeos de apresentação pessoal, quando é preciso se apresentar rapidamente a um recrutador ou cliente sem gravar em frente à câmera. O mesmo vale para apresentações curtas, pitches e onboarding: em vez de um conjunto de slides com narração, dá para montar um clipe em que o avatar expõe os pontos principais e prende a atenção melhor que um texto simples na tela. «Eu achava que o público principal eram os blogueiros. Mas não era». Outra categ
Onde estão as limitações?
O principal problema de serviços assim é que eles funcionam bem apenas em uma faixa estreita de tarefas. Vídeos longos logo denunciam a origem artificial: depois de um minuto, a fala e as expressões começam a parecer repetitivas. Emoções complexas, como surpresa intensa, choro ou raiva, ainda parecem pouco convincentes. Mãos e gestos também não ganham vida, porque a animação é construída em torno do rosto, e não do corpo inteiro. Se a foto original mostra as palmas das mãos ou uma pose ativa, isso tende a atrapalhar mais do que ajudar. Há ainda limitações técnicas de estabi
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.