NVIDIA mostra o Gemma 4 com voz e webcam rodando no Jetson Orin Nano Super
A NVIDIA montou uma demo local do Gemma 4 para o Jetson Orin Nano Super: o modelo ouve comandos de voz, acessa a webcam por conta própria quando precisa e responde via TTS. O conjunto usa o Parakeet para reconhecimento de fala, o Kokoro para síntese de voz e o llama.cpp com vision projector. O principal resultado é um agente multimodal rodando em uma placa compacta com 8 GB de memória, sem depender da nuvem.
Processado por IA de Hugging Face Blog; editado por Hamidun News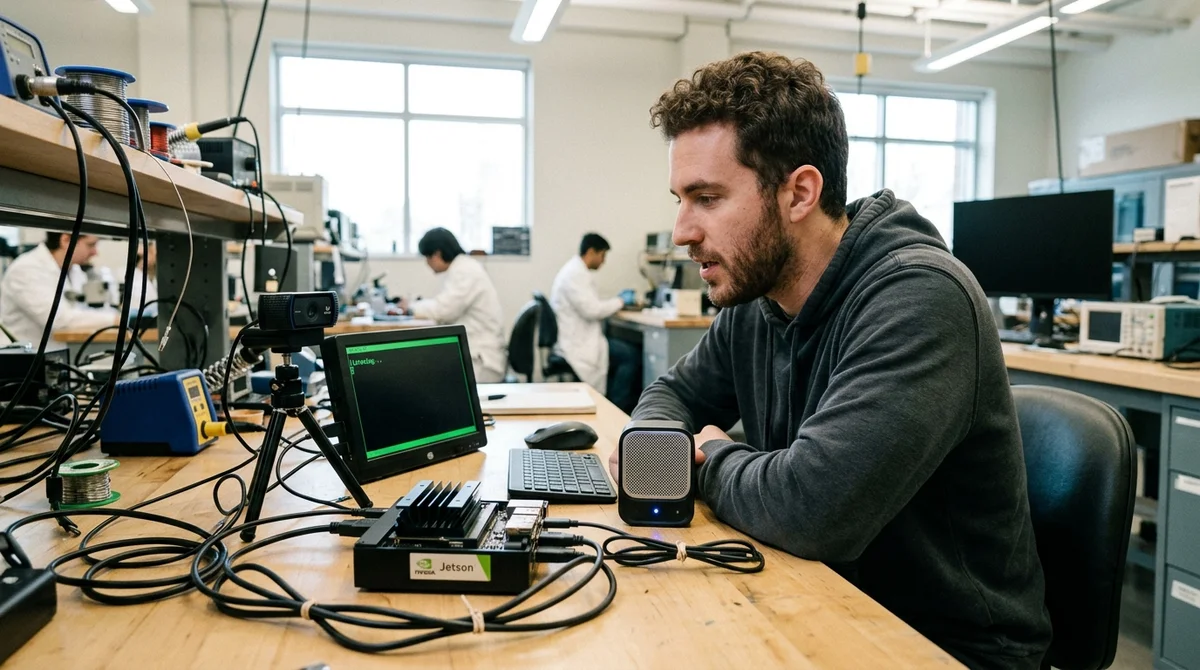
A NVIDIA apresentou uma demo de edge com aplicação prática: o Gemma 4 ouve uma pergunta, acessa a webcam por conta própria quando precisa e responde por voz, tudo localmente em um Jetson Orin Nano Super com 8 GB de memória. A publicação, de 22 de abril de 2026, chama atenção pelo tutorial em si e também por outro motivo: o agente multimodal roda em uma placa compacta, e não na nuvem.
Como funciona o conjunto
O cenário foi montado como um agente de voz simples, com uma única ferramenta visual. O usuário aperta a barra de espaço e faz a pergunta em voz alta. Em seguida, o Parakeet converte a fala em texto localmente. O Gemma 4 recebe a solicitação e decide sozinho se precisa olhar pela webcam. Se precisar, o script captura um quadro e o envia ao modelo, e a resposta é então convertida em voz pelo Kokoro TTS. O artigo destaca que o modelo não descreve a imagem de forma genérica: ele usa o que vê apenas para responder à pergunta específica.
«Sinceramente, já impressiona que isso funcione em um
Jetson Orin Nano».
O ponto-chave é que não há gatilhos fixos nem lógica manual do tipo «se a pergunta contém a palavra camera». O script expõe ao Gemma 4 exatamente uma tool, `look_and_answer`, que tira uma foto e analisa a cena. Cabe ao próprio modelo decidir se a chama ou não. Para isso, a NVIDIA usa o `llama-server` do `llama.cpp` com a flag `--jinja`, que ativa o suporte nativo a tool calling. Na prática, é um cenário VLA compacto, em que a visão só entra em ação quando realmente é necessária.
O que é preciso para rodar
A demo não é nenhuma mágica pronta para uso: trata-se de um guia bem estruturado para entusiastas e desenvolvedores que querem reproduzir um pipeline multimodal local na própria máquina. A NVIDIA descreve mais do que a execução do script em Python e cobre toda a stack, dos pacotes do sistema e da compilação do `llama.cpp` à configuração de áudio e câmera e ao download do vision projector para o Gemma 4.
- Jetson Orin Nano Super com 8 GB de memória, webcam, microfone USB ou câmera com microfone embutido, caixas de som USB e teclado
- Ambiente Python com `opencv-python-headless`, `onnx_asr`, `kokoro-onnx`, `soundfile`, `huggingface-hub` e `numpy`
- `llama.cpp` compilado localmente com CUDA, o modelo `gemma-4-E2B-it` em GGUF e um arquivo `mmproj` separado, sem o qual o Gemma 4 não consegue enxergar
- Configuração de `MIC_DEVICE`, `SPK_DEVICE`, `WEBCAM` e `VOICE`; depois disso, a demo roda com um único comando: `python3 Gemma4_vla.py`
- Um modo somente texto via Docker, para quem quer testar rapidamente a parte de LLM sem a configuração visual completa
A memória recebe atenção especial. A placa de 8 GB dá conta do recado, mas o autor recomenda explicitamente liberar RAM, encerrar processos desnecessários e até adicionar swap para evitar um OOM durante o carregamento do modelo. A opção base indicada é a versão quantizada `Q4_K_M`; com restrições mais severas, dá para descer até `Q3`. É um detalhe importante: não se trata de um produto de consumo polido, e sim de uma receita funcional em que cada gigabyte faz diferença real no resultado.
Por que isso é interessante
Rodar o Gemma 4 em um Jetson não é a novidade aqui — isso já era esperado para as versões mais leves. O que importa é que a NVIDIA apresenta um modelo prático de agente multimodal local, que combina STT, LLM, tool calling, visão e TTS sem precisar recorrer à nuvem. Para dispositivos de edge, é um sinal forte. Até agora, cenários assim costumavam ficar restritos a servidores ou a demos bastante limitadas, em que o modelo apenas responde a texto.
Ao mesmo tempo, o guia é transparente sobre as limitações. A primeira execução é lenta, porque os modelos são baixados e os arquivos de voz são gerados. O modo VLA completo exige compilação nativa e o vision projector, enquanto a versão em Docker serve apenas para texto. Se faltar memória ao servidor, é preciso limpar o sistema manualmente. A NVIDIA também não apresenta benchmarks de velocidade no artigo nem mostra vídeo com a latência real, então ainda falta muito para um assistente pronto para qualquer pessoa. Como demonstração de direção, porém, o caso é bastante convincente.
O que isso significa
Agentes de IA locais estão cada vez mais perto do uso prático em hardware barato. Para desenvolvedores, isso abre a possibilidade de criar interfaces de voz privadas e protótipos multimodais sem depender de infraestrutura em nuvem. Para o mercado de edge AI, é mais um passo das apresentações bonitas rumo a sistemas que dá para montar de verdade na mesa, testar e integrar a um produto.
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Autor do Habr faz fine-tuning do YOLOv8l em radiografias dentárias e leva o mAP50 a 0,642
- 1 de nov. de 2026Bots de voz com LLM usam o classificador rápido Jev: decisão em 200–500 ms
- 1 de nov. de 2026Camada de proteção MoneyGate barrou os 42 pedidos fraudulentos feitos a IAs locais
Perguntas frequentes sobre a notícia
Como funciona o conjunto?
O cenário foi montado como um agente de voz simples, com uma única ferramenta visual. O usuário aperta a barra de espaço e faz a pergunta em voz alta. Em seguida, o Parakeet converte a fala em texto localmente. O Gemma 4 recebe a solicitação e decide sozinho se precisa olhar pela webcam. Se precisar, o script captura um quadro e o envia ao modelo, e a resposta é então convertida em voz pelo Kokoro TTS. O artigo destaca que o modelo não descreve a imagem de forma genérica: ele usa o que vê apenas para responder à pergunta específica. «Sinceramente, já impressiona que isso fu
O que é preciso para rodar?
A demo não é nenhuma mágica pronta para uso: trata-se de um guia bem estruturado para entusiastas e desenvolvedores que querem reproduzir um pipeline multimodal local na própria máquina. A NVIDIA descreve mais do que a execução do script em Python e cobre toda a stack, dos pacotes do sistema e da compilação do `llama.cpp` à configuração de áudio e câmera e ao download do vision projector para o Gemma 4. Jetson Orin Nano Super com 8 GB de memória, webcam, microfone USB ou câmera com microfone embutido, caixas de som USB e teclado Ambiente Python com `opencv-python-headless`,
Por que isso é interessante?
Rodar o Gemma 4 em um Jetson não é a novidade aqui — isso já era esperado para as versões mais leves. O que importa é que a NVIDIA apresenta um modelo prático de agente multimodal local, que combina STT, LLM, tool calling, visão e TTS sem precisar recorrer à nuvem. Para dispositivos de edge, é um sinal forte. Até agora, cenários assim costumavam ficar restritos a servidores ou a demos bastante limitadas, em que o modelo apenas responde a texto. Ao mesmo tempo, o guia é transparente sobre as limitações. A primeira execução é lenta, porque os modelos são baixados e os arquivo
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.