Amazon apresenta busca em linguagem natural em grandes acervos de vídeo com o Nova
A Amazon apresentou uma arquitetura funcional para buscar em grandes acervos de vídeo sem marcação manual nem palavras-chave rígidas. O Nova divide os vídeos em segmentos de 15 segundos, gera embeddings multimodais e os grava no OpenSearch junto com tags. Em um conjunto de cerca de 792 mil vídeos, a busca semântica respondeu em 76 ms e o modo híbrido, em cerca de 106 ms.
Processado por IA de AWS Machine Learning Blog; editado por Hamidun News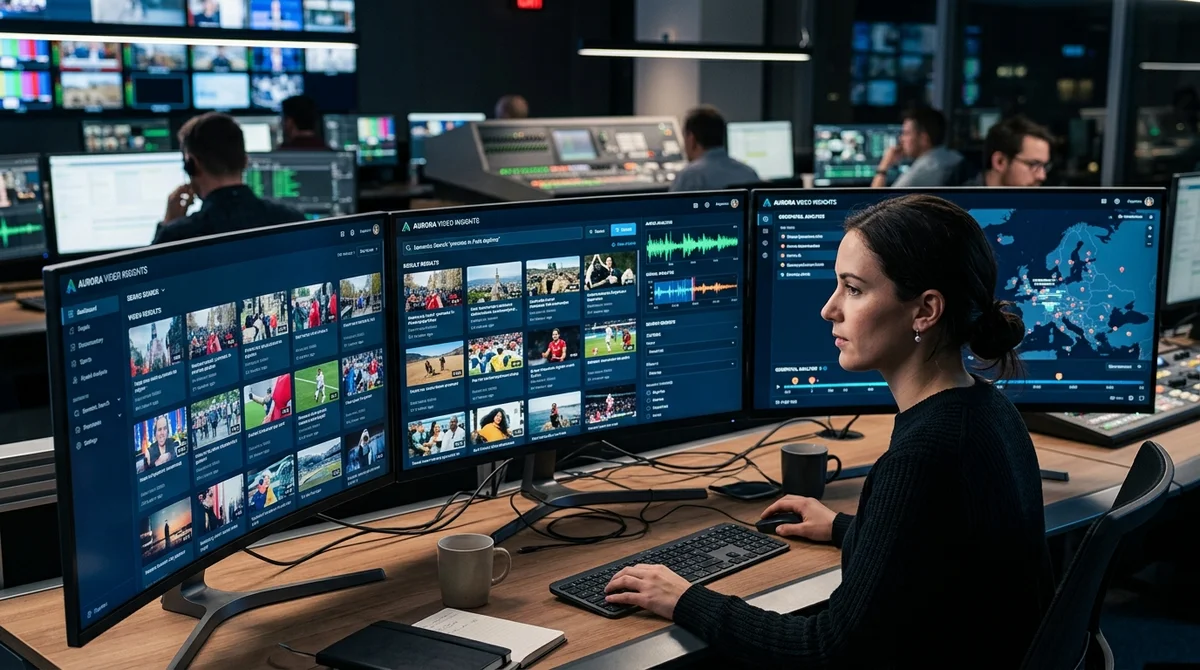
A Amazon mostrou como montar uma busca em grandes acervos de vídeo sem marcação manual e sem dependência rígida de palavras-chave. Em vez de aplicar tags por roteiro, o sistema gera embeddings multimodais de áudio e imagem e depois encontra os vídeos por significado, via OpenSearch.
Como funciona a busca
A solução se baseia no Amazon Nova Multimodal Embeddings e no Amazon OpenSearch Service. Os vídeos são enviados ao S3 e, em seguida, a API assíncrona do Nova os divide automaticamente em segmentos de 15 segundos e gera vetores de 1024 dimensões no modo AUDIO_VIDEO_COMBINED. Isso é importante: o modelo considera não só a imagem, mas também o som, então a busca não entende palavras soltas de uma legenda, e sim o contexto da cena: quem está falando, o que acontece no quadro e qual é o clima do trecho.
Separadamente, a AWS sugere passar os vídeos pelo Nova Pro ou pelo Nova 2 Lite para gerar de 10 a 15 tags descritivas conforme uma taxonomia definida. Com isso, o sistema mantém dois índices: um vetorial, para busca semântica, e um textual, para busca por palavras-chave. Esse esquema dispensa a escolha entre a busca "inteligente" e a filtragem por metadados: dá para combinar as duas abordagens em uma única interface. Na prática, o mesmo acervo pode ser consultado tanto com pedidos como "uma pessoa caminha na praia ao pôr do sol" quanto com filtros de texto rigorosos.
- Busca de vídeo por texto: uma consulta em linguagem natural vira um embedding e é comparada com os segmentos de vídeo.
- Busca de vídeos semelhantes: o sistema pega o vetor de um vídeo já conhecido e encontra trechos de conteúdo próximo.
- Busca híbrida: os resultados de k-NN e BM25 são combinados, por padrão com pesos de 70% para a semântica e 30% para o texto.
Escala e economia
A AWS testou o esquema não em um conjunto de demonstração com alguns arquivos, mas em um acervo de cerca de 792 mil vídeos dos datasets Multimedia Commons e MEVA. No total, são cerca de 8.480 horas de conteúdo, ou 30,5 milhões de segundos. O processamento completo levou 41 horas em quatro instâncias c7i.48xlarge, com 600 workers paralelos. O Bedrock tem um limite de 30 tarefas assíncronas simultâneas por conta, por isso o exemplo usa uma fila de jobs que consulta o status e carrega novos vídeos conforme os slots são liberados.
O quadro de custos também é bastante transparente. A AWS estima o primeiro ano de um sistema assim em cerca de US$ 23,6–27,3 mil, dependendo do modelo de pagamento do OpenSearch. Desse total, cerca de US$ 18,1 mil vão para o carregamento único e a geração de embeddings, e o restante para a operação anual da camada de busca. A maior despesa não é a computação em EC2, mas os próprios embeddings, porque o Nova é cobrado pela duração do vídeo. O detalhamento é este:
- cerca de US$ 17.096: geração de embeddings multimodais no Amazon Bedrock
- cerca de US$ 571: autotagging com o Nova Pro
- cerca de US$ 421: computação em EC2 para processamento em lote
- de US$ 5.544 a US$ 9.240 por ano: armazenamento e busca no OpenSearch, conforme o modelo de pagamento
A AWS também explica por que o exemplo usa vetores de 1024 dimensões e não de 3072: o custo de geração não muda, mas o armazenamento fica cerca de três vezes mais barato, com perda mínima de precisão.
No lado da busca, os números já parecem de produção: o k-NN semântico responde em cerca de 76 ms, o BM25 em 30 ms e o modo híbrido em 106 ms. Os índices de todo o corpus ocupam cerca de 29,8 GB, então nem um grande acervo de vídeo exige infraestrutura exótica.
Nuances práticas
Este material importa não como anúncio de mais um modelo, mas como um modelo de engenharia pronto para uso. A AWS mostra, na prática, como sair da marcação manual de vídeos para um AI data lake, em que a busca se organiza em torno de embeddings e não de descrições humanas. Para equipes de empresas de mídia e entretenimento, isso pode resolver várias tarefas de uma vez: busca de duplicatas, navegação pelo acervo, seleção rápida de b-roll e criação de ferramentas internas para editores, produtores e arquivistas.
Mas há limitações. Para rodar, é preciso ter o Bedrock na região us-east-1, OpenSearch 2.11 ou mais recente, S3 e permissões IAM configuradas. Velocidade e preço dependem diretamente da duração dos vídeos: no teste, um vídeo de 45 segundos levou cerca de 70 segundos para ser processado. Se os metadados forem bons, a AWS recomenda aumentar a participação da busca textual, até 50/50. E, se a biblioteca continuar crescendo, a lógica de processamento pode ser movida para o AWS Batch e escalada por partes.
O que isso significa
A Amazon mostra que a busca multimodal em vídeo já pode ser vista não como um brinquedo de pesquisa, mas como um padrão de infraestrutura bem compreendido. Para equipes de mídia, é a chance de deixar de depender de tags manuais e finalmente buscar no acervo do jeito que as pessoas realmente formulam consultas: em linguagem natural.
- 2 de nov. de 2026Jornalista da The Verge monta um rival do Meta Muse Charm por $50 com ajuda do Claude Code
- 31 de out. de 2026Worldwide Express entrega contas contestadas a agentes de IA e reduz dívida em 75%
- 30 de out. de 2026AWS dá a agentes de código uma prévia ao vivo do site direto da sessão isolada
- 30 de out. de 2026MoEngage abre 400 APIs privadas a agentes de IA via AgentCore Gateway, sem servidores MCP próprios
Perguntas frequentes sobre a notícia
Como funciona a busca?
A solução se baseia no Amazon Nova Multimodal Embeddings e no Amazon OpenSearch Service. Os vídeos são enviados ao S3 e, em seguida, a API assíncrona do Nova os divide automaticamente em segmentos de 15 segundos e gera vetores de 1024 dimensões no modo AUDIO_VIDEO_COMBINED. Isso é importante: o modelo considera não só a imagem, mas também o som, então a busca não entende palavras soltas de uma legenda, e sim o contexto da cena: quem está falando, o que acontece no quadro e qual é o clima do trecho. Separadamente, a AWS sugere passar os vídeos pelo Nova Pro ou pelo Nova 2 Li
O que se sabe sobre Escala e economia?
A AWS testou o esquema não em um conjunto de demonstração com alguns arquivos, mas em um acervo de cerca de 792 mil vídeos dos datasets Multimedia Commons e MEVA. No total, são cerca de 8.480 horas de conteúdo, ou 30,5 milhões de segundos. O processamento completo levou 41 horas em quatro instâncias c7i.48xlarge, com 600 workers paralelos. O Bedrock tem um limite de 30 tarefas assíncronas simultâneas por conta, por isso o exemplo usa uma fila de jobs que consulta o status e carrega novos vídeos conforme os slots são liberados. O quadro de custos também é bastante transparen
O que se sabe sobre Nuances práticas?
Este material importa não como anúncio de mais um modelo, mas como um modelo de engenharia pronto para uso. A AWS mostra, na prática, como sair da marcação manual de vídeos para um AI data lake, em que a busca se organiza em torno de embeddings e não de descrições humanas. Para equipes de empresas de mídia e entretenimento, isso pode resolver várias tarefas de uma vez: busca de duplicatas, navegação pelo acervo, seleção rápida de b-roll e criação de ferramentas internas para editores, produtores e arquivistas. Mas há limitações. Para rodar, é preciso ter o Bedrock na região
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.