Um stack open source de 6 modelos e 9 agentes mostrou como montar uma equipe de AI em um único servidor
Um único servidor com GPU, seis modelos open source e nove agentes — essa é a configuração de uma equipe autônoma de AI que projeta, escreve, testa e implanta novos agentes por conta própria. Em vez de um modelo universal, os papéis são distribuídos de acordo com os pontos fortes: reasoning para o orquestrador, geração de código para o construtor, tool use para o crítico. A principal economia vem do compartilhamento de instâncias: 9 agentes usam apenas 3–4 modelos. Há também três opções de implantação, de uma RTX 4090 a um cluster de A100.
Processado por IA de Habr AI; editado por Hamidun News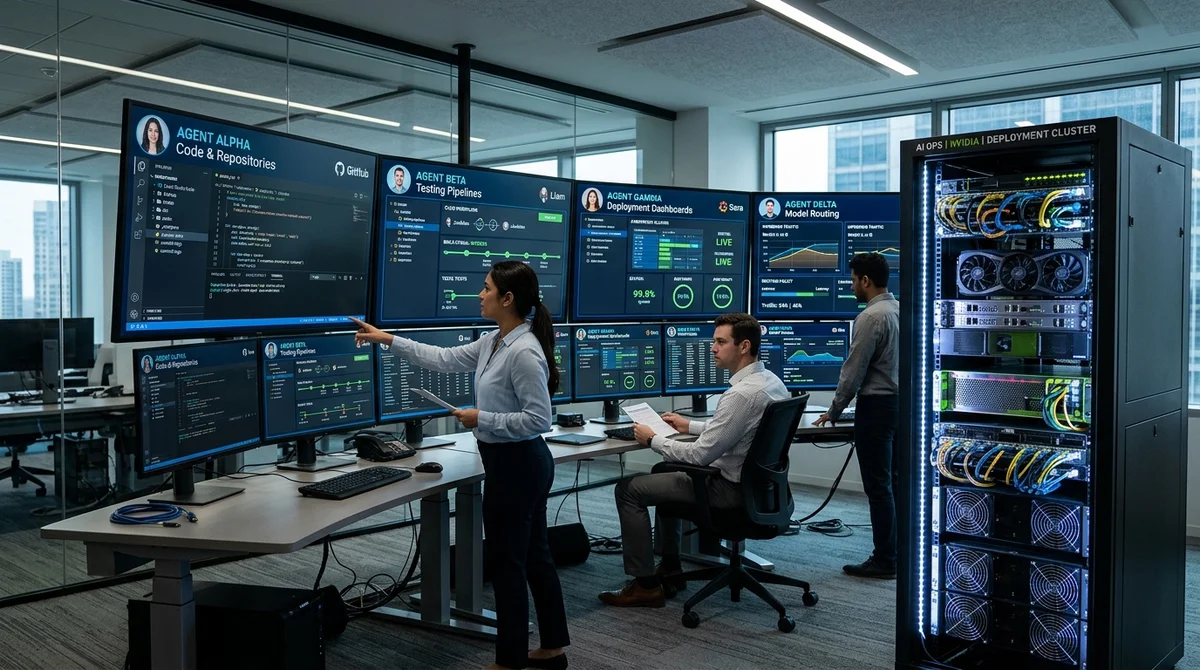
Uma equipe autônoma de nove agentes de IA pode projetar, escrever, testar e implementar novos agentes sem participação humana. Para isso, não é necessário um conjunto de APIs fechadas: o esquema é construído em seis modelos de código aberto e na versão básica cabe em um único servidor com GPU.
Como a equipe é estruturada
Em vez de um modelo "universal", o autor montou um pipeline de nove funções. Alguns agentes lidam com formulação de tarefas e arquitetura, outros com escrita de código, verificação de qualidade, testes e implantação. O resultado não é um grande assistente, mas uma pequena organização de engenharia onde cada participante faz uma parte estreita do trabalho. Essa abordagem reduz o caos: um agente não precisa simultaneamente planejar o sistema, escrever módulos, executar testes e avaliar seus próprios erros.
A ideia-chave é que a autonomia é alcançada não por magia, mas pela divisão do processo em etapas. Se um agente compreende apenas sua própria parte e recebe uma tarefa já estruturada como entrada, os requisitos para o modelo se tornam mais claros. O orquestrador deve ser capaz de raciocinar e manter contexto, o construtor deve gerar código de forma estável, o crítico deve ver problemas no uso de ferramentas e cenários de execução. É por isso que o ganho vem não de um super-modelo, mas da montagem precisa de funções em um pipeline funcional.
Funções e benchmarks
O autor rejeita diretamente a ideia de um "melhor modelo absoluto". Em vez disso, as funções são selecionadas com base no que os benchmarks confirmam. Para o orquestrador, o raciocínio é importante, então o benchmark é GPQA em 88,4%. Para o construtor, a geração de código é crítica e o HumanEval em 92,7% é usado aqui. Para o crítico, entender o uso de ferramentas e o comportamento dos agentes em tarefas é mais importante, então o tau-bench em 87,4% é usado.
É precisamente por causa dessa especialização que, em vez de um modelo GPT-class para todos os casos, seis modelos de código aberto diferentes são usados.
- Orquestrador — raciocínio forte, priorização e decomposição de tarefas
- Construtor — geração de código e mudanças rápidas de engenharia
- Crítico — verificação de uso de ferramentas, qualidade de soluções e fraquezas do pipeline
- Outras funções — testes, implantação e etapas auxiliares onde instâncias comuns podem ser reutilizadas
Ao mesmo tempo, nove agentes não significam nove modelos completos na memória simultaneamente. Um truque prático é o compartilhamento de instâncias: várias funções compartilham o mesmo modelo se suas cargas e perfis de tarefas forem semelhantes. Como resultado, um sistema de nove agentes pode rodar em apenas três ou quatro instâncias de modelo. Isso reduz drasticamente o consumo de VRAM, simplifica a manutenção e aproxima a arquitetura da produção real, em vez de uma demonstração com orçamento ilimitado.
Hardware e inicialização
Separadamente interessante é a parte de infraestrutura. O autor descreve três configurações de implantação: de um único RTX 4090 com 24 GB de memória a um cluster A100 com um total de 211 GB. Entre esses extremos, você pode escolher um equilíbrio entre velocidade, qualidade e paralelismo. Para reduzir custos, quantização, infraestrutura de inferência bem projetada e um painel interativo que ajuda a rastrear funções, carga e progresso das tarefas são usados.
Ou seja, não se trata apenas de selecionar modelos, mas também de um ambiente operacional adequado para eles. A conclusão prática é simples: a agência de código aberto deixa de ser um brinquedo para o laboratório. Se tais esquemas eram anteriormente associados a APIs caras ou clusters pesados, aqui é mostrado um caminho mais realista para iniciar. Uma pequena equipe pode começar com um único servidor, verificar a viabilidade do pipeline e depois escalá-lo conforme as tarefas crescem. O custo da questão já parece uma escolha de engenharia, não uma barreira que imediatamente filtra a maioria das equipes.
O que isso significa
O mercado está se movimentando da ideia de um modelo "mágico" para sistemas orientados por função, onde a composição correta importa mais do que um nome de API badalado. Para os negócios, este é um sinal: equipes de IA autônomas podem ser montadas a partir de componentes de código aberto agora mesmo, se você as tratar como infraestrutura e processo, não como uma única janela de bate-papo.
- 31 de out. de 2026DeepSeek reduz o cache de memória do modelo para 890 bytes por token, contra 3514
- 31 de out. de 2026Freefield: estúdio aberto com ComfyUI e 120 apps para imagens, vídeo e áudio
- 31 de out. de 2026Modelo de vídeo de 22 bilhões de parâmetros roda em uma RTX 3080 com 10 GB de memória
- 31 de out. de 2026Mirendil anuncia o Fern 0.1: contexto de 10 milhões de tokens, mas agente fraco
Perguntas frequentes sobre a notícia
Como a equipe é estruturada?
Em vez de um modelo "universal", o autor montou um pipeline de nove funções. Alguns agentes lidam com formulação de tarefas e arquitetura, outros com escrita de código, verificação de qualidade, testes e implantação. O resultado não é um grande assistente, mas uma pequena organização de engenharia onde cada participante faz uma parte estreita do trabalho. Essa abordagem reduz o caos: um agente não precisa simultaneamente planejar o sistema, escrever módulos, executar testes e avaliar seus próprios erros. A ideia-chave é que a autonomia é alcançada não por magia, mas pela di
O que se sabe sobre Funções e benchmarks?
O autor rejeita diretamente a ideia de um "melhor modelo absoluto". Em vez disso, as funções são selecionadas com base no que os benchmarks confirmam. Para o orquestrador, o raciocínio é importante, então o benchmark é GPQA em 88,4%. Para o construtor, a geração de código é crítica e o HumanEval em 92,7% é usado aqui. Para o crítico, entender o uso de ferramentas e o comportamento dos agentes em tarefas é mais importante, então o tau-bench em 87,4% é usado. É precisamente por causa dessa especialização que, em vez de um modelo GPT-class para todos os casos, seis modelos de
O que se sabe sobre Hardware e inicialização?
Separadamente interessante é a parte de infraestrutura. O autor descreve três configurações de implantação: de um único RTX 4090 com 24 GB de memória a um cluster A100 com um total de 211 GB. Entre esses extremos, você pode escolher um equilíbrio entre velocidade, qualidade e paralelismo. Para reduzir custos, quantização, infraestrutura de inferência bem projetada e um painel interativo que ajuda a rastrear funções, carga e progresso das tarefas são usados. Ou seja, não se trata apenas de selecionar modelos, mas também de um ambiente operacional adequado para eles. A conclu
Delegate Deep Research, Coding & Multi-Step Workflows to Nomad Agent
Deploy autonomous task execution with Nomad Agent (agent.nomadnet.ai) — automated web research, data synthesis, code generation, and MCP tool orchestration.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.