OTUS: por que os modelos de linguagem alucinam e quais medidas reduzem o risco de erros
As alucinações dos modelos LLM não são um bug raro, mas uma limitação sistêmica da AI generativa. A OTUS explica por que os modelos confundem fatos com confiança, inventam fontes e erram em código, suporte e análise, além de por que o fine-tuning não resolve o problema por completo. A conclusão prática é simples: todos os cenários críticos exigem retrieval, validação, casos de teste, monitoramento e presença humana no circuito.
Processado por IA de Habr AI; editado por Hamidun News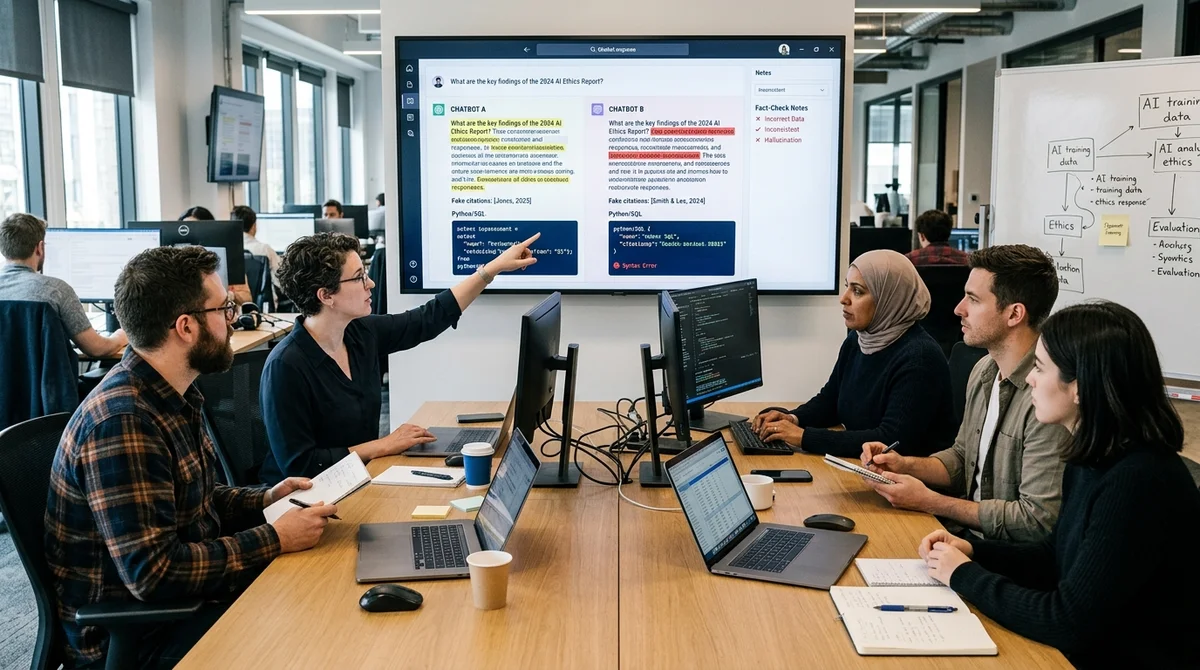
Alucinações em modelos de linguagem — estas não são uma falha rara, mas uma propriedade fundamental da IA generativa: o sistema pode soar confiante mesmo onde carece de fatos. Para equipes que integram LLMs em produtos, suporte, análise ou processos internos, isso significa não apenas imprecisão, mas um risco operacional bem concreto.
De Onde Vem o Erro
Um modelo de linguagem não verifica a verdade como um humano ou mecanismo de busca fazem. Sua tarefa é prever a continuação mais provável de um texto baseado em um conjunto massivo de dados e relações estatísticas entre palavras. Se o pedido carece de contexto, a formulação é ambígua ou os dados de treinamento contêm poucos exemplos confiáveis, o modelo ainda assim se esforça para entregar uma resposta coerente.
Daí surge o efeito que os usuários percebem como uma mentira: o texto parece lógico, o tom confiante, mas os fatos podem ser inventados ou misturados. O problema é amplificado em cenários onde espera-se do modelo citações precisas, números, formulações legais, recomendações médicas ou código. Em tais tarefas, uma LLM não apenas pode confundir a fonte, mas também preencher detalhes faltantes por padrão: inventar um estudo, citar uma lei inexistente, mencionar uma versão incorreta de API ou propor um fragmento de código que parece funcional mas é inseguro.
Quanto mais plausível a resposta na superfície, maior o risco de que o erro passe adiante no processo sem verificação.
Por Que Apenas Fine-Tuning Não é Suficiente
A ideia intuitiva de "vamos simplesmente fazer fine-tuning do modelo e eliminar alucinações" funciona apenas parcialmente. Fine-tuning realmente ajuda o modelo a se comportar melhor em um domínio específico, seguir o formato de resposta e raramente sair para fantasia óbvia. Mas não transforma o modelo em um sistema que conhece apenas fatos verificados e consegue parar garantidamente quando há insuficiência de dados.
O modelo continua sendo otimizado para texto plausível, não para a veracidade de cada afirmação. Mesmo modelos grandes e bem ajustados continuam a errar em casos raros, eventos recentes, tópicos altamente especializados e longas cadeias de raciocínio. Quanto mais passos entre a pergunta e a resposta, maior a chance de que uma imprecisão apareça em um dos elos.
Por isso o problema não é resolvido por um único ajuste de temperatura, um novo dataset ou um prompt mágico. É necessária uma arquitetura na qual o modelo não seja a única fonte de verdade e não tome decisões críticas sem suporte externo.
Como Reduzir o Risco
Na prática, a abordagem funcional é não esperar comportamento impecável de uma LLM, mas construir camadas de proteção ao seu redor. Quanto mais caro o erro para o negócio, mais verificações, restrições e regras explícitas de recusa de resposta devem estar no pipeline. Isso muda a abordagem para a implementação: em vez da pergunta "como fazer o modelo nunca errar," surge outra — "como garantir que um erro não se torne um incidente." E isso já é uma questão de design de sistema, não magia do modelo.
- Conectar retrieval e fazer o modelo responder apenas a partir de documentos encontrados
- Exigir citações a fragmentos específicos de dados, não a fontes abstratas
- Separar geração e validação: um passo escreve a resposta, outro verifica fatos e formato
- Limitar o escopo da tarefa para que o modelo não improvise além do domínio
- Adicionar human-in-the-loop para cenários legais, financeiros, médicos e de produção
Monitoramento e testes têm importância especial. A equipe precisa de conjuntos de casos de teste, métricas por tipos de erros e um registro de situações onde o modelo recusou responder ou entregou um resultado incorreto. É útil comparar o comportamento de LLM contra regras determinísticas comuns e ver onde a automação realmente acelera o trabalho e onde cria risco oculto. Se o sistema escreve código, comunica-se com clientes ou tira conclusões de dados, os erros devem ser analisados tão sistematicamente quanto bugs em um produto comum.
O Que Isso Significa
Alucinações não são uma exceção irritante, mas uma limitação da classe de tecnologia. Isso significa que as equipes vencedoras não são aquelas que confiam cegamente na resposta inteligente, mas aquelas que projetam a LLM como um componente probabilístico com verificações, limites de aplicação e uma compreensão clara do custo do erro.
Perguntas frequentes sobre a notícia
O que se sabe sobre De Onde Vem o Erro?
Um modelo de linguagem não verifica a verdade como um humano ou mecanismo de busca fazem. Sua tarefa é prever a continuação mais provável de um texto baseado em um conjunto massivo de dados e relações estatísticas entre palavras. Se o pedido carece de contexto, a formulação é ambígua ou os dados de treinamento contêm poucos exemplos confiáveis, o modelo ainda assim se esforça para entregar uma resposta coerente. Daí surge o efeito que os usuários percebem como uma mentira: o texto parece lógico, o tom confiante, mas os fatos podem ser inventados ou misturados. O problema é
Por Que Apenas Fine-Tuning Não é Suficiente?
A ideia intuitiva de "vamos simplesmente fazer fine-tuning do modelo e eliminar alucinações" funciona apenas parcialmente. Fine-tuning realmente ajuda o modelo a se comportar melhor em um domínio específico, seguir o formato de resposta e raramente sair para fantasia óbvia. Mas não transforma o modelo em um sistema que conhece apenas fatos verificados e consegue parar garantidamente quando há insuficiência de dados. O modelo continua sendo otimizado para texto plausível, não para a veracidade de cada afirmação. Mesmo modelos grandes e bem ajustados continuam a errar em caso
Como Reduzir o Risco?
Na prática, a abordagem funcional é não esperar comportamento impecável de uma LLM, mas construir camadas de proteção ao seu redor. Quanto mais caro o erro para o negócio, mais verificações, restrições e regras explícitas de recusa de resposta devem estar no pipeline. Isso muda a abordagem para a implementação: em vez da pergunta "como fazer o modelo nunca errar," surge outra — "como garantir que um erro não se torne um incidente." E isso já é uma questão de design de sistema, não magia do modelo. Conectar retrieval e fazer o modelo responder apenas a partir de documentos e
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.