MIT ensina IA generativa a completar objetos ocultos a partir de sinais sem fio
O MIT aprimorou a "visão" sem fio dos robôs: um modelo generativo completa as partes ocultas de objetos a partir dos reflexos de sinais mmWave, próximos do Wi-Fi. O sistema Wave-Former é quase 20% mais preciso que as abordagens anteriores, e o RISE consegue reconstruir uma sala inteira com um único radar estacionário e o movimento de uma pessoa. A tecnologia pode ser útil em armazéns, casas inteligentes e cenários em que câmeras são indesejáveis por questões de privacidade.
Processado por IA de MIT News; editado por Hamidun News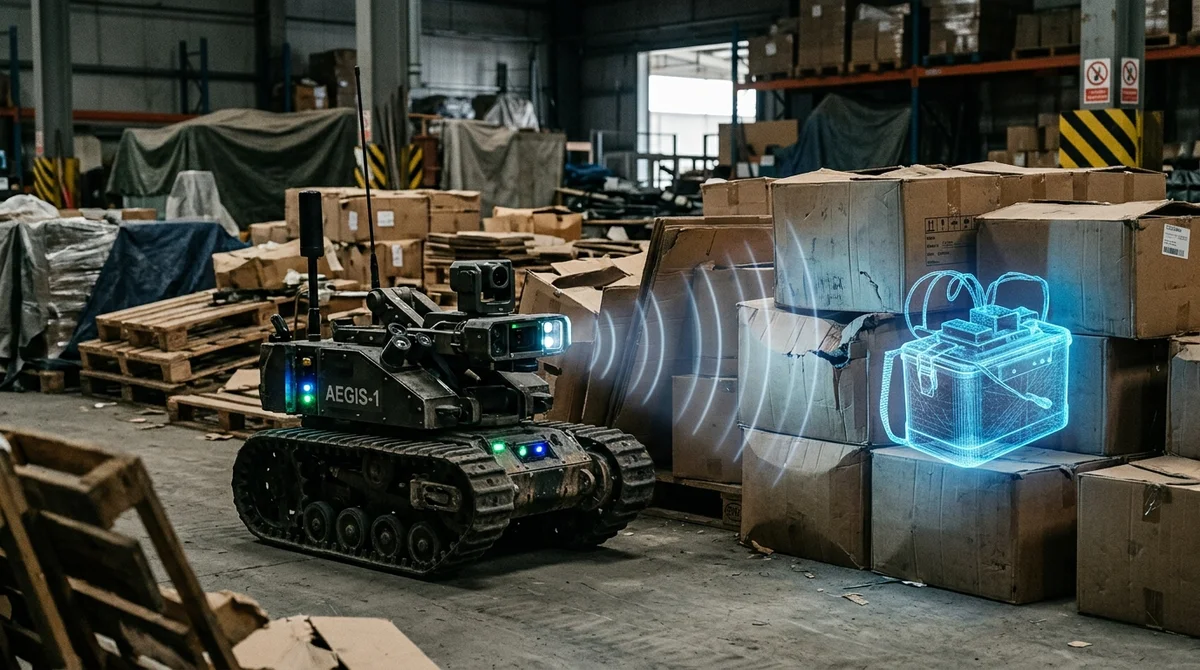
Pesquisadores do MIT aprimoraram um sistema de "visão" sem fio que reconhece objetos escondidos atrás de obstáculos a partir dos reflexos de sinais de ondas milimétricas. Um modelo generativo agora completa as partes que faltam na forma e ajuda os robôs a entender com mais precisão o que está atrás de papelão, plástico, drywall ou tecido.
Como funciona
As versões anteriores desses sistemas já conseguiam usar sinais mmWave para montar um modelo 3D aproximado de um objeto escondido atrás de uma barreira. O problema estava na física da reflexão: as ondas costumam ser desviadas em uma direção, em vez de voltar ao sensor. Por isso, o sistema normalmente "enxergava" só a parte de cima do objeto, enquanto as superfícies laterais e inferiores ficavam como zonas vazias.
Para um robô, isso é crítico: se a forma é reconstruída de maneira imprecisa, o manipulador tem mais dificuldade de definir como pegar o item com segurança e como ele está posicionado no espaço.
Para contornar essa limitação, a equipe do MIT adicionou um modelo generativo que recebe uma reconstrução incompleta e completa uma forma inteira plausível. Mas faltavam conjuntos de dados reais de mmWave para o treinamento, então os pesquisadores buscaram um atalho: pegaram grandes conjuntos de imagens geradas por computador e os adaptaram às propriedades dos reflexos sem fio, incluindo especularidade e ruído. Com essa base sintética, treinaram o sistema Wave-Former. Ele primeiro propõe possíveis superfícies do objeto a partir dos reflexos, depois o modelo preenche as lacunas e, em seguida, refina a geometria até chegar a uma reconstrução 3D completa.
Precisão e cenas
Nos testes, o Wave-Former reconstruiu as formas de cerca de 70 objetos do dia a dia, de latas e caixas a frutas e utensílios de cozinha. Os objetos foram escondidos atrás de papelão, madeira, drywall, plástico e tecido, ou colocados sob esses materiais. Segundo o MIT, o novo esquema produziu uma reconstrução quase 20 por cento mais precisa que as melhores abordagens anteriores. Na prática, é um passo importante: o sistema não apenas detecta a presença de um item, mas se aproxima de entender sua forma, volume e limites reais.
"Estamos usando IA para finalmente liberar o potencial da visão sem fio", diz
Fadel Adib, que lidera o trabalho.
A equipe não parou por aí e criou um segundo sistema, o RISE, que reconstrói não um objeto isolado, mas uma sala inteira. Para isso, bastam um radar estacionário e o movimento de uma pessoa no ambiente. Quando alguém anda, parte do sinal é refletida pela pessoa, depois pelas paredes e pelos móveis, e então volta ao sensor. Esses reflexos secundários costumam ser tratados como ruído e descartados, mas o MIT ensinou o modelo a extrair deles a planta da cena. Em experimentos com mais de 100 trajetórias de movimento de pessoas, o RISE foi, em média, cerca de duas vezes mais preciso que os métodos existentes.
Onde pode ser útil
O valor prático não está só na precisão, mas também no formato de uso. Para analisar a cena, não é preciso um robô móvel com sensor que circule pelo ambiente e o escaneie de vários pontos. Basta um único radar parado. Além disso, o método não se baseia em câmeras comuns, o que o torna mais adequado a cenários em que a privacidade das pessoas no enquadramento importa.
- Verificação do conteúdo de caixas e embalagens antes do envio
- Busca de itens cobertos por outras coisas em um armazém ou em casa
- Reconstrução da planta de uma sala com um único sensor estacionário
- Detecção da posição de uma pessoa para que o robô se mova com mais segurança
- Cenários em que é indesejável usar câmeras por causa da privacidade
Se a tecnologia ganhar mais detalhe e robustez, poderá ter chance de sair do laboratório. A equipe do MIT diz abertamente que o próximo passo são modelos de base maiores para sinais sem fio, por analogia com a forma como GPT, Claude e Gemini lidam com texto e imagens. Essa abordagem pode transformar a detecção sem fio, hoje uma ferramenta de pesquisa restrita, em uma camada universal de percepção para robôs e ambientes inteligentes.
O que isso significa
O MIT mostra uma mudança interessante: em vez de espremer manualmente o máximo de cada reflexo, os pesquisadores entregam a um modelo generativo a tarefa de deduzir a geometria que falta a partir de dados parciais. Se essa abordagem escalar, os robôs poderão "ver" atrás de obstáculos com mais confiança onde uma câmera comum é inútil ou indesejável.
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Kimi marca 96,2% em teste de análise em base 1C e vira reserva caso o Claude seja bloqueado
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Google admite que o AI Mode reduz a receita da Busca; ações caem 15%
Perguntas frequentes sobre a notícia
Como funciona?
As versões anteriores desses sistemas já conseguiam usar sinais mmWave para montar um modelo 3D aproximado de um objeto escondido atrás de uma barreira. O problema estava na física da reflexão: as ondas costumam ser desviadas em uma direção, em vez de voltar ao sensor. Por isso, o sistema normalmente "enxergava" só a parte de cima do objeto, enquanto as superfícies laterais e inferiores ficavam como zonas vazias. Para um robô, isso é crítico: se a forma é reconstruída de maneira imprecisa, o manipulador tem mais dificuldade de definir como pegar o item com segurança e como
O que se sabe sobre Precisão e cenas?
Nos testes, o Wave-Former reconstruiu as formas de cerca de 70 objetos do dia a dia, de latas e caixas a frutas e utensílios de cozinha. Os objetos foram escondidos atrás de papelão, madeira, drywall, plástico e tecido, ou colocados sob esses materiais. Segundo o MIT, o novo esquema produziu uma reconstrução quase 20 por cento mais precisa que as melhores abordagens anteriores. Na prática, é um passo importante: o sistema não apenas detecta a presença de um item, mas se aproxima de entender sua forma, volume e limites reais. "Estamos usando IA para finalmente liberar o pote
Onde pode ser útil?
O valor prático não está só na precisão, mas também no formato de uso. Para analisar a cena, não é preciso um robô móvel com sensor que circule pelo ambiente e o escaneie de vários pontos. Basta um único radar parado. Além disso, o método não se baseia em câmeras comuns, o que o torna mais adequado a cenários em que a privacidade das pessoas no enquadramento importa. Verificação do conteúdo de caixas e embalagens antes do envio Busca de itens cobertos por outras coisas em um armazém ou em casa Reconstrução da planta de uma sala com um único sensor estacionário Detecção da p
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.