Machine Learning Mastery aponta cinco grandes barreiras para escalar a IA agêntica em 2026
A Machine Learning Mastery publicou uma análise sobre por que a IA agêntica ainda é difícil de escalar em produção em 2026. Os principais gargalos são a complexidade explosiva da orquestração, a observabilidade fraca, os custos imprevisíveis, os métodos de teste imaturos e as proteções defasadas. Sem essas camadas, a autonomia rapidamente vira fonte de falhas, riscos e estouro de orçamento, principalmente para empresas com usuários reais e SLAs.
Processado por IA de Machine Learning Mastery; editado por Hamidun News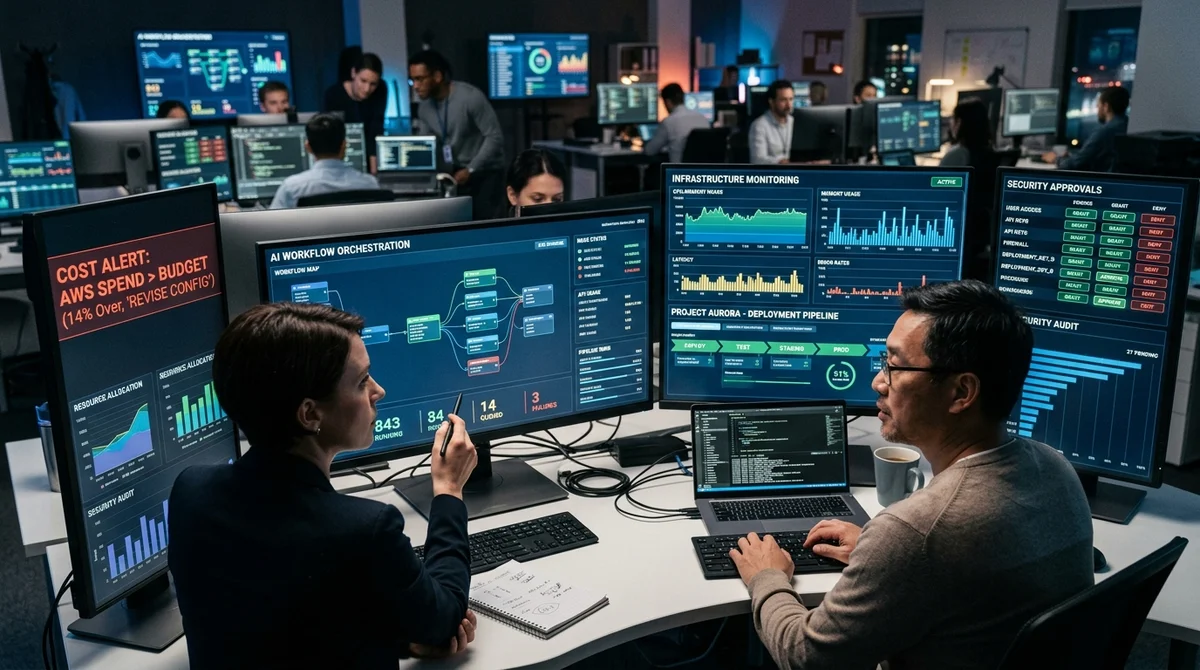
A Machine Learning Mastery publicou um material sobre cinco problemas que freiam a adoção em massa da IA agêntica em produção. A ideia central é simples: entre uma demo impressionante e um sistema que funciona de forma estável sob carga existe uma camada de engenharia à parte, e é justamente ela que mais quebra hoje.
Onde a orquestração quebra
Enquanto há um único agente com uma tarefa restrita, o pipeline parece sob controle. Mas, assim que o sistema passa a repassar tarefas a outros agentes, escolher ferramentas na hora e repetir etapas que falharam, a complexidade cresce não de forma linear, e sim quase explosiva. As equipes enfrentam menos os limites dos modelos e mais a coordenação: agentes esperam uns pelos outros, cenários assíncronos caem em race conditions e um erro em uma etapa dispara uma falha em cascata em outra.
"As demos parecem impressionantes, e os protótipos parecem mágica."
Por isso, um esquema que se sustenta tranquilo com cem requisições por minuto pode desabar com dezenas de milhares. Com isso, as empresas constroem seus próprios orquestradores e depois descobrem que essa camada é a mais cara e a mais frágil de toda a stack. Para as equipes de ML, é uma mudança de mentalidade: já não basta escolher um bom modelo, é preciso saber projetar um sistema distribuído com comportamento previsível sob carga.
Observabilidade e dinheiro
O segundo problema é a observabilidade fraca. Métricas comuns, como latência e throughput, já não bastam: na IA agêntica é preciso enxergar todo o caminho de execução. Por que o agente escolheu uma ferramenta em vez de outra? Por que repetiu uma etapa três vezes? Por que o resultado final falhou se cada etapa intermediária parecia normal?
A infraestrutura de rastreamento profundo para esses cenários ainda é imatura, e o comportamento dos próprios sistemas é não determinístico. Uma mesma requisição pode seguir ramos diferentes, então reproduzir e corrigir incidentes fica bem mais difícil.
Nesse contexto, logo aparece um terceiro tema: o custo. Uma única requisição agêntica costuma envolver dezenas de chamadas a LLMs, e em produção isso vira rapidamente uma conta alta. Mesmo um preço de cerca de 15 centavos por cenário só parece tolerável até o volume chegar a centenas de milhares de execuções por dia.
Por isso, as equipes de engenharia já apostam em algumas técnicas básicas:
- roteamento de subtarefas simples para modelos mais baratos
- cache agressivo de resultados intermediários
- kill switch para loops descontrolados e retentativas infinitas
- limites rígidos para o número de etapas, chamadas e tentativas
O problema é que a economia quase sempre conflita com a qualidade. Reduziu o número de etapas, o risco de erro aumenta. Passou parte das tarefas para um modelo mais barato, o resultado fica menos estável. E, principalmente, os orçamentos são difíceis de prever: um caso fora do padrão pode disparar uma longa cadeia de retentativas e tornar uma única requisição dezenas de vezes mais cara que o normal.
Testes e controle
A quarta barreira é a ausência de uma abordagem madura de testes. O software clássico se apoia em comportamento determinístico, e o ML clássico, em uma ligação fixa entre entrada e saída. A IA agêntica quebra os dois modelos de uma vez. Hoje, as equipes verificam esses sistemas com LLM-as-a-judge, conjuntos de testes por cenário e simulações em ambientes sintéticos, mas ainda não há um padrão comum. Os benchmarks são fragmentados, as ferramentas são dispersas e a revisão humana continua sendo a principal salvaguarda, embora escale mal.
O quinto problema é governança e segurança. O agente já não apenas escreve texto: ele envia e-mails, altera dados, acessa serviços externos e potencialmente dispara transações. Por isso, são necessários direitos de acesso, confirmação de ações, restrições de escopo e auditoria detalhada. Mas, quanto mais rígidas as proteções, menor a sensação de autonomia e mais fraco o efeito uau do produto.
O fator regulatório também pressiona: assim que esses sistemas passam a afetar diretamente os clientes, as questões de responsabilidade, conformidade e verificabilidade das decisões deixam de ser teoria.
O que isso significa
O mercado de IA agêntica esbarrou não na qualidade das demos, mas na infraestrutura ao redor delas. Vão vencer não os que montarem o próximo agente mais rápido, mas os que, antes dos demais, acertarem orquestração, rastreamento, testes, orçamentos e mecanismos de proteção.
Perguntas frequentes sobre a notícia
Onde a orquestração quebra?
Enquanto há um único agente com uma tarefa restrita, o pipeline parece sob controle. Mas, assim que o sistema passa a repassar tarefas a outros agentes, escolher ferramentas na hora e repetir etapas que falharam, a complexidade cresce não de forma linear, e sim quase explosiva. As equipes enfrentam menos os limites dos modelos e mais a coordenação: agentes esperam uns pelos outros, cenários assíncronos caem em race conditions e um erro em uma etapa dispara uma falha em cascata em outra. "As demos parecem impressionantes, e os protótipos parecem mágica." Por isso, um esquema
O que se sabe sobre Observabilidade e dinheiro?
O segundo problema é a observabilidade fraca. Métricas comuns, como latência e throughput, já não bastam: na IA agêntica é preciso enxergar todo o caminho de execução. Por que o agente escolheu uma ferramenta em vez de outra? Por que repetiu uma etapa três vezes? Por que o resultado final falhou se cada etapa intermediária parecia normal? A infraestrutura de rastreamento profundo para esses cenários ainda é imatura, e o comportamento dos próprios sistemas é não determinístico. Uma mesma requisição pode seguir ramos diferentes, então reproduzir e corrigir incidentes fica bem
O que se sabe sobre Testes e controle?
A quarta barreira é a ausência de uma abordagem madura de testes. O software clássico se apoia em comportamento determinístico, e o ML clássico, em uma ligação fixa entre entrada e saída. A IA agêntica quebra os dois modelos de uma vez. Hoje, as equipes verificam esses sistemas com LLM-as-a-judge, conjuntos de testes por cenário e simulações em ambientes sintéticos, mas ainda não há um padrão comum. Os benchmarks são fragmentados, as ferramentas são dispersas e a revisão humana continua sendo a principal salvaguarda, embora escale mal. O quinto problema é governança e segur
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.