Sber mostra como RAG e um LLM no IDE transformam roteiros manuais em testes automatizados
A Sber apresentou um protótipo para os IDEs da JetBrains que gera testes automatizados a partir de cenários manuais combinando LLM e RAG. O sistema busca passos e testes relevantes no próprio projeto, preserva o estilo do código e verifica o resultado via PSI. Dentro da empresa, 68% dos testes gerados exigiram apenas ajustes mínimos, e a satisfação dos usuários ficou em cerca de 80%.
Processado por IA de Habr AI; editado por Hamidun News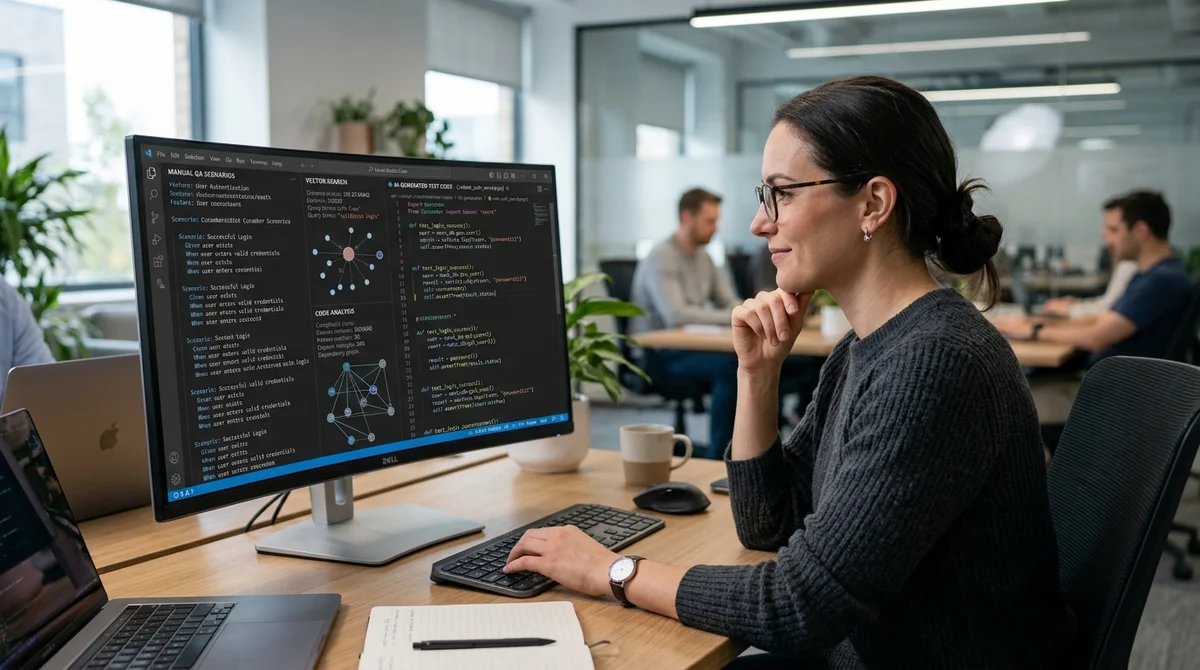
A Sber mostrou como reduzir uma das tarefas mais rotineiras de QA: transformar cenários manuais em testes automatizados direto no IDE. A base é uma combinação de LLM e RAG que não se limita a escrever código: primeiro ela procura exemplos relevantes no próprio projeto, para manter seu estilo, suas convenções e sua arquitetura.
Por que um prompt direto não funciona
A ideia de "simplesmente enviar o teste manual ao modelo e receber o código pronto" quebra nos detalhes. Um LLM de fato pode montar um teste Java funcional, mas quase certamente não o fará do jeito adotado por uma equipe específica: esquecerá o Allure, violará o esquema de nomenclatura, colocará a URL e o corpo da requisição no lugar errado, adicionará verificações desnecessárias ou não usará utilitários internos, como um método comum de checagem de status. Na automação de testes isso não é cosmético, e sim perda real de compatibilidade com o projeto.
O problema é mais profundo que a qualidade do prompt. Os testes automatizados vivem em seu próprio framework e dependem da arquitetura, do CI, do Page Object, das chaves de TMS e das convenções de anotações. Se você tenta passar o projeto inteiro ao modelo, logo esbarra nos limites da janela de contexto, no aumento da latência e no custo das requisições. Mesmo assim, sobram alucinações, passos omitidos e um resultado instável, que precisa ser levado manualmente ao estado desejado.
Como o RAG funciona
Em vez de um few-shot estático com exemplos escolhidos à mão, a equipe da Sber criou um plugin para os IDEs da JetBrains. Ele varre o projeto pela estrutura PSI, e não como texto bruto, e por isso enxerga classes, métodos, anotações e chamadas. Com essa base, o sistema reúne passos do Allure, testes automatizados existentes, suas chaves de TMS, o código e breves descrições textuais. Essas descrições são então convertidas em embeddings e salvas, junto com metadados, em uma base de conhecimento local ou em um armazenamento vetorial.
Quando um novo cenário manual chega, o sistema passa por várias etapas:
- extrai a ação e o resultado esperado de cada passo;
- monta várias variantes semânticas da consulta para buscar passos semelhantes;
- pede ao LLM que descreva brevemente o teste inteiro, para encontrar um teste automatizado próximo em significado;
- insere automaticamente os exemplos encontrados no prompt, no lugar do few-shot manual;
- valida o resultado com uma nova requisição ao modelo e via PSI dentro do IDE.
Essa abordagem gera um código que parece escrito por alguém da própria equipe, e não por um modelo externo sem contexto. O artigo destaca que a busca semântica não está ali pela moda do RAG, mas com um objetivo prático: trazer para a geração justamente os passos, utilitários e padrões que já provaram funcionar dentro do projeto.
RAG é um few-shot que encontra sozinho os exemplos necessários.
Resultados do protótipo
Segundo a equipe, o protótipo interno já trouxe um efeito mensurável. Cerca de 68% dos testes gerados ficaram em nível aceitável e exigiram apenas ajustes mínimos, e a satisfação geral dos usuários foi de aproximadamente 80%. A ferramenta foi melhor em cenários de API simples e parecidos, nos quais é especialmente importante reproduzir rápido um modelo de código já consolidado, sem copiar manualmente de testes vizinhos. Os engenheiros de automação também notaram menor carga cognitiva: menos tempo vai para a rotina e mais para cenários complexos e decisões de arquitetura.
Mas não existe aqui um "piloto automático" universal. O modelo ainda tende a simplificar testes complexos com muitos passos, e para cenários de UI precisa de mais contexto, como informações sobre os objetos da página. As alucinações também não sumiram, por isso a revisão final continua obrigatória. Os autores acrescentam que não viram limitações sérias de linguagem: resultados semelhantes saíram não só em Java, mas também em Python e Gherkin. Pela estimativa deles, uma ferramenta assim pode economizar do engenheiro de automação mais da metade do tempo gasto escrevendo novos testes de rotina.
O que isso significa
Para as ferramentas de IA no desenvolvimento, começa uma etapa mais interessante: o valor passa de "gerar qualquer código" para "gerar código que se encaixa de imediato em um projeto vivo". O caso da Sber indica que, em QA, não vencerão as equipes que apenas plugarem um LLM no IDE, mas as que cercarem o modelo com sua própria base de conhecimento, verificações e regras de engenharia.
Perguntas frequentes sobre a notícia
Por que um prompt direto não funciona?
A ideia de "simplesmente enviar o teste manual ao modelo e receber o código pronto" quebra nos detalhes. Um LLM de fato pode montar um teste Java funcional, mas quase certamente não o fará do jeito adotado por uma equipe específica: esquecerá o Allure, violará o esquema de nomenclatura, colocará a URL e o corpo da requisição no lugar errado, adicionará verificações desnecessárias ou não usará utilitários internos, como um método comum de checagem de status. Na automação de testes isso não é cosmético, e sim perda real de compatibilidade com o projeto. O problema é mais prof
Como o RAG funciona?
Em vez de um few-shot estático com exemplos escolhidos à mão, a equipe da Sber criou um plugin para os IDEs da JetBrains. Ele varre o projeto pela estrutura PSI, e não como texto bruto, e por isso enxerga classes, métodos, anotações e chamadas. Com essa base, o sistema reúne passos do Allure, testes automatizados existentes, suas chaves de TMS, o código e breves descrições textuais. Essas descrições são então convertidas em embeddings e salvas, junto com metadados, em uma base de conhecimento local ou em um armazenamento vetorial. Quando um novo cenário manual chega, o sist
O que se sabe sobre Resultados do protótipo?
Segundo a equipe, o protótipo interno já trouxe um efeito mensurável. Cerca de 68% dos testes gerados ficaram em nível aceitável e exigiram apenas ajustes mínimos, e a satisfação geral dos usuários foi de aproximadamente 80%. A ferramenta foi melhor em cenários de API simples e parecidos, nos quais é especialmente importante reproduzir rápido um modelo de código já consolidado, sem copiar manualmente de testes vizinhos. Os engenheiros de automação também notaram menor carga cognitiva: menos tempo vai para a rotina e mais para cenários complexos e decisões de arquitetura. Ma
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.