Lemana Tech mostrou como combinou LLM, RAG e ML tradicional no suporte técnico
A Lemana Tech explicou como reestruturou o suporte após o aumento no volume de solicitações: deixou a classificação em massa com o ML tradicional e acionou LLMs com RAG apenas para consultas complexas e específicas de domínio em ambiente corporativo. Essa abordagem elevou a classificação automatizada para 76%, tornou as respostas bem-sucedidas mais de 20 vezes mais rápidas e reduziu a carga sobre especialistas de alto custo sem risco desnecessário, atrasos ou automação cega.
Processado por IA de Habr AI; editado por Hamidun News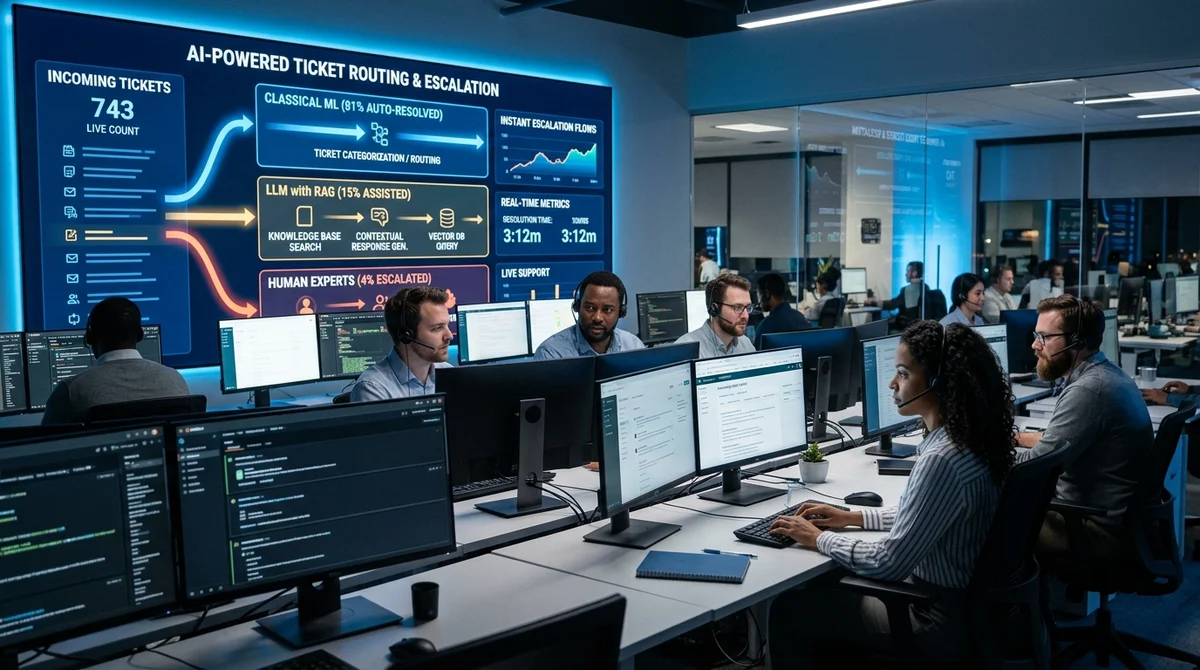
A Lemana Tech compartilhou como reestruturou a automação do Service Desk após um aumento no volume de requisições. A empresa não substituiu todo o suporte por um único modelo grande, mas montou um esquema híbrido: a classificação em massa permaneceu com ML clássico, enquanto LLM com RAG foi conectado apenas onde realmente agrega valor.
Por Que o ML Clássico Não Era Suficiente
No ecossistema da Lemana Tech, existem mais de 500 sistemas de negócio, 2500 operações de serviço e cerca de 100 mil requisições de suporte por mês. Para uma carga como essa, importam não apenas a qualidade do modelo, mas também o custo do erro, a velocidade de reação e o custo computacional. A stack básica com boosting e TF-IDF funcionou bem por muito tempo: um modelo com features adicionais como cargo, local de trabalho e horário da requisição entregava F1 em torno de 0,86 e cobria grande parte dos roteiros típicos. Mas conforme o número de cenários cresceu, isso deixou de ser suficiente.
A equipe testou LSTM, GRU, BERT, RoBERTa, Electra, Yandex Foundation Models e adaptadores LoRA para LLMs abertos. Algumas abordagens perderam para boosting nas métricas, outras se mostraram muito caras no treinamento. Ao final, o melhor resultado para classificação não veio de uma abordagem "pura" de LLM, mas de um transformer com features tabulares adicionais e atenção aditiva: esse esquema elevou F1 macro para 0,89 e considerou melhor o contexto de cada colaborador.
Onde RAG É Ativado
O LLM nessa arquitetura não tenta resolver tudo. É ativado apenas nas classes de requisição onde o usuário precisa de uma resposta significativa da documentação interna, não apenas do roteamento correto do ticket. Um exemplo é o suporte à plataforma MLOps, onde colaboradores precisam de respostas sobre Kubeflow, Jenkins e pipelines internos.
Ali a requisição vai para o chat, passa pelo classificador e entra no circuito RAG baseado em Qwen2.5 8B com um embedder customizado. Se a resposta for encontrada na base de conhecimento, o usuário a recebe em cerca de 60 segundos.
Se o modelo não estiver confiante no resultado, ou a pessoa apertar o comando para alternar para um especialista, o ticket vai imediatamente para um expert de verdade sem esperar pelo SLA normal. Este é um ponto importante: o LLM não coloca uma barreira desnecessária à frente do humano, mas funciona como uma primeira camada rápida onde você economiza tempo de especialistas L4 caros mantendo controle sobre a qualidade.
- Qwen2.5 8B é usado em versão quantizada para CPU
- Embedder customizado treinado em 10 mil tripletas
- Precisão da busca na base de conhecimento atingiu 92% Hit@3
- Escalação dispara com confidence score abaixo de 0,7
- Usuário pode alternar instantaneamente para um humano
O Que Funcionou Melhor
Uma parte separada do case é a autorresolução. A equipe encontrou padrões recorrentes de requisições que poderiam ser fechadas sem envolvimento do suporte, mas não automatizou cegamente todas as respostas frequentes. Para filtrar, usou Qwen2.5 14B: o modelo avaliava se uma pessoa realmente conseguiria resolver o problema por conta própria pela instrução ou se nada funcionaria sem um colaborador. Isso cortou padrões falsos como reset de senha, onde o email é padrão, mas a ação ainda precisa ser executada por um especialista.
"Usar LLM em todo lugar, como é moda agora, não é a abordagem certa."
Após esse filtro, o que roda em produção novamente não é um LLM, mas um modelo leve—regressão logística. Aprende rápido, custa quase nada na inferência e consegue servir continuamente o fluxo de requisições. O resultado: Lemana Tech relata crescimento na classificação automatizada de 55% para 76%, aumento na precisão de classificação para 92% considerando limites, e aceleração de 20x nas autorresolução e respostas do bot bem-sucedidas. O LLM não substituiu o ML clássico aqui, mas ocupou um lugar estreito mas valioso na cadeia.
O Que Isso Significa
O case da Lemana Tech ilustra bem a lógica atual madura de implementar IA generativa no suporte: LLMs caros não precisam ser o núcleo de todo o sistema. Frequentemente o melhor resultado vem de um híbrido onde ML clássico classifica rápido o fluxo, RAG responde apenas em zonas de domínio complexas, e humanos se conectam sem atrito se a confiança do modelo for insuficiente. Para equipes corporativas, este é provavelmente um caminho mais realista do que tentar mover todo o Service Desk para um único modelo universal.
Perguntas frequentes sobre a notícia
Por Que o ML Clássico Não Era Suficiente?
No ecossistema da Lemana Tech, existem mais de 500 sistemas de negócio, 2500 operações de serviço e cerca de 100 mil requisições de suporte por mês. Para uma carga como essa, importam não apenas a qualidade do modelo, mas também o custo do erro, a velocidade de reação e o custo computacional. A stack básica com boosting e TF-IDF funcionou bem por muito tempo: um modelo com features adicionais como cargo, local de trabalho e horário da requisição entregava F1 em torno de 0,86 e cobria grande parte dos roteiros típicos. Mas conforme o número de cenários cresceu, isso deixou d
Onde RAG É Ativado?
O LLM nessa arquitetura não tenta resolver tudo. É ativado apenas nas classes de requisição onde o usuário precisa de uma resposta significativa da documentação interna, não apenas do roteamento correto do ticket. Um exemplo é o suporte à plataforma MLOps, onde colaboradores precisam de respostas sobre Kubeflow, Jenkins e pipelines internos. Ali a requisição vai para o chat, passa pelo classificador e entra no circuito RAG baseado em Qwen2.5 8B com um embedder customizado. Se a resposta for encontrada na base de conhecimento, o usuário a recebe em cerca de 60 segundos. Se o
O Que Funcionou Melhor?
Uma parte separada do case é a autorresolução. A equipe encontrou padrões recorrentes de requisições que poderiam ser fechadas sem envolvimento do suporte, mas não automatizou cegamente todas as respostas frequentes. Para filtrar, usou Qwen2.5 14B: o modelo avaliava se uma pessoa realmente conseguiria resolver o problema por conta própria pela instrução ou se nada funcionaria sem um colaborador. Isso cortou padrões falsos como reset de senha, onde o email é padrão, mas a ação ainda precisa ser executada por um especialista. "Usar LLM em todo lugar, como é moda agora, não é
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.