Machine Learning Mastery: por que aplicações de IA precisam de mais do que um banco vetorial
A Machine Learning Mastery lembrou algo simples: um vector store é ótimo para busca semântica, mas não substitui todo o banco de dados de um produto de IA. Em produção, ao lado dos embeddings quase sempre é preciso ter SQL para permissões, metadados, cobrança e estado da aplicação. Para muitas equipes, PostgreSQL com pgvector pode ser o melhor ponto de partida. Um banco vetorial separado só faz sentido em grande escala.
Processado por IA de Machine Learning Mastery; editado por Hamidun News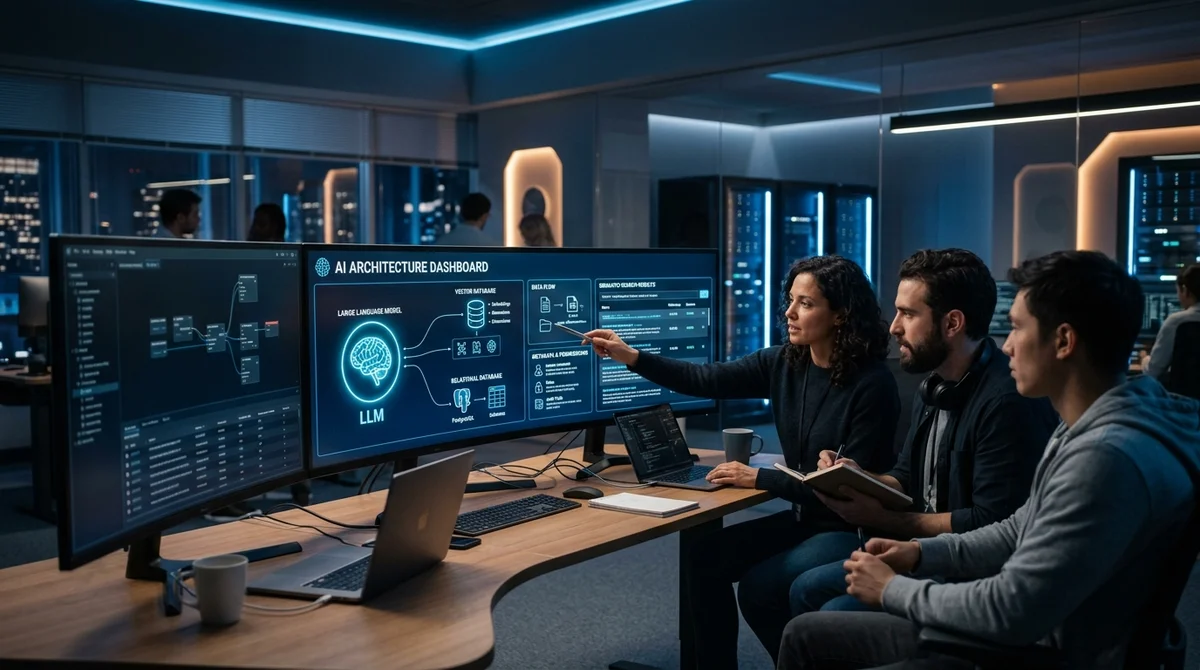
A Machine Learning Mastery analisou um erro comum na arquitetura de aplicações de IA: tratar o vector store como um banco de dados completo para todo o produto. Na fase de demo, isso muitas vezes basta, mas em produção, ao lado da busca vetorial, quase sempre é necessária uma camada relacional clássica.
Onde o vector store é forte
Os bancos vetoriais se tornaram peça padrão dos sistemas RAG porque resolvem uma tarefa que o SQL comum faz mal: buscar por significado, e não por correspondência exata de palavras. Quando o usuário faz uma pergunta, o sistema a transforma em um embedding e procura os trechos de documentos mais próximos em significado. Assim, a IA pode encontrar textos relevantes mesmo quando eles não usam as mesmas palavras da consulta.
Isso é especialmente útil com dados não estruturados: documentos internos, correspondências, PDFs e bases de conhecimento. Se alguém pergunta sobre os direitos do inquilino diante de mofo no apartamento, a busca vetorial encontrará seções sobre padrões de habitabilidade ou obrigações do locador, mesmo que a expressão "condições de moradia perigosas" não apareça no documento. Essa abordagem lida melhor com erros de digitação, paráfrases e contexto implícito. Por isso o vector store virou um componente básico da busca com IA onde as formulações quase nunca coincidem palavra por palavra.
Onde o SQL é necessário
O problema é que a flexibilidade da busca vetorial a torna, ao mesmo tempo, uma ferramenta imprecisa para tarefas operacionais. Ela responde bem à pergunta "o que é parecido em significado", mas serve mal quando é preciso uma resposta firme, sem probabilidades nem margens. Assim que o produto passa a ter usuários, limites, pagamentos e status de objetos, a busca aproximada começa a atrapalhar em vez de ajudar.
Por isso, em um sistema de produção o banco relacional continua sendo o lugar onde vivem todos os "fatos concretos":
- permissões de acesso e fronteiras entre tenants, onde um erro vira vazamento de dados;
- metadados de documentos: autor, URL, data de upload, hash do arquivo, status de publicação;
- cobrança, auditoria, logs e quaisquer registros que precisem ser consistentes;
- estado da aplicação: se um chat está arquivado, se uma flag está ligada, qual plano o usuário tem.
Há ainda outro ponto prático: a filtragem precisa em SQL reduz as alucinações do modelo. Se a IA deve resumir apenas tickets de alta prioridade fechados nos últimos 7 dias pela equipe de frontend, é preciso primeiro selecionar rigorosamente esses registros e só depois entregar o texto ao modelo. É mais barato, mais rápido e mais seguro do que torcer para que a busca vetorial sozinha retorne, por acaso, um conjunto de dados perfeitamente delimitado. No fundo, aqui o SQL não compete com o LLM, mas prepara para ele uma área de trabalho correta.
Um esquema híbrido
O autor propõe não escolher entre as duas abordagens, mas combiná-las em uma única camada de dados. Um cenário típico é este: primeiro o banco relacional verifica o usuário, seu papel e a lista de documentos aos quais ele tem acesso, e só depois o vector store busca correspondências semânticas dentro desse subconjunto seguro. Para assistentes de IA corporativos, isso não é otimização, e sim uma fronteira de segurança. Sem esse pré-filtro, o sistema corre o risco de mostrar ao usuário dados de outra equipe ou até de outro cliente.
O padrão inverso também funciona. Depois que a busca vetorial retorna os trechos relevantes, a aplicação pode buscar no SQL os metadados: quem é o autor do documento, quando foi atualizado, qual é seu status de confiança. Assim o modelo responde não de forma abstrata, mas com contexto, por exemplo ligado à atualidade do documento ou ao departamento que o publicou. Para bases de conhecimento internas e agentes de suporte, isso aumenta bastante a confiança na resposta e ajuda o usuário a verificar rapidamente sua origem.
Para equipes que não querem manter dois bancos diferentes, a Machine Learning Mastery destaca o pgvector, extensão do PostgreSQL para busca por similaridade. Nessa configuração, os embeddings ficam ao lado dos campos estruturados, e uma única consulta pode verificar permissões, filtrar registros por data e status e depois ranqueá-los por proximidade semântica. A troca é simples: em escala moderada, isso simplifica bastante a infraestrutura, mas na casa dos bilhões de vetores sistemas especializados como Pinecone ou Milvus ainda são mais rápidos. Já para centenas de milhares ou alguns milhões de vetores, essa abordagem costuma ser o ponto de partida mais pragmático.
O que isso significa
A conclusão principal é simples: o vector store é uma parte importante da stack de IA, mas não a substitui por inteiro. Se o produto lida com usuários, acessos, dinheiro e estado do sistema, não dá para dispensar um banco relacional. Para a maioria das equipes, um início sensato é PostgreSQL com pgvector, ou uma combinação de SQL com um banco vetorial separado, em que cada tecnologia cuida apenas da classe de tarefas que resolve melhor. Quanto mais cedo essa separação aparecer na arquitetura, menor a chance de a demo desmoronar no primeiro crescimento real.
Perguntas frequentes sobre a notícia
Onde o vector store é forte?
Os bancos vetoriais se tornaram peça padrão dos sistemas RAG porque resolvem uma tarefa que o SQL comum faz mal: buscar por significado, e não por correspondência exata de palavras. Quando o usuário faz uma pergunta, o sistema a transforma em um embedding e procura os trechos de documentos mais próximos em significado. Assim, a IA pode encontrar textos relevantes mesmo quando eles não usam as mesmas palavras da consulta. Isso é especialmente útil com dados não estruturados: documentos internos, correspondências, PDFs e bases de conhecimento. Se alguém pergunta sobre os dire
Onde o SQL é necessário?
O problema é que a flexibilidade da busca vetorial a torna, ao mesmo tempo, uma ferramenta imprecisa para tarefas operacionais. Ela responde bem à pergunta "o que é parecido em significado", mas serve mal quando é preciso uma resposta firme, sem probabilidades nem margens. Assim que o produto passa a ter usuários, limites, pagamentos e status de objetos, a busca aproximada começa a atrapalhar em vez de ajudar. Por isso, em um sistema de produção o banco relacional continua sendo o lugar onde vivem todos os "fatos concretos": permissões de acesso e fronteiras entre tenants,
O que se sabe sobre Um esquema híbrido?
O autor propõe não escolher entre as duas abordagens, mas combiná-las em uma única camada de dados. Um cenário típico é este: primeiro o banco relacional verifica o usuário, seu papel e a lista de documentos aos quais ele tem acesso, e só depois o vector store busca correspondências semânticas dentro desse subconjunto seguro. Para assistentes de IA corporativos, isso não é otimização, e sim uma fronteira de segurança. Sem esse pré-filtro, o sistema corre o risco de mostrar ao usuário dados de outra equipe ou até de outro cliente. O padrão inverso também funciona. Depois que
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.