Qdrant e DRAG with KNEE: como tornar o RAG adaptativo sem desperdiçar tokens
Uma nova análise ataca o principal desequilíbrio do RAG clássico: ou o modelo recebe pouco contexto, ou recebe um paredão de texto de que não precisa. A abordagem DRAG with KNEE, baseada em Qdrant e Python, organiza os documentos em hierarquia, procura um ponto de inflexão na relevância e corta a cauda de trechos irrelevantes. A ideia é dar ao modelo exatamente o contexto que cada consulta exige.
Processado por IA de Habr AI; editado por Hamidun News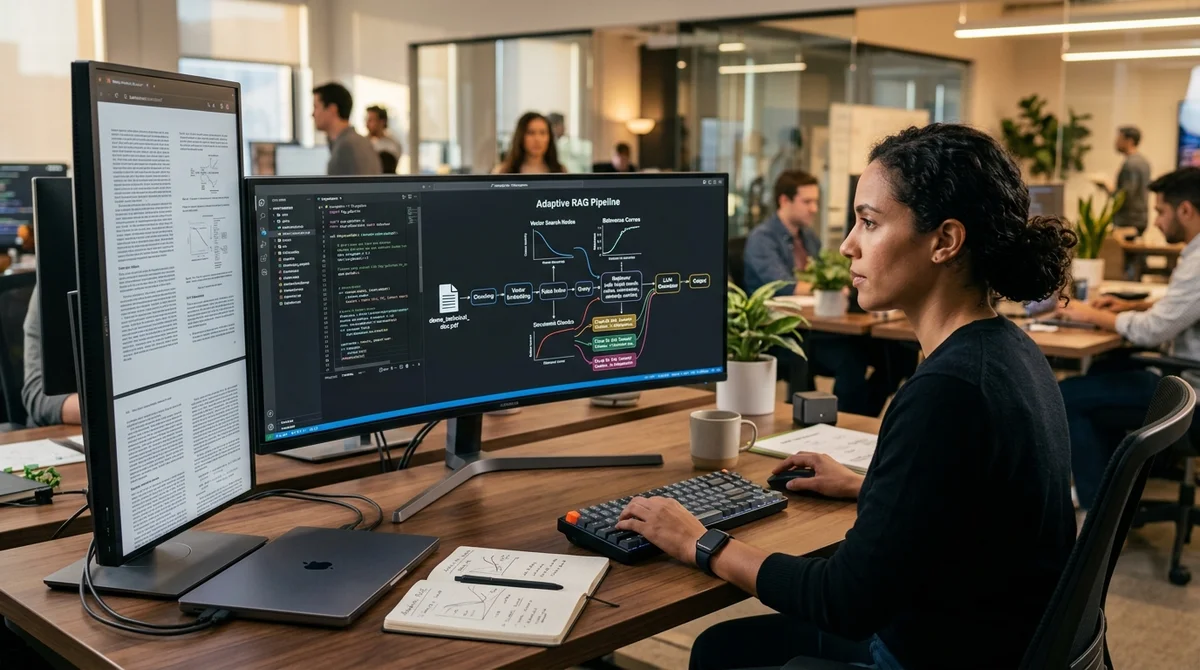
Saiu uma análise prática sobre como tornar um sistema RAG menos gastador e mais preciso. O foco é o DRAG with KNEE, uma abordagem baseada em Qdrant e Python que define o volume de contexto dinamicamente, em vez de usar um top_k fixo.
Por que o top_k estático falha
Quase todo mundo que montou um RAG sobre PDFs longos enfrentou o mesmo problema. Se vierem poucos chunks, o modelo não enxerga contexto importante e começa a inventar. Se vierem demais, o prompt se enche de ruído, e com ele crescem o custo, a latência e o risco de o LLM se agarrar a um trecho aleatório. Nesse esquema, um único parâmetro top_k tenta resolver tarefas muito diferentes e quase sempre se sai mal.
O autor chama esse dilema de fraqueza fundamental do RAG clássico. Um número fixo de documentos ignora o tipo de consulta, a estrutura do arquivo de origem e a densidade de informação útil no corpus. Para um fato curto, um par de trechos pode bastar; para uma pergunta complexa sobre um documento de várias páginas, não. O resultado: o sistema ou deixa o modelo com pouco contexto ou o sobrecarrega com texto irrelevante e queima o orçamento de tokens.
Como funciona o DRAG
A ideia do DRAG with KNEE é não apenas buscar pedaços semelhantes, mas primeiro olhar os documentos como uma hierarquia e depois decidir dinamicamente onde parar a seleção. Em vez de um limite rígido, o algoritmo analisa a distribuição de relevância e procura um ponto de inflexão, o "joelho" a partir do qual cada trecho adicionado traz cada vez menos valor. Tudo o que fica na longa cauda depois desse ponto pode ser descartado sem perda perceptível de sentido.
Na prática, é uma estratégia de extração de contexto mais adaptativa. O sistema não precisa devolver o mesmo número de chunks para toda consulta: às vezes serão três, outras dez, outras vários grupos relacionados de partes diferentes do documento. Assim, o RAG se ajusta à estrutura real do conhecimento, e não a uma constante escolhida de antemão.
- Primeiro, os candidatos são encontrados por similaridade vetorial
- Depois, são agrupados e ordenados por documentos e níveis
- Em seguida, o algoritmo procura o ponto em que a utilidade começa a cair bruscamente
- Só o núcleo relevante, sem a longa cauda de ruído, entra no contexto final
Essa abordagem é especialmente útil quando o conhecimento não está numa base de FAQ organizada, mas em instruções dispersas, relatórios, regulamentos e PDFs grandes. Nesses corpora, as distâncias entre trechos dizem pouco por si sós se não se considera como eles se relacionam e com que rapidez seu valor para a resposta despenca. É aí que a análise geométrica deixa de ser enfeite matemático e vira um filtro prático.
Por que Qdrant
Um ponto positivo do artigo é que ele não se perde na teoria pura. O autor mostra como montar esse pipeline com Qdrant e Python, um stack conhecido, já usado em muitos projetos de RAG. O Qdrant cuida da busca vetorial e do trabalho com os candidatos, e a lógica do DRAG with KNEE adiciona por cima uma camada de adaptação: não só achar o que é semelhante, mas entender quanto disso o modelo realmente precisa agora.
Para times que já implantaram um retrieval comum e esbarraram na qualidade das respostas ou no custo de inferência, é um sinal importante. O problema pode não estar nos embeddings nem no próprio LLM, mas em como o contexto é cortado e entregue. Trocar o top_k estático por um corte dinâmico no ponto de inflexão pode reduzir o ruído e melhorar a precisão ao mesmo tempo, sem refazer a arquitetura.
O que isso significa
O RAG vai deixando para trás o ajuste grosseiro de um parâmetro para todos os casos. O material sobre o DRAG with KNEE mostra uma mudança simples, mas importante: o próximo nível de qualidade vem não só de uma boa busca, mas de saber parar na hora certa, para que o LLM receba contexto suficiente para responder, e não um excesso aleatório de texto.
Perguntas frequentes sobre a notícia
Por que o top_k estático falha?
Quase todo mundo que montou um RAG sobre PDFs longos enfrentou o mesmo problema. Se vierem poucos chunks, o modelo não enxerga contexto importante e começa a inventar. Se vierem demais, o prompt se enche de ruído, e com ele crescem o custo, a latência e o risco de o LLM se agarrar a um trecho aleatório. Nesse esquema, um único parâmetro top_k tenta resolver tarefas muito diferentes e quase sempre se sai mal. O autor chama esse dilema de fraqueza fundamental do RAG clássico. Um número fixo de documentos ignora o tipo de consulta, a estrutura do arquivo de origem e a densidad
Como funciona o DRAG?
A ideia do DRAG with KNEE é não apenas buscar pedaços semelhantes, mas primeiro olhar os documentos como uma hierarquia e depois decidir dinamicamente onde parar a seleção. Em vez de um limite rígido, o algoritmo analisa a distribuição de relevância e procura um ponto de inflexão, o "joelho" a partir do qual cada trecho adicionado traz cada vez menos valor. Tudo o que fica na longa cauda depois desse ponto pode ser descartado sem perda perceptível de sentido. Na prática, é uma estratégia de extração de contexto mais adaptativa. O sistema não precisa devolver o mesmo número
Por que Qdrant?
Um ponto positivo do artigo é que ele não se perde na teoria pura. O autor mostra como montar esse pipeline com Qdrant e Python, um stack conhecido, já usado em muitos projetos de RAG. O Qdrant cuida da busca vetorial e do trabalho com os candidatos, e a lógica do DRAG with KNEE adiciona por cima uma camada de adaptação: não só achar o que é semelhante, mas entender quanto disso o modelo realmente precisa agora. Para times que já implantaram um retrieval comum e esbarraram na qualidade das respostas ou no custo de inferência, é um sinal importante. O problema pode não estar
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.