Raft analisa onde MCP e Thin MCP adicionam latência extra aos agentes de IA
A equipe da Raft analisou onde exatamente os agentes de IA perdem velocidade ao trabalhar via MCP. Os testes mostraram que o MCP em si adiciona cerca de 10 ms dentro do processo, e que a maior parte da queda vem da rede, da serialização e de saltos desnecessários entre serviços. O Thin MCP simplifica a arquitetura, mas não garante ganho de velocidade. Os melhores resultados vieram de um esquema assíncrono e de uma organização mais cuidadosa dos serviços de backend.
Processado por IA de Habr AI; editado por Hamidun News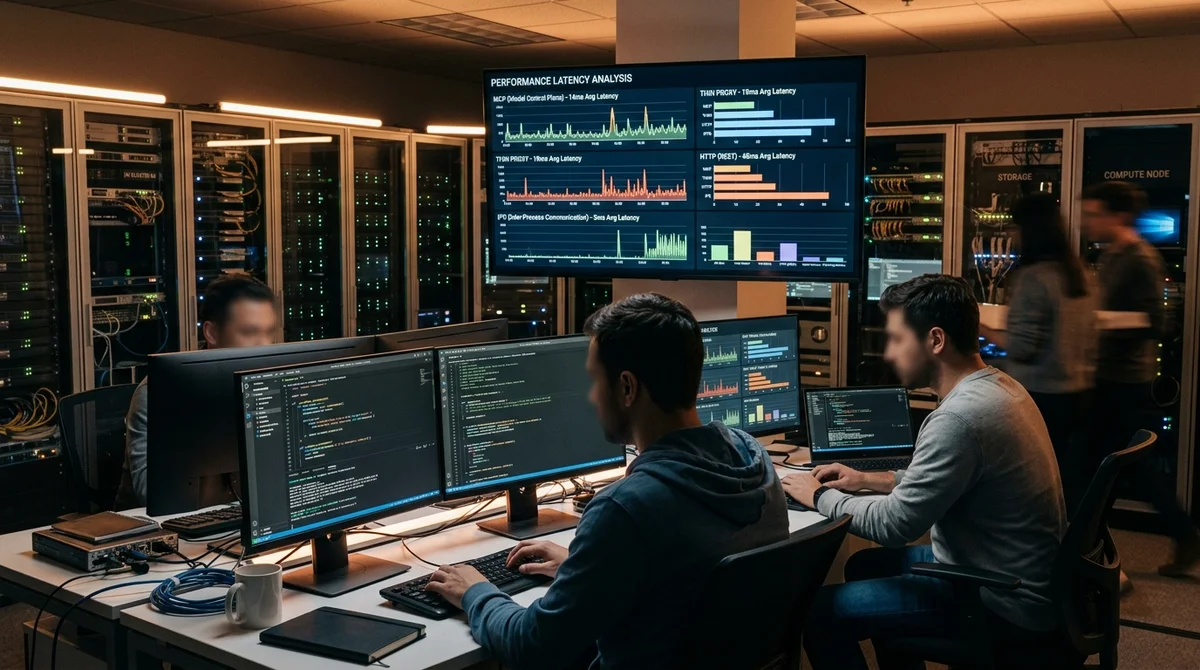
O MCP costuma ser apresentado como uma forma universal de conectar ferramentas a um aplicativo com LLM de maneira organizada, mas na prática essa modularidade custa latência. Em uma nova análise, a Raft comparou várias arquiteturas e mostrou que o problema geralmente não está em um componente específico, e sim em como todo o caminho da requisição é montado, do agente até a ferramenta e de volta.
De onde vem a latência
O autor começou com uma pergunta básica: quanta latência o MCP em si adiciona se a rede for removida e tudo ficar em um único processo? Para descobrir, comparou um monólito sem MCP com um monólito com MCP in-process. O padrão se mostrou de overhead relativamente pequeno: em média cerca de 10–11 ms, às vezes até 35 ms. É um ponto de partida importante: se um agente trava por centenas de milissegundos, o culpado geralmente não é o uso do MCP em si, mas a camada externa ao redor dele.
Em seguida, a comparação foi levada para uma arquitetura mais realista, em que os servidores MCP rodam em contêineres Docker separados. Aqui o quadro muda de forma perceptível: a latência adicional média das principais ferramentas subiu para cerca de 169 ms por chamada. Ainda assim, os traces mostraram que nem isso é o maior consumidor de tempo. Os trechos mais pesados são a obtenção de embeddings e o trabalho do reranker, enquanto a busca no banco de dados vetorial leva comparativamente pouco. Em outras palavras, o MCP adiciona um custo, mas nem sempre é o principal gargalo da cadeia.
O que os testes mostraram
O artigo examina vários cenários para separar a influência do transporte, da serialização e do próprio runtime.
- S1, MCP in-process: cerca de 10–11 ms de latência adicional, ou seja, o runtime em si é relativamente leve.
- S2, MCPs separados via rede Docker: em média cerca de 169 ms de overhead por chamada, por causa da rede, da serialização e da comunicação entre processos.
- S3a, Thin MCP via HTTP + JSON: em uma série de medições o overhead caiu para cerca de 128 ms, mas o resultado foi instável e, em execuções repetidas, podia ser bem pior.
- S3b, Thin MCP via HTTP + YAML: a latência subiu para cerca de 274 ms, o que indica o custo adicional de serialização e desserialização.
- S4 e S5: o ZeroMQ entregou cerca de 200 ms, mas com comportamento mais previsível, enquanto um runtime em C++ reduziu o overhead para aproximadamente 130–145 ms, sem uma mudança radical na ordem de grandeza.
A principal conclusão desses números é que otimizações intuitivas nem sempre funcionam como se espera. Trocar JSON por YAML não acelerou o sistema; piorou. A migração de HTTP para IPC também não foi uma vitória automática: a implementação com iceoryx2 não mostrou o ganho esperado, e só a variante com ZeroMQ se mostrou mais útil na prática, graças ao modelo assíncrono. Até o C++ ajudou de forma moderada, não dramática.
Por que o thin não resolve
No artigo, o Thin MCP não aparece como um botão mágico de aceleração, mas como uma forma de simplificar a arquitetura. Nesse esquema, a camada de proxy fica mínima e apenas traduz as chamadas, enquanto a lógica de negócio vai para serviços HTTP separados. A abordagem dá independência de linguagem, facilita o escalonamento e permite escrever executores em Go, Rust ou C++, mesmo que ainda não exista um SDK completo de MCP para eles.
O
Thin MCP é mais uma ferramenta de arquitetura do que uma forma de otimizar latência.
Há uma ressalva prática: a abordagem thin pode parecer mais rápida em uma execução e não se reproduzir de forma estável em outra. Para um sistema em produção isso é crítico: às vezes importa mais um comportamento previsível sob carga repetida do que o melhor p95 pontual. Por isso a Raft chega a uma conclusão bastante dura, mas útil: se a ideia é realmente acelerar um agente de IA, não basta trocar a linguagem ou o protocolo. É preciso reconstruir o esquema de interação entre o proxy, os componentes de backend e as etapas pesadas de computação.
O que isso significa
Para equipes que constroem agentes de IA, é um bom antídoto contra a otimização superficial. Se o sistema está lento, é preciso olhar primeiro para o número de saltos entre componentes, as operações bloqueantes, o modelo de execução concorrente e as etapas pesadas, como embeddings e reranking. O Thin MCP pode deixar o sistema mais limpo e flexível, e C++ ou IPC podem render algum ganho adicional, mas o efeito decisivo só aparece quando a própria arquitetura deixa de fazer a requisição passar por camadas desnecessárias.
Perguntas frequentes sobre a notícia
O que se sabe sobre De onde vem a latência?
O autor começou com uma pergunta básica: quanta latência o MCP em si adiciona se a rede for removida e tudo ficar em um único processo? Para descobrir, comparou um monólito sem MCP com um monólito com MCP in-process. O padrão se mostrou de overhead relativamente pequeno: em média cerca de 10–11 ms, às vezes até 35 ms. É um ponto de partida importante: se um agente trava por centenas de milissegundos, o culpado geralmente não é o uso do MCP em si, mas a camada externa ao redor dele. Em seguida, a comparação foi levada para uma arquitetura mais realista, em que os servidores
O que os testes mostraram?
O artigo examina vários cenários para separar a influência do transporte, da serialização e do próprio runtime. S1, MCP in-process: cerca de 10–11 ms de latência adicional, ou seja, o runtime em si é relativamente leve. S2, MCPs separados via rede Docker: em média cerca de 169 ms de overhead por chamada, por causa da rede, da serialização e da comunicação entre processos. S3a, Thin MCP via HTTP + JSON: em uma série de medições o overhead caiu para cerca de 128 ms, mas o resultado foi instável e, em execuções repetidas, podia ser bem pior. S3b, Thin MCP via HTTP + YAML: a la
Por que o thin não resolve?
No artigo, o Thin MCP não aparece como um botão mágico de aceleração, mas como uma forma de simplificar a arquitetura. Nesse esquema, a camada de proxy fica mínima e apenas traduz as chamadas, enquanto a lógica de negócio vai para serviços HTTP separados. A abordagem dá independência de linguagem, facilita o escalonamento e permite escrever executores em Go, Rust ou C++, mesmo que ainda não exista um SDK completo de MCP para eles. O Thin MCP é mais uma ferramenta de arquitetura do que uma forma de otimizar latência. Há uma ressalva prática: a abordagem thin pode parecer mai
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.