Claude não salva um briefing ruim: por que a IA entrega resultados convincentes, mas fracos
Um prompt grande não garante uma boa resposta. Usando o Claude como exemplo, o autor explica que a IA costuma entregar texto plausível, e não um resultado realmente útil, quando a tarefa não foi destrinchada antes. O mínimo prático são quatro perguntas antes de começar: o que existe de entrada, quais etapas são necessárias, qual deve ser a saída de cada passo e como é a aceitação final. A conclusão é direta: a IA amplifica tanto boas decisões quanto uma má definição da tarefa.
Processado por IA de Habr AI; editado por Hamidun News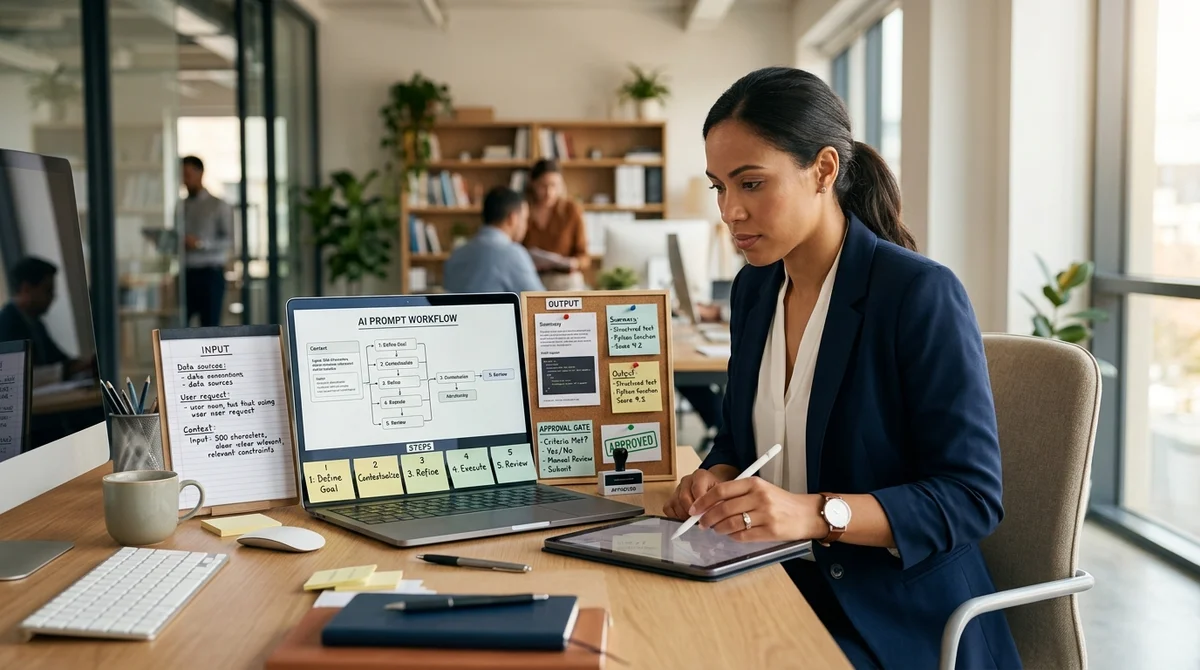
Prompts grandes, papéis e encantamentos como think carefully não garantem uma boa resposta da IA. Com base no trabalho com o Claude, o autor analisa por que o modelo muitas vezes acelera a produção de texto plausível, mas não chega a um resultado útil quando a própria tarefa não está definida.
Por que isso não funciona
A principal crítica é simples: a IA raramente questiona uma definição ruim. Um designer, analista ou desenvolvedor normalmente voltaria com perguntas de esclarecimento, mas o modelo costuma completar sozinho o contexto que falta e entregar uma resposta confiante. Por isso, o usuário tem a impressão de que o trabalho anda rápido, quando na verdade o que se acelera não é a produção de um resultado de qualidade, e sim a de um texto que parece convincente. Daí vem o cansaço depois de longas iterações: você gasta uma hora reescrevendo algo que deveria ter saído na primeira ou na segunda tentativa.
"Prompt não é oração."
O autor relaciona isso a uma inversão no custo das ações. Antes, fazer era caro, enquanto pensar e discutir era relativamente barato. Agora a IA gera em segundos cinco versões de uma análise, de um texto ou de uma estratégia, e discutir a tarefa com uma equipe de várias pessoas passa a ser a parte mais cara do processo. Isso cria a ilusão de que dá para pular a definição adequada da tarefa e ir direto para a geração. Mas um prompt longo não substitui um objetivo claro, e fórmulas mágicas não curam a falta de estrutura.
Quatro perguntas antes do chat
Em vez de procurar a formulação perfeita, o autor propõe retomar a disciplina básica da análise de negócios e montar um mapa da tarefa antes de começar. A lógica se baseia na abordagem As-Is, To-Be, Gap: o que temos agora, qual deve ser o resultado e o que separa um do outro. Esse esqueleto é útil não só para pesquisas complexas, mas também para tarefas do dia a dia, como análise de concorrentes, preparação da estrutura de um artigo ou revisão de entrevistas com usuários. O ponto é descrever não uma esperança vaga de uma boa resposta, mas um caminho concreto até ela.
- Entrada: quais dados, links, documentos, hipóteses e observações você já tem no início.
- Etapas: quais ações o modelo deve executar, em ordem, sem um "analise" vago.
- Saída de cada etapa: o que exatamente deve resultar de cada passo — tabela, lista, matriz, rascunho.
- Resultado final: como é o trabalho pronto e por qual critério você o aceitará sem a sensação de "parece ok".
Na prática, isso muda também o formato da interação com o modelo. Em vez de um único prompt gigante, é melhor montar um pipeline de vários passos com aceite intermediário: primeiro a coleta de fatos, depois a comparação, em seguida a busca por segmentos vazios e só então as conclusões. No exemplo da análise de concorrentes, essa abordagem transforma um pedido abstrato em uma sequência de tarefas pequenas, em que é mais fácil pegar um erro antes do que no texto final.
Como isso é montado no Claude
Para uso próprio, o autor empacotou essa abordagem em uma skill dedicada do Claude. Primeiro ela verifica o que realmente se precisa: uma resposta pontual ou um prompt para reutilização. Em seguida vem o mapa As-Is, To-Be, Gap, e depois o sistema avalia a completude do pedido por alguns elementos obrigatórios — objetivo, público, formato, restrições e contexto. Se faltam dados, o modelo não gera de imediato um texto bonito, mas faz perguntas de esclarecimento.
O passo-chave é o Confirmation Gate: antes de trabalhar, a IA mostra como entendeu a tarefa e aguarda confirmação explícita. Depois, o prompt final é montado em um template estruturado no esquema Context, Role, Instructions, Style, Parameters. O autor destaca separadamente a importância de restrições negativas, exemplos few-shot e iteração pontual sobre um erro específico, em vez de se guiar pela sensação de que "melhorou". Se o resultado ficou genérico demais, o que se deve corrigir não é o clima do pedido, mas a regra: adicionar métricas, proibir frases banais, exigir um formato de resposta claro. Esse modo aproxima o prompting não de um palpite criativo, mas de um ajuste de engenharia do processo.
O que isso significa
A conclusão principal é dura, mas útil: a IA amplifica não só boas decisões, mas também uma definição ruim da tarefa. Para as equipes, é um sinal para parar de medir eficiência pelo número de versões geradas e começar a exigir um mapa da tarefa, aceite intermediário e critérios de conclusão. Quanto mais barata fica a geração, mais cara fica a clareza de raciocínio — e é ela que agora traz o maior ganho.
- 2 de nov. de 2026Agente de LLM montou um redutor no KOMPAS-3D, mas tirou 50 em 100 na lista de materiais
- 2 de nov. de 2026Agentes ignoraram a dica de ler a memória em 7 de 7 sessões: análise de 13 mil logs
- 2 de nov. de 2026Karpathy montou em duas horas, com o Claude Code, o catálogo HackerTube com 6 454 vídeos
- 2 de nov. de 2026Verificamos 929 automações na Alpina: como deve ser o treinamento corporativo em IA em 2026
Perguntas frequentes sobre a notícia
Por que isso não funciona?
A principal crítica é simples: a IA raramente questiona uma definição ruim. Um designer, analista ou desenvolvedor normalmente voltaria com perguntas de esclarecimento, mas o modelo costuma completar sozinho o contexto que falta e entregar uma resposta confiante. Por isso, o usuário tem a impressão de que o trabalho anda rápido, quando na verdade o que se acelera não é a produção de um resultado de qualidade, e sim a de um texto que parece convincente.
O que se sabe sobre Quatro perguntas antes do chat?
Em vez de procurar a formulação perfeita, o autor propõe retomar a disciplina básica da análise de negócios e montar um mapa da tarefa antes de começar. A lógica se baseia na abordagem As-Is, To-Be, Gap: o que temos agora, qual deve ser o resultado e o que separa um do outro. Esse esqueleto é útil não só para pesquisas complexas, mas também para tarefas do dia a dia, como análise de concorrentes, preparação da estrutura de um artigo ou revisão de entrevistas com usuários.
Como isso é montado no Claude?
Para uso próprio, o autor empacotou essa abordagem em uma skill dedicada do Claude. Primeiro ela verifica o que realmente se precisa: uma resposta pontual ou um prompt para reutilização. Em seguida vem o mapa As-Is, To-Be, Gap, e depois o sistema avalia a completude do pedido por alguns elementos obrigatórios — objetivo, público, formato, restrições e contexto. Se faltam dados, o modelo não gera de imediato um texto bonito, mas faz perguntas de esclarecimento.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.