DeepSeek e Gemma: como um experimento de LLM híbrido no Kaggle quebrou a biblioteca Transformers
No Kaggle, tentaram algo quase impossível: pegar os pesos de 31B do Gemma, transplantá-los para o esqueleto MoE do DeepSeek e rodar o híbrido sem retreinamento. Para isso, foi preciso aplicar patches no Transformers, contornar uma falha de inicialização dos pesos de 4 bits e procurar à mão os especialistas escondidos. O modelo resultante fala de forma desconexa, mas o experimento mostra até onde dá para ir com PyTorch, Hugging Face e um conjunto de gambiarras.
Processado por IA de Habr AI; editado por Hamidun News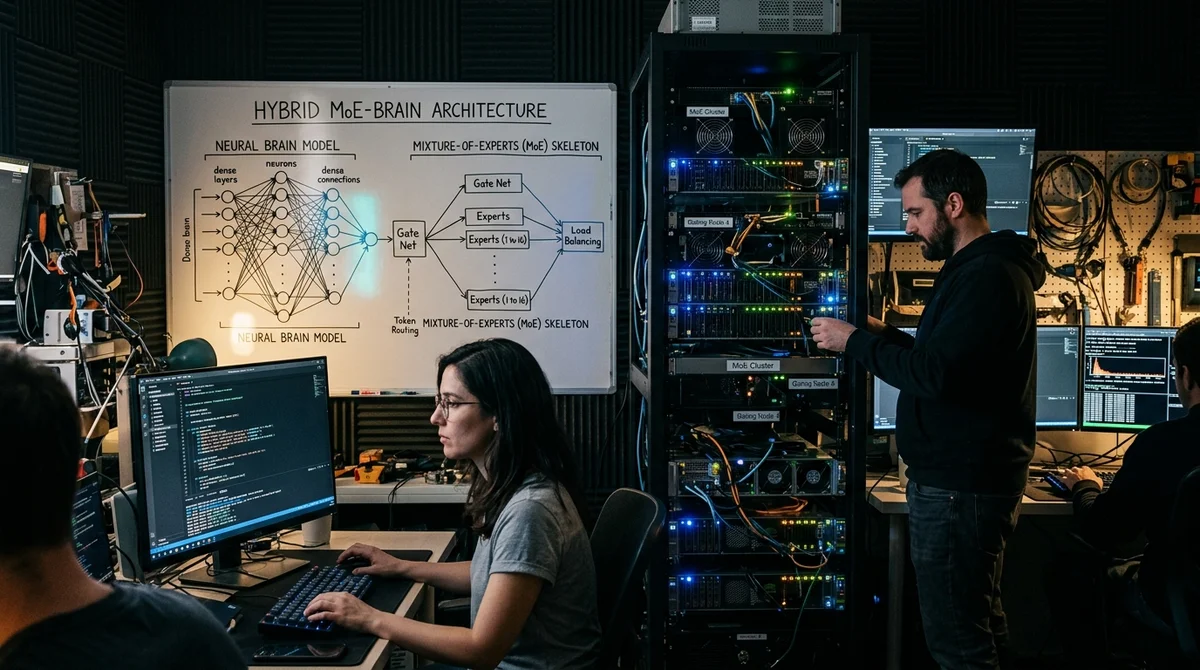
Um grupo de entusiastas montou um LLM híbrido quase contra as regras: pegaram quatro camadas do modelo Gemma de 31B e as encaixaram numa arquitetura MoE vazia do DeepSeek-V4, sem retreinamento. Não saiu dali um concorrente funcional do ChatGPT, mas o processo mostrou até que ponto dá para forçar o PyTorch e o Transformers para testar uma ideia extrema.
Por que um híbrido
A ideia nasceu de restrições muito duras: duas GPUs T4 gratuitas no Kaggle, cerca de 30 GB de RAM e nenhum orçamento para um fine-tuning completo. Em vez de treinar, os autores decidiram testar um cenário mais bruto: a fusão estrutural de modelos. O doador foi o Gemma-4-31B, comprimido para o formato NF4 de 4 bits, e o "esqueleto" foi um DeepSeek-V4 vazio com roteador Mixture-of-Experts. A tarefa soava quase como um meme: transplantar parte dos pesos de uma arquitetura para outra e ver se a quimera chegava a ganhar vida.
Do ponto de vista da engenharia, o projeto era interessante não pela qualidade das respostas, mas pelo fato da compatibilidade em si. Gemma e DeepSeek têm dimensões diferentes, lógica de normalização própria, blocos de attention distintos e regras próprias para rotear tokens entre especialistas. Nos manuais, esse tipo de transplante costuma ser considerado impossível sem projeções intermediárias e retreinamento. Os autores quebraram essa regra de propósito e montaram um experimento de sobrevivência para as bibliotecas: o que falharia primeiro, o modelo, a memória do Kaggle ou a própria pilha da Hugging Face.
Onde tudo desmoronou
A primeira falha veio já na carga. O Transformers se recusou a reconhecer direito o tipo personalizado gemma4 e depois travou com o erro dict.to_dict(), porque um módulo interno serializava a configuração como um dicionário comum e logo tentava tratá-lo como objeto. Para seguir adiante, os autores registraram o tipo manualmente em CONFIG_MAPPING e acrescentaram um monkey patch para GenerationConfig que envolve o dicionário em um objeto proxy em tempo de execução. Sem isso, toda a operação acabava antes de o híbrido ser criado.
Em seguida, a biblioteca tentou inicializar as áreas vazias do DeepSeek com ruído aleatório, chamando normal_. Aí o PyTorch lançou um NotImplementedError: os pesos do doador tinham sido carregados via bitsandbytes em 4 bits e armazenados como uint8, enquanto o gerador de distribuição normal trabalha com tensores float. O problema foi resolvido do jeito mais direto: interceptaram TORCH_INIT_FUNCTIONS["normal_"] e proibiram a função de mexer em tensores de bytes. Não é uma correção bonita, e sim um desvio cirúrgico, mas sem ele o transplante nem começava.
A parte mais chata foram os especialistas do DeepSeek e a memória. Os blocos MoE não estavam num ModuleList comum, e sim dentro de uma classe personalizada que não dá para percorrer simplesmente com um laço. Além disso, desempacotar uma camada de 31B do Gemma na RAM do Kaggle levava quase instantaneamente a um OOM. Para contornar, os autores escreveram um "sonar" recursivo que procura as subcamadas necessárias pelos atributos gate_proj, up_proj e down_proj, e transferiram os pesos em microlotes pela CPU, distribuindo os modelos entre duas GPUs e chamando o coletor de lixo o tempo todo.
"No aprendizado de máquina não existem muros de arquitetura intransponíveis."
Como o modelo foi costurado
O script final reduziu toda a operação a uma sequência de patches rígidos e cópias de pesos. Para cada uma das quatro camadas, ele ajustava as matrizes ao tamanho da camada de destino, completando-as com zeros quando necessário, transplantava separadamente as projeções de attention e, também separadamente, os componentes MLP de cada especialista encontrado. Depois de cada cópia grande, a memória era limpa na hora. Após o transplante, os autores ainda tiveram de reescrever o roteador MoE para que, durante a inferência, o modelo não travasse por conflito de dimensões e conseguisse gerar ao menos algum texto.
Os principais passos técnicos foram estes:
- Registro da configuração personalizada do Gemma no registro global do Transformers
- Monkey patch para
GenerationConfigque sobrevive ao errodict.to_dict() - Bloqueio de
normal_para pesosuint8de 4 bits - Busca recursiva de especialistas e transferência de matrizes em microlotes pela CPU
O teste da quimera deu o resultado esperado: o modelo realmente iniciou, mas gerou texto desconexo, uma mistura de tokens aleatórios e fragmentos de frases. Para os autores, ainda assim foi um sucesso, porque o objetivo não era a qualidade das respostas, e sim demonstrar o princípio. Eles não alinharam os vocabulários, não treinaram projeções de transição nem fizeram fine-tuning após o transplante, então um fluxo caótico de tokens na saída era quase inevitável. Mesmo assim, o experimento provou que os limites de arquitetura muitas vezes não são um muro, mas uma longa lista de problemas de baixo nível que podem ser contornados com código.
O que isso significa
Experimentos assim não criam um produto pronto, mas mostram bem os limites dos LLMs open source atuais. Se pesos, quantização, roteamento e hidden states puderem ser encaixados, ao menos em parte, sem retreinamento, abre-se espaço para híbridos mais práticos, com projeções adequadas, adaptação de vocabulário e ajuste posterior. Para os desenvolvedores, é um sinal: a pilha em torno dos modelos ainda é frágil, e isso significa que o espaço para montagens fora do padrão só cresce.
- 18 de nov. de 2026Tencent Hy4 flash marcou 2,79 de 4 contra 2,81 do Haiku 5.5 e custa 18 vezes menos por tarefa
- 18 de nov. de 2026Ajuste fino de modelo NER eleva de 39,5% para 91,8% a taxa de segredos comerciais totalmente ocultados
- 18 de nov. de 2026Após banimento, autor roda equipe de agentes no Kimi, Codex e OpenCode: execução a partir de US$ 0,30
- 18 de nov. de 2026Qwen em dois DGX Spark fica 34–59% mais rápido em tokens por segundo e supera o GLM
Perguntas frequentes sobre a notícia
Por que um híbrido?
A ideia nasceu de restrições muito duras: duas GPUs T4 gratuitas no Kaggle, cerca de 30 GB de RAM e nenhum orçamento para um fine-tuning completo. Em vez de treinar, os autores decidiram testar um cenário mais bruto: a fusão estrutural de modelos. O doador foi o Gemma-4-31B, comprimido para o formato NF4 de 4 bits, e o "esqueleto" foi um DeepSeek-V4 vazio com roteador Mixture-of-Experts.
Onde tudo desmoronou?
A primeira falha veio já na carga. O Transformers se recusou a reconhecer direito o tipo personalizado gemma4 e depois travou com o erro dict.to_dict(), porque um módulo interno serializava a configuração como um dicionário comum e logo tentava tratá-lo como objeto. Para seguir adiante, os autores registraram o tipo manualmente em CONFIG_MAPPING e acrescentaram um monkey patch para GenerationConfig que envolve o dicionário em um objeto proxy em tempo de execução.
Como o modelo foi costurado?
O script final reduziu toda a operação a uma sequência de patches rígidos e cópias de pesos. Para cada uma das quatro camadas, ele ajustava as matrizes ao tamanho da camada de destino, completando-as com zeros quando necessário, transplantava separadamente as projeções de attention e, também separadamente, os componentes MLP de cada especialista encontrado. Depois de cada cópia grande, a memória era limpa na hora.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.