PageIndex, da VectifyAI, propõe busca sem embeddings para documentos longos
O PageIndex, da VectifyAI, propõe outra forma de lidar com documentos longos: em vez de chunks e banco vetorial, o sistema monta um sumário hierárquico com resumos e entrega ao LLM só as páginas necessárias. A ideia funciona bem para PDFs financeiros, jurídicos e técnicos, mas a precisão tem preço: mais tokens, menos velocidade e pouca escalabilidade em grandes coleções de documentos.
Processado por IA de Habr AI; editado por Hamidun News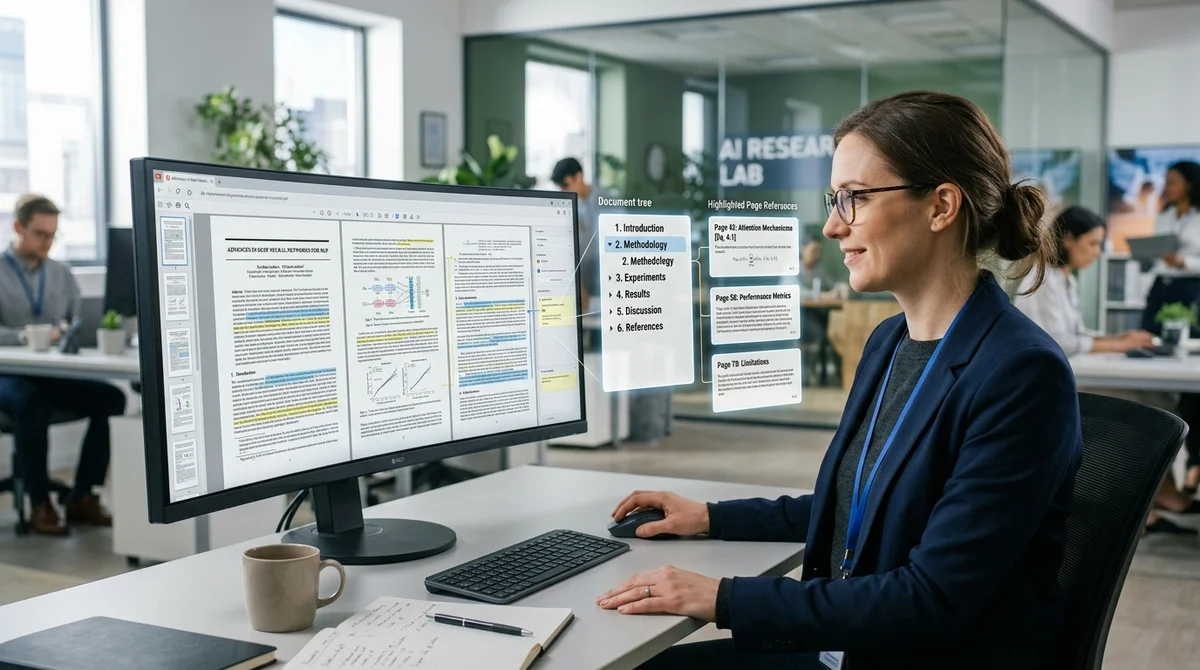
O PageIndex é um dos novos candidatos mais visíveis ao posto de "RAG sem banco vetorial". Em vez do esquema tradicional com embeddings e chunks, o sistema monta um sumário hierárquico do documento, com descrições curtas de cada seção, e depois pede a um LLM que escolha, por raciocínio, os nós relevantes e as páginas associadas a eles. A abordagem soa nova e, em PDFs longos e bem estruturados, pode de fato funcionar mais perto de como uma pessoa lê um documento.
Como o PageIndex funciona
A mecânica do PageIndex é relativamente simples. Primeiro, o documento é dividido por páginas. Em seguida, o modelo e um código auxiliar montam um TOC expandido: uma árvore de seções com títulos, intervalos de páginas e um resumo para cada nó. Quando chega uma pergunta, o prompt não recebe o documento inteiro nem um conjunto de trechos aleatórios, e sim essa estrutura. O LLM escolhe os ramos relevantes da árvore, e só as páginas vinculadas a eles entram na consulta final. Assim, o sistema dispensa embeddings, armazenamento vetorial e o chunking artificial, que muitas vezes quebra o sentido nas fronteiras entre fragmentos.
Por que o projeto desperta interesse
É exatamente por isso que o PageIndex chama tanta atenção. Em relatórios financeiros longos, documentos jurídicos, manuais técnicos e materiais didáticos, a abordagem parece natural: uma pessoa também costuma começar pelo sumário, e não vasculhando o texto pedaço por pedaço. No repositório do projeto, os desenvolvedores da VectifyAI posicionam o sistema explicitamente como reasoning-based retrieval e afirmam que ele ajudou a atingir 98,7% de precisão no FinanceBench. Para equipes que trabalham com um único documento grande ou com uma pequena coleção de PDFs complexos, isso soa como uma alternativa forte ao pipeline de RAG tradicional, sobretudo para quem quer uma busca mais interpretável, com referências claras a seções e páginas.
Onde a abordagem esbarra no limite
Mas a grande questão não é se dá para trocar a busca vetorial pelo PageIndex, e sim onde estão os limites dessa abordagem. As críticas aqui são bem pé no chão. Primeiro, o TOC também precisa ser armazenado em algum lugar, especialmente quando há mais de um documento, então falar em "totalmente sem índice" é um pouco enganoso.
Segundo, ainda não há uma estratégia convincente de seleção de documentos para grandes coleções: metadados, keyword search, TF-IDF e BM25 continuam em cena e muitas vezes seguem como um primeiro filtro barato. Terceiro, o reasoning retrieval é quase inevitavelmente mais caro em tokens e mais lento no tempo de resposta. Se um bom RAG vetorial já entrega cerca de 90% de qualidade, os pontos percentuais extras de precisão podem custar várias vezes mais — e nem todo produto se beneficia dessa troca.
Limitações práticas e como rodar
Na prática, as limitações também aparecem. A análise aponta que o PageIndex se saiu mal com texto literário sem estrutura explícita: se o documento não tem seções nem títulos, simplesmente não há base para montar um "sumário inteligente". Com texto acadêmico, os resultados foram melhores, porque ali existe uma hierarquia de seções de verdade.
Dá para rodar o sistema localmente a partir do repositório aberto: basta instalar as dependências, configurar a chave de API de um LLM compatível via LiteLLM e passar um PDF ou markdown pelo run_pageindex.py. Mas há ressalvas: o autor alerta especificamente sobre a versão do LiteLLM, não recomenda instalar o pacote pageindex do pip, voltado à nuvem, para uso local, e relata que, com modelos locais fracos, a qualidade da árvore cai visivelmente, e o processo pode levar dezenas de minutos mesmo em um documento relativamente pequeno.
O que isso significa na prática
O que isso significa na prática? O PageIndex não parece um matador da busca vetorial, mas parece uma nova camada útil na arquitetura de RAG. Faz mais sentido encará-lo não como substituto direto, e sim como uma ferramenta especializada para documentos longos e estruturados, em que explicabilidade, precisão de navegação e trabalho por páginas importam. O cenário mais realista é o híbrido: primeiro uma busca barata por metadados ou vetores, depois o PageIndex para escolher as seções com precisão. Esse meio-termo reflete melhor a realidade: ainda não surgiu um substituto universal para o RAG vetorial, mas abordagens document-first como o PageIndex já têm um nicho claro.
Resumindo:
- O PageIndex, da VectifyAI, é um "RAG sem banco vetorial": monta um sumário hierárquico e pede ao LLM que escolha os nós e as páginas relevantes.
- O sistema dispensa embeddings e chunking; os desenvolvedores afirmam ter atingido 98,7% de precisão no FinanceBench.
- É mais realista tratar o PageIndex como uma camada para documentos longos e estruturados dentro de um esquema híbrido, e não como substituto do RAG vetorial.
- 2 de nov. de 2026EDU-Jev 4B avalia trabalhos de alunos com 67,6% de precisão e supera APIs comerciais em 9,4 p.p.
- 28 de out. de 2026Anthropic revela como constrói o Claude com o próprio Claude: cérebro separado das mãos
- 28 de out. de 2026Bayer lança mecanismo multiagente no AgentCore: 80% das dúvidas sem engenheiros
- 28 de out. de 2026Liquid AI lança o LFM2.5-24B-A2B: um modelo para agentes com 2B de parâmetros ativos
Perguntas frequentes sobre a notícia
Como o PageIndex funciona?
A mecânica do PageIndex é relativamente simples. Primeiro, o documento é dividido por páginas. Em seguida, o modelo e um código auxiliar montam um TOC expandido: uma árvore de seções com títulos, intervalos de páginas e um resumo para cada nó. Quando chega uma pergunta, o prompt não recebe o documento inteiro nem um conjunto de trechos aleatórios, e sim essa estrutura. O LLM escolhe os ramos relevantes da árvore, e só as páginas vinculadas a eles entram na consulta final. Assim, o sistema dispensa embeddings, armazenamento vetorial e o chunking artificial, que muitas vezes
Por que o projeto desperta interesse?
É exatamente por isso que o PageIndex chama tanta atenção. Em relatórios financeiros longos, documentos jurídicos, manuais técnicos e materiais didáticos, a abordagem parece natural: uma pessoa também costuma começar pelo sumário, e não vasculhando o texto pedaço por pedaço. No repositório do projeto, os desenvolvedores da VectifyAI posicionam o sistema explicitamente como reasoning-based retrieval e afirmam que ele ajudou a atingir 98,7% de precisão no FinanceBench. Para equipes que trabalham com um único documento grande ou com uma pequena coleção de PDFs complexos, isso
Onde a abordagem esbarra no limite?
Mas a grande questão não é se dá para trocar a busca vetorial pelo PageIndex, e sim onde estão os limites dessa abordagem. As críticas aqui são bem pé no chão. Primeiro, o TOC também precisa ser armazenado em algum lugar, especialmente quando há mais de um documento, então falar em "totalmente sem índice" é um pouco enganoso. Segundo, ainda não há uma estratégia convincente de seleção de documentos para grandes coleções: metadados, keyword search, TF-IDF e BM25 continuam em cena e muitas vezes seguem como um primeiro filtro barato. Terceiro, o reasoning retrieval é quase in
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.