Como montar o pipeline Netflix Void para remover objetos de vídeos com o CogVideoX
Um novo guia mostra como montar um pipeline do Void para remover objetos de vídeos com base no CogVideoX. O material cobre a configuração do ambiente, o download do modelo base e do checkpoint, a preparação de sample inputs e a execução de toda a cadeia de inferência com prompts personalizados. Para equipes de pós-produção de vídeo, o ponto útil é que não se trata de uma demo, mas de um fluxo de trabalho reproduzível localmente.
Processado por IA de MarkTechPost; editado por Hamidun News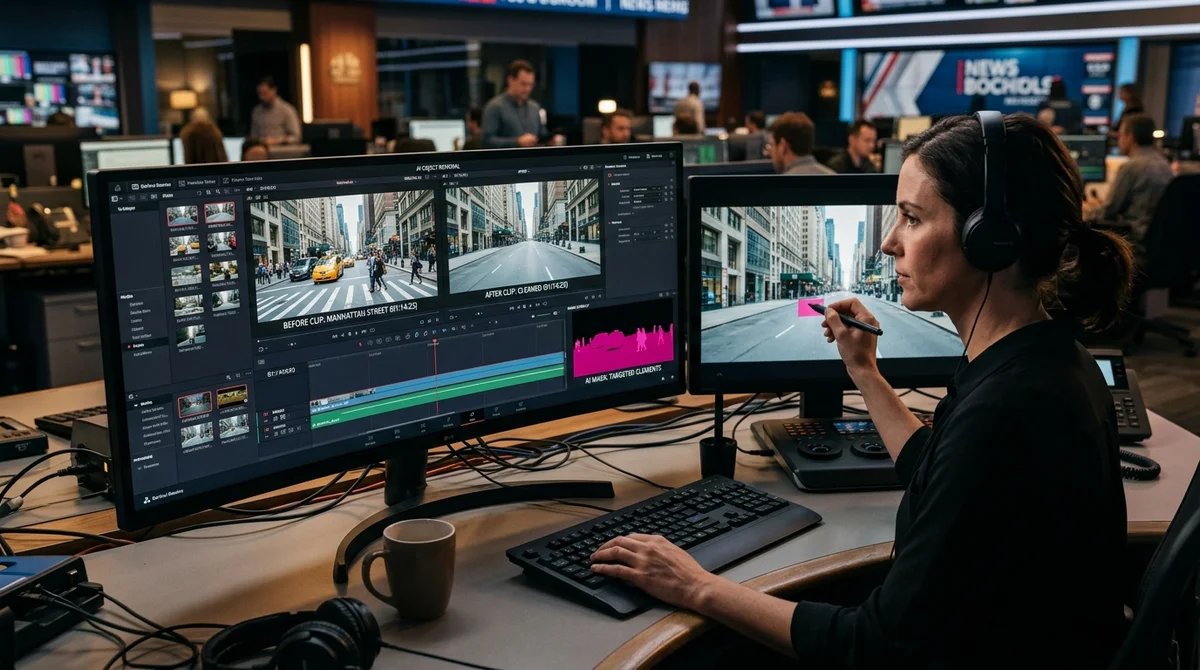
Um novo guia mostra em detalhes como montar um pipeline funcional para remover objetos de vídeos com o modelo Void, da Netflix: da instalação das dependências e do download dos pesos até a execução da cadeia completa de inferência com prompts personalizados e exemplos prontos. Para equipes que trabalham com pós-produção, edição generativa e edição de vídeo, o principal não é a demonstração de qualidade em si, mas um processo reproduzível que pode ser subido localmente, testado com dados de teste e adaptado à própria produção.
O foco do material é o modelo Void, voltado a tarefas de video object removal e inpainting, ou seja, remover objetos indesejados do quadro e depois reconstruir o fundo e o movimento para que o resultado pareça natural de um quadro para o outro. Nesses cenários, restaurar um único frame não basta: se o fundo treme, as texturas flutuam e a iluminação muda aos saltos, o espectador percebe a intervenção na hora. Por isso o guia usa o CogVideoX combinado a um checkpoint separado. O modelo de vídeo base cuida da dinâmica geral da cena, enquanto o ajuste especializado ajuda a resolver com mais precisão a edição local sem estragar o restante do vídeo.
Na prática, é um guia de engenharia completo. Primeiro, prepara-se o ambiente, instalam-se todas as dependências necessárias e clona-se o repositório. Depois, é preciso baixar o modelo base oficial e o checkpoint do Void e preparar os sample inputs para uma execução de teste: o vídeo original, uma máscara ou outros artefatos de entrada que indiquem qual objeto deve ser removido.
Essa ordem importa de verdade, não só na forma. Na inferência de vídeo, a maioria das falhas não surge na arquitetura do modelo, mas na junção entre versões de bibliotecas, estrutura de diretórios, formatos de arquivo, limites de memória de vídeo e caminhos de pesos escritos errado.
O guia dá ênfase especial aos prompts personalizados e a uma inferência de exemplo completa, de ponta a ponta. Isso é crítico porque a qualidade do vídeo final depende não só da máscara, mas de como o modelo interpreta a cena após a edição: que fundo deve aparecer no lugar do objeto removido, como o movimento de câmera continua, quais elementos devem ser preservados sem alteração e com que cuidado os pequenos detalhes são restaurados.
O material também destaca uma forma mais prática de interagir com o pipeline, por meio de uma entrada segura de parâmetros no estilo terminal. Para uma equipe de engenharia, isso significa execuções mais previsíveis, menos rotina manual e automação mais conveniente em tarefas repetitivas de edição de vídeo.
O interesse por esses sistemas não é por acaso. O vídeo virou um formato central para marketing, treinamento, mídia e demonstrações de produto, e cresceu a demanda por ferramentas que tirem rapidamente do quadro objetos indesejados, reflexos, logotipos, pedestres aleatórios ou artefatos técnicos sem retoque manual quadro a quadro. Mais importante ainda, os modelos generativos estão passando aos poucos de demos impressionantes para ferramentas de produção. Nesse contexto, importam não só a qualidade da saída, mas também a repetibilidade do resultado, uma instalação clara, uma configuração transparente e a possibilidade de integrar a solução a um pipeline de processamento de conteúdo existente. Guias como este aceleram a adoção mais do que anúncios barulhentos.
A principal conclusão é que o guia mostra não uma ideia abstrata de pesquisa, mas um esquema de edição de vídeo com IA quase pronto para produção. Quando passos de instalação, dependências, pesos, lógica de execução e exemplos de teste são descritos juntos, a tecnologia fica visivelmente mais perto do uso real. Se o ecossistema em torno do Void e do CogVideoX continuar evoluindo, a barreira de entrada para remover objetos de vídeos com qualidade vai cair para estúdios, equipes de produto e serviços de edição automatizada. Para o mercado, é um sinal claro: o video inpainting está deixando rapidamente de ser um recurso experimental para virar uma ferramenta de trabalho.
- 2 de nov. de 2026Cosmos gerou vídeo de treinamento para drones: o mAP@50–95 do detector subiu 10,3%
- 2 de nov. de 2026Karpathy montou em duas horas um clone do YouTube com 6454 vídeos indicados no Hacker News
- 2 de nov. de 2026Karpathy usa o Claude para criar o HackerTube, com 6454 vídeos recomendados no Hacker News
- 2 de nov. de 2026Jornalista da The Verge monta um rival do Meta Muse Charm por $50 com ajuda do Claude Code
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.