Claude Code e 11 agentes: como um time de QA automatizou até 80% da rotina de testes
Em vez de contratar mais dois testadores, um time de QA montou um sistema de 11 agentes sobre o Claude Code. Ele analisa Jira e Confluence, monta cenários seguindo o ISTQB, escreve autotestes de API e UI e abre sozinho um Merge Request. No piloto de um mês e meio, a regressão passou de 50 para 400 casos, e a verificação de novas funcionalidades caiu de dias para horas.
Processado por IA de Habr AI; editado por Hamidun News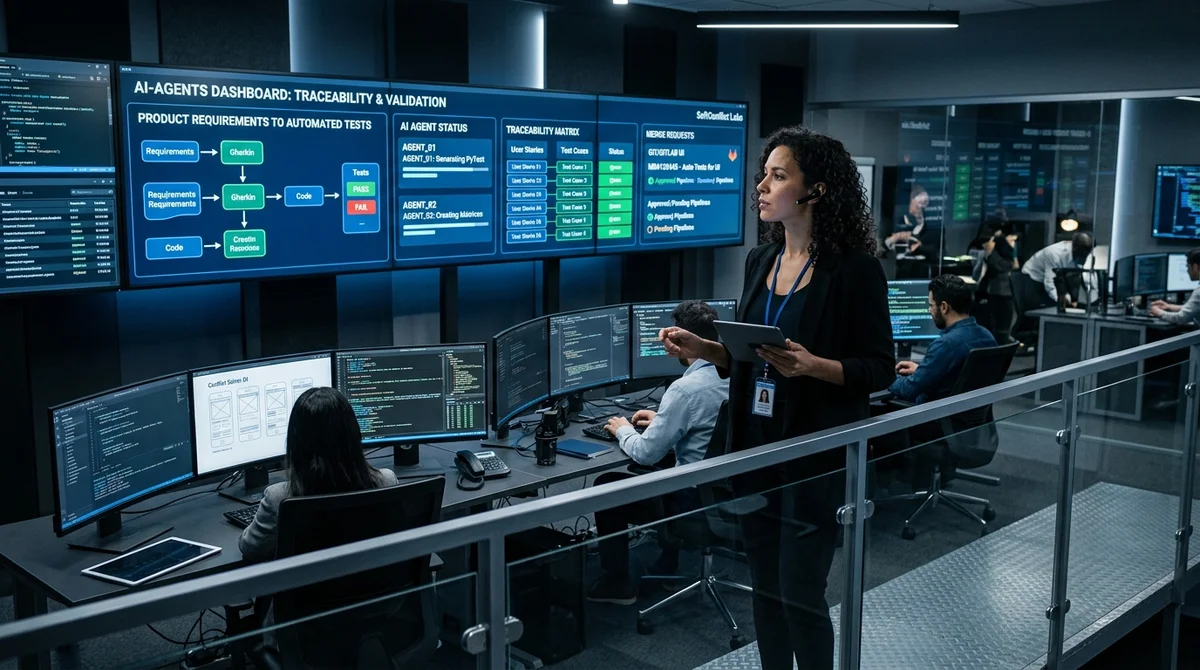
Um time de QA mostrou que agentes de IA já conseguem assumir boa parte da rotina de testes: da leitura de requisitos e do desenho de cenários até o carregamento de casos de teste em um TMS e a abertura de um Merge Request com autotestes prontos. Em vez de ampliar a equipe com mais dois testadores, o time montou sobre o Claude Code um "exoesqueleto" de 11 agentes especializados e afirma que ele cobre até 80% do trabalho operacional de um engenheiro de QA.
O ponto de partida foi um problema comum em times de produto: o desenvolvimento entrega novas funcionalidades mais rápido do que o teste consegue transformar requisitos em cenários, dados e automação. Pela estimativa interna, cerca de 20% do tempo de QA vai para análise de requisitos e design de testes, outros 15% para criar casos no TMS, 10% para preparar dados e 25% para automação, e só depois vêm as verificações em si, a regressão e os relatórios. No total, até 80% da carga pode ser descrita por regras e dividida em etapas repetíveis.
Daí a ideia: não substituir o engenheiro, mas transformá-lo em operador de um pipeline, que define a tarefa, controla os artefatos e só intervém onde falta contexto ao sistema ou quando é preciso tomar uma decisão ambígua.
A arquitetura é uma cadeia modular de 11 skills mais um orquestrador separado. Um agente puxa a tarefa do Jira e os materiais relacionados do Confluence, outro decompõe os requisitos em User Stories e tarefas, e um terceiro gera cenários de teste seguindo as regras do ISTQB. Os seguintes cuidam de dados ausentes, divergências, seletores DOM, autotestes de API e UI, comparação dos cenários com o código, carregamento dos casos no Zephyr Scale e criação do Merge Request no GitLab.
Como fonte única de verdade, usam-se cenários em JSON com rastreabilidade completa até os requisitos e os critérios de aceite, e, em paralelo, é construída uma matriz de cobertura RTM. Na parte de frontend, o sistema ainda consulta o Figma via MCP e extrai não só capturas de tela, mas a estrutura da interface, os estados e as restrições dos elementos.
Houve ênfase especial em qualidade e em proteção contra as fraquezas típicas dos LLMs. Depois da geração dos cenários, o orquestrador passa por pontos de controle de qualidade: verifica o esquema JSON, a completude dos passos, as prioridades, a ausência de duplicatas e a cobertura dos requisitos. Depois da geração dos autotestes, o controle fica ainda mais rígido: validam-se o código Python, as fixtures e a própria execução dos testes.
A depuração usa um esquema em duas etapas. Primeiro, o sistema roda cada teste isoladamente e separa os problemas do código de teste dos defeitos reais do produto. Em seguida entra o teste de mutação: num teste que já passou, o assert é invertido, e, se mesmo assim ele continua verde, é considerado vazio e precisa de ajustes.
Outra camada importante é um protocolo de divergências entre Jira, Figma, o texto dos requisitos e o comportamento real da interface. Conflitos óbvios são resolvidos automaticamente por uma hierarquia de prioridade das fontes, e os casos controversos sobem para o engenheiro.
Na prática, o piloto entregou em um mês e meio os números pelos quais esses experimentos costumam ser lançados. O total de casos de regressão cresceu de cerca de 50 para 400, o detalhamento dos cenários ficou completo e a cobertura da regressão por automação chegou perto de 100%. A regressão em si caiu de cerca de um dia para dezenas de minutos, o caminho entre o fim do desenvolvimento e a aprovação do QA passou de alguns dias para algumas horas, e conectar os testes a um novo projeto agora leva cerca de quatro horas de configuração, em vez de meses de contratação e adaptação.
Além disso, o sistema passou a encontrar mais contradições ocultas nos requisitos e mais bugs do que o processo manual. A versão piloto roda numa assinatura Claude Pro de 100 dólares por mês e, segundo se afirma, consegue atender 2–3 projetos com mais de 100 testes por mês cada um.
A principal conclusão do caso é que o papel do QA de fato começa a migrar da execução manual para a gestão de contexto, regras e qualidade das decisões tomadas pela IA. Mas a história só funciona sob algumas condições: os requisitos precisam ser razoavelmente completos, o projeto deve ter uma boa fonte de contexto, como contratos de API e dados de teste, e o próprio pipeline não pode ser uma "caixa-preta". O valor não está na geração mágica de testes, e sim numa cadeia transparente de passos que pode ser reexecutada, verificada e reforçada aos poucos.
Se essa abordagem decolar além dos pilotos, o mercado de testes pode ganhar não um substituto para os engenheiros, mas um formato de trabalho muito mais produtivo e escalável.
- 20 de nov. de 2026Daydream lança estilista de IA que compra sozinho roupas de 10 000 marcas
- 20 de nov. de 2026Orca ensina bots a verificar projetos sozinhos a cada 4 horas e traz 24 templates
- 20 de nov. de 2026Desenvolvedor publica 30 skills de SEO para Claude Code e Cursor e servidores MCP
- 20 de nov. de 2026Suporte com agentes de IA fez seu próprio relatório em 17 horas com assinatura de $20
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.