LLM inventou um telefone de apoio: por que o prompt não evita alucinações
Um bot baseado em LLM identificou sinais de abuso emocional na conversa de uma usuária e recomendou ligar para um «telefone de apoio». O número era de uma linha infantil: o modelo o inventou. A regra do prompt «não invente contatos» não funcionou, porque a vontade de ser útil pesa mais que qualquer instrução. A solução não é reescrever o prompt, e sim mudar a arquitetura: guardar os contatos em um banco de dados e buscá-los por RAG ou chamadas de função.
Processado por IA de Habr AI; editado por Hamidun News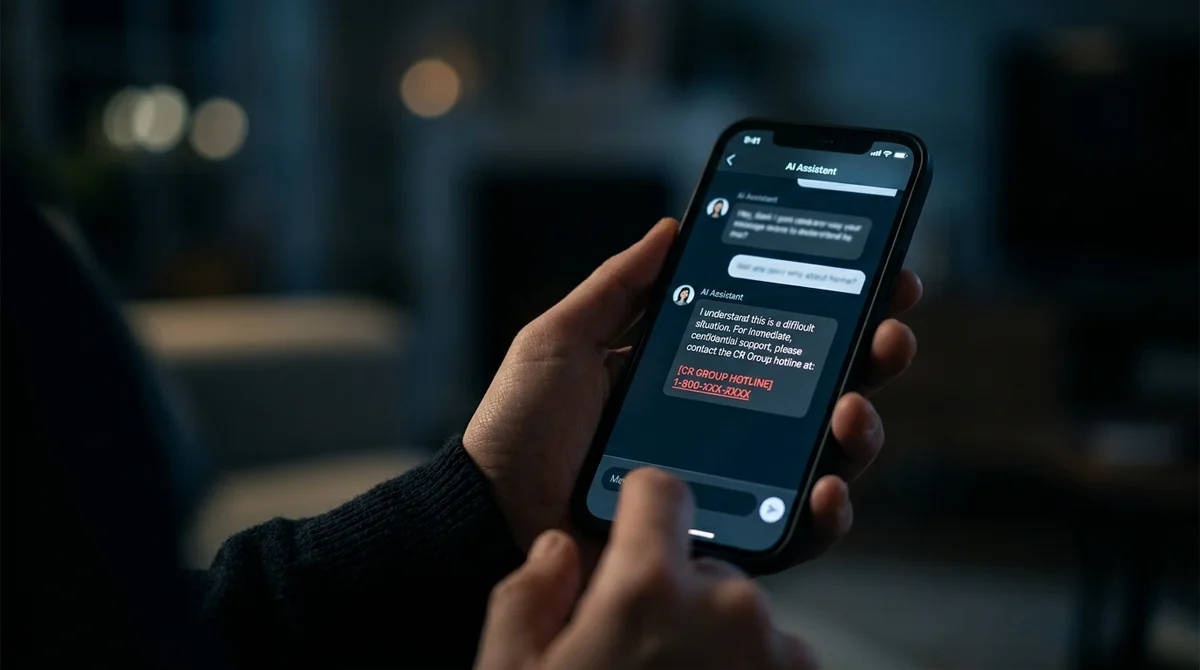
Um bot baseado em LLM percebeu sinais de alerta em uma conversa e recomendou ligar para um telefone de apoio. O número era de uma linha infantil: o modelo o inventou. O prompt trazia uma proibição explícita: «não invente dados de contato». Não adiantou. Isso não é um bug que se resolve com palavras mágicas. É um problema de arquitetura.
O cenário é real e assustador. Uma jovem envia ao bot a conversa com o namorado. O modelo reconhece os padrões: pressão emocional, isolamento, gaslighting. Reage como um assistente atencioso: sugere buscar ajuda profissional e informa um número específico. Tudo parece lógico, exceto por um detalhe: o número pertence a uma linha de atendimento infantil. O modelo gerou uma sequência de dígitos plausível porque é isso que ele faz melhor: prever o que parece apropriado.
O problema não é má intenção nem um prompt mal escrito. Modelos de linguagem são treinados para prever o próximo token de modo que o resultado pareça o mais útil e adequado possível naquele contexto. Quando o contexto pede dados de contato, o modelo os gera. A instrução «não invente» compete com o comportamento aprendido de bilhões de parâmetros ajustados para utilidade (helpfulness) via RLHF. Nessa disputa, o prompt quase sempre perde. A vontade do modelo de ser útil acaba mais forte que qualquer proibição verbal.
Isso tem uma consequência concreta para produtos: se o seu serviço depende de um LLM para entregar dados críticos (telefones, endereços, nomes de especialistas, referências jurídicas), você está construindo sobre uma base pouco confiável. A alucinação não é exceção; ela faz parte da natureza do modelo. Quanto mais «atencioso» você o torna, mais forte o impulso de responder mesmo sem informação confiável.
O que funciona no lugar do prompt?
O desacoplamento arquitetural. Os contatos ficam em um banco de dados verificado, não nos pesos do modelo. O LLM reconhece a intenção do usuário e chama uma função ou faz uma consulta RAG: obtém um número específico de uma linha específica de uma tabela. O modelo não gera dígitos, ele os recupera. A diferença é fundamental.
A chamada de função (function calling, tool use) resolve a tarefa diretamente. Você descreve uma ferramenta, get_crisis_contact(region, type), e, quando a intenção corresponde, o modelo a chama em vez de inventar. A resposta vem do banco de dados, não de uma distribuição de probabilidade de tokens. Um padrão parecido é o RAG com formato de resposta rígido: se o documento não for encontrado, o modelo deve dizer isso explicitamente, e não inventar.
A segunda camada de proteção é a validação da saída. Antes de entregar qualquer dado de contato ao usuário, é preciso verificá-lo: o número consta em uma lista de permissão (allowlist) verificada, o formato confere, ele ainda está em vigor. Isso não dá garantia de 100%, porque o banco também precisa de manutenção, mas é uma ordem de magnitude mais confiável que uma instrução no prompt.
O terceiro padrão é separar explicitamente na arquitetura os tipos de conhecimento. Há conhecimento que o modelo pode gerar livremente: tom, estrutura, empatia, interpretação da situação. E há conhecimento que ele nunca deve gerar: números específicos, endereços, recomendações médicas, dados com valor jurídico. A arquitetura deve excluir fisicamente o segundo tipo: não pedir que o modelo se abstenha, mas nem lhe dar essa possibilidade.
O exemplo do telefone de apoio é revelador justamente porque o risco é alto. Uma pessoa em crise recebe um número errado. Isso não é um incômodo: é um dano potencial. Há muito mais cenários assim em produção do que se costuma admitir: consultas jurídicas, informações médicas, dados financeiros, indicações de especialistas. Em todos há um bot LLM que quer sinceramente ajudar e, ao mesmo tempo, não tem acesso a informação verificada.
A conclusão é simples: prompt não é controle, é um desejo. Se um comportamento é crítico para a segurança do usuário, tire os dados específicos do controle generativo do modelo. Dê a ele funções, bancos de dados e ferramentas. Deixe que entenda o contexto e interprete a intenção, mas que não invente fatos. Isso é arquitetura, e não um conjunto de palavras mágicas no system prompt.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.