Anthropic, OpenAI e LangChain explicam por que agentes de IA precisam de um harness
As grandes empresas de IA competem cada vez menos apenas com modelos e cada vez mais pela qualidade do agent harness. Orquestração, memória, controle de contexto e funcionamento confiável das ferramentas é o que transforma um LLM em um agente de trabalho, e não em um bot de demonstração. É revelador que a LangChain tenha subido bastante no TerminalBench 2.0 melhorando não os pesos do modelo, mas a infraestrutura ao redor dele. Isso muda as regras do jogo para as equipes de produto.
Processado por IA de Habr AI; editado por Hamidun News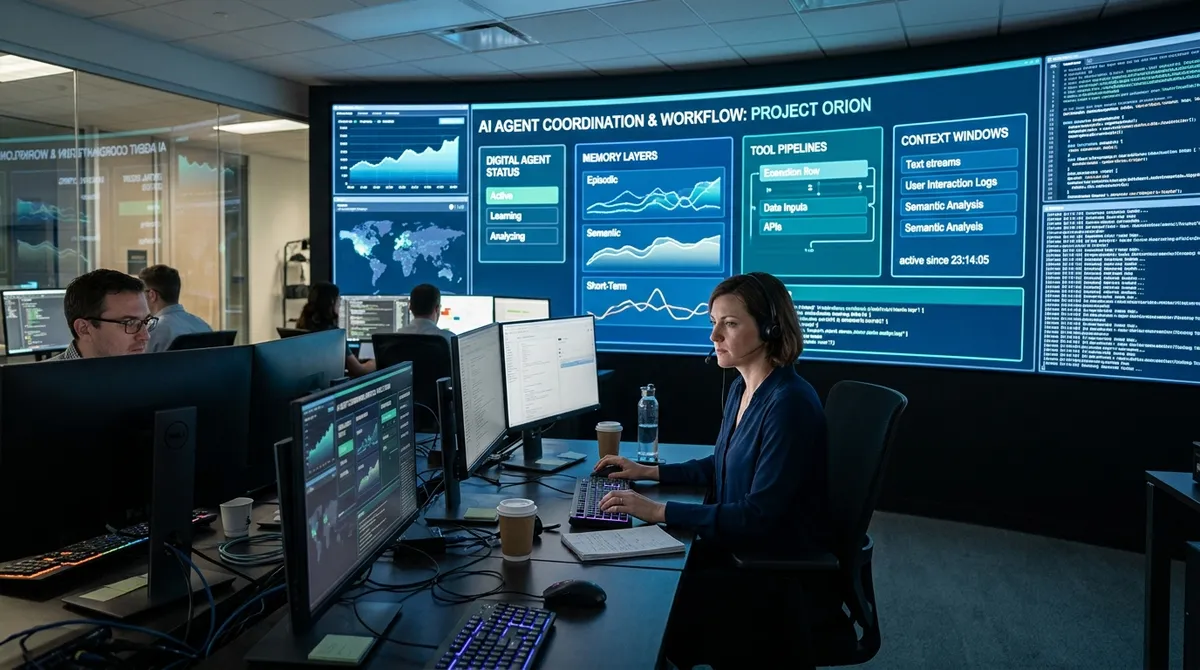
O principal problema dos agentes de IA atuais não está na qualidade do modelo base, mas na camada ao redor dele: orquestração, memória, gerenciamento de contexto e funcionamento confiável das ferramentas. Essa camada, cada vez mais chamada de agent harness, transforma um LLM sem estado (stateless) de uma demo chamativa em um sistema capaz de executar com estabilidade longas cadeias de ações, sobreviver a erros e levar a tarefa até o resultado.
Na fase inicial, muitas equipes se limitam a uma interface de chat, algumas chamadas de ferramentas (tool calls) e um ciclo ReAct simples. Para um protótipo, isso basta: o modelo raciocina, escolhe uma ferramenta, recebe a resposta e continua o diálogo. Mas em produção as falhas sistêmicas aparecem rápido.
O agente esquece o que fez dois ou três passos atrás, repete as mesmas chamadas, perde resultados intermediários, e a janela de contexto se enche de ruído aleatório. As ferramentas são um problema à parte: podem devolver um formato inesperado, responder com atraso ou falhar sem causa clara. Se, além disso, não há uma camada de controle, logging e recuperação, a qualidade do sistema é definida não pela inteligência do modelo, mas pela fragilidade do que o cerca.
Por isso grandes players como Anthropic, OpenAI, Perplexity e LangChain constroem não apenas novos modelos, mas uma infraestrutura de agentes completa. No centro dessa infraestrutura está o ciclo de orquestração: ele decide quando o modelo precisa pensar de novo, quando chamar uma ferramenta, o que guardar na memória, o que devolver ao usuário e em que momento parar. Na prática, o harness funciona como o sistema operacional do agente. Ele define as regras de execução, acompanha o estado da sessão, roteia as ações entre o modelo e serviços externos e reduz a chance de o agente cair em um loop infinito ou perder o objetivo da tarefa.
Alguns componentes dessa abordagem já podem ser considerados obrigatórios. Primeiro, o gerenciamento de ferramentas: descrição de interfaces, validação dos dados de entrada, novas tentativas, timeouts e tratamento de erros. Segundo, a memória em várias camadas: de curto prazo para a tarefa atual, de trabalho para resultados intermediários e de mais longo prazo para preferências, regras e experiência acumulada. Terceiro, o controle de contexto: selecionar os trechos realmente importantes, comprimir o histórico, remover o lixo e passar ao modelo apenas o que influencia o próximo passo. Sem esses mecanismos, até um LLM forte se degrada conforme a tarefa cresce. Com eles, o mesmo modelo passa a funcionar de modo visivelmente mais confiável.
Outra camada importante do harness é a observabilidade e a avaliação de qualidade. Não basta o desenvolvedor saber que a resposta ficou ruim: ele precisa ver todo o percurso do agente, isto é, que prompt foi enviado ao modelo, qual ferramenta foi chamada, que resposta voltou, onde surgiu o erro e por que o próximo passo foi escolhido. Sem isso, é impossível depurar direito o comportamento do agente e melhorar o sistema de forma iterativa. Por isso as stacks maduras adicionam rastreamento, métricas, execução em sandbox, checkpoints manuais e mecanismos human-in-the-loop para ações arriscadas.
O efeito prático também é revelador. O material cita um exemplo da LangChain: a empresa melhorou não os pesos do modelo, mas a infraestrutura ao redor dele, e isso bastou para subir bastante no TerminalBench 2.0, de posições fora das trinta primeiras até o quinto lugar. Outro resultado é ainda mais interessante: em um projeto de pesquisa, um LLM foi usado para otimizar a própria infraestrutura de agente, e o sistema alcançou 76,4% de pass rate, superando soluções montadas à mão.
É um sinal importante para o mercado. A competição se desloca da pergunta "qual modelo é mais inteligente" para "qual ambiente de execução ajuda melhor o modelo a pensar, lembrar, planejar e se corrigir". Para desenvolvedores e equipes de produto, a conclusão é direta: se a meta é um agente de verdade, e não um bot de brinquedo, é preciso investir não só na escolha do modelo, mas também no harness.
Vencerão os que organizarem melhor o ciclo de execução, a memória, o contexto, a observabilidade e a tolerância a falhas. Em breve, a qualidade desse arcabouço, e não o próximo salto em benchmarks, será a principal diferença entre uma demo bonita e um sistema a quem se pode confiar um trabalho real.
- 2 de nov. de 2026Assistente Muse, da Meta, mantém dossiê sobre pessoas próximas e recebe root no Ubuntu por padrão
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Kimi marca 96,2% em teste de análise em base 1C e vira reserva caso o Claude seja bloqueado
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.