Desenvolvedores Java aprendem como guardrails para LLM bloqueiam injeções e respostas tóxicas
Um bom system prompt não basta: os usuários logo descobrem como contornar as restrições do modelo. O material sobre guardrails em Java apresenta uma abordagem mais confiável, com verificações antes e depois da chamada ao LLM que barram prompt injections, respostas tóxicas e cenários indesejados no nível do código. Isso é especialmente importante em serviços de produção, onde um erro do modelo vira um risco para o produto.
Processado por IA de Habr AI; editado por Hamidun News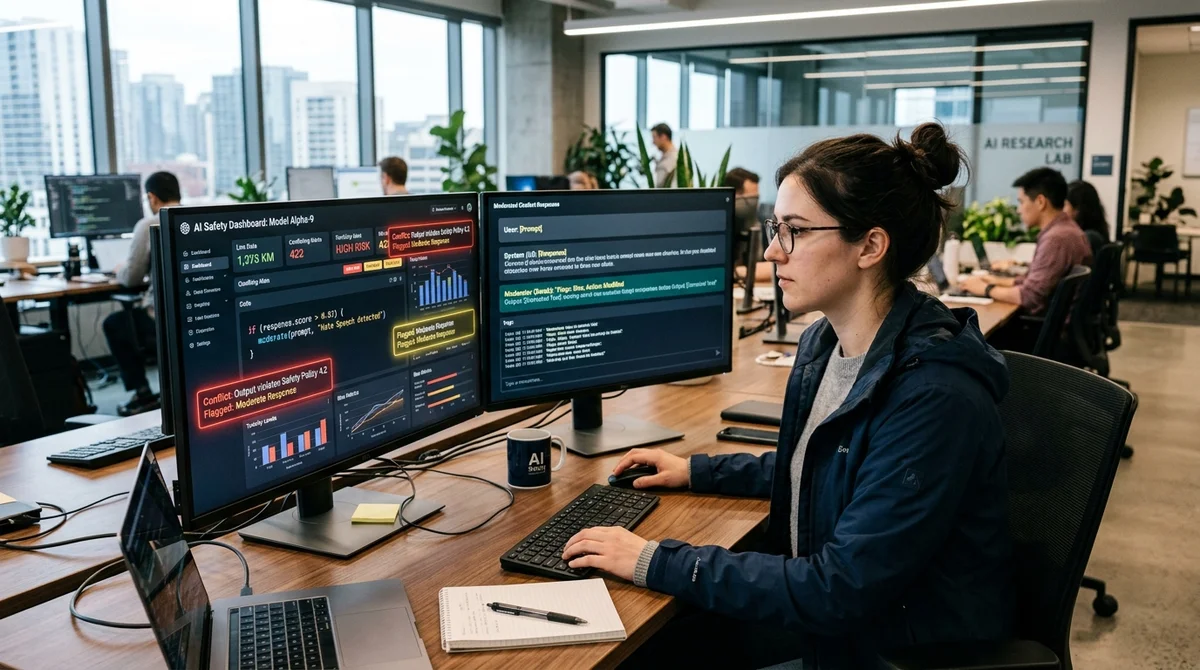
Uma proteção confiável para LLMs não começa com um system prompt perfeito, e sim com a decisão de não tratá-lo como uma barreira de segurança de verdade. Assim que o modelo chega à produção, fica claro que mensagens de usuários, contextos longos e formulações escolhidas a dedo rapidamente levam o LLM a ignorar ou reinterpretar as regras. Por isso, guardrails não devem ser mais um prompt, e sim uma camada de código que controla exatamente o que vai para o modelo e o que pode voltar para o produto.
A ideia central do material é simples: o system prompt é só uma instrução que o modelo tenta seguir, mas não é obrigado a cumprir incondicionalmente. Em demos curtas, essa abordagem ainda pode parecer convincente, mas em um serviço real surgem prompt injections, tentativas de extrair dados ocultos, contornos de restrições por meio de role-play e o simples acúmulo de contexto, que faz as regras originais perderem força. Se a aplicação depende apenas de instruções em texto dentro da própria requisição, na prática ela entrega o controle ao modelo e torce para que ele não erre no momento errado.
Os guardrails atacam o problema em outro nível. Eles atuam antes e depois da chamada ao modelo, ou seja, não pedem ao LLM que se comporte bem: limitam seu comportamento tecnicamente. Na entrada, é possível verificar se o texto do usuário tenta sobrescrever instruções, inserir comandos internos, extrair dados do sistema ou provocar um cenário proibido.
Para isso servem regras explícitas, classificação de risco, normalização da entrada, corte de contexto perigoso e separação de papéis, para que os dados do usuário não se misturem com as instruções internas da aplicação. Em Java, essa camada é especialmente útil quando o LLM é integrado a serviços corporativos, chatbots, assistentes de suporte e ferramentas internas com dados sensíveis. O controle da resposta é igualmente importante.
Mesmo que uma requisição perigosa chegue ao modelo, a aplicação não é obrigada a mostrar o resultado ao usuário do jeito que veio. Depois da geração, dá para checar a estrutura da resposta, passá-la por moderação e garantir que o texto não contenha toxicidade, vazamento de dados pessoais, conselhos proibidos ou desvio evidente do formato esperado. Se a resposta não passar na verificação, o sistema pode devolver uma mensagem padrão segura, pedir ao modelo que gere o texto de novo com parâmetros mais rígidos ou encaminhar o caso para tratamento manual.
Essa abordagem pesa ainda mais em produtos nos quais um erro do modelo se transforma imediatamente em experiência do usuário, risco jurídico ou problema para a marca. O sentido prático dos guardrails é transformar a integração de LLMs, antes uma espécie de mágica de prompts, em um sistema de engenharia comum, com verificações, logging e recusas previsíveis. O desenvolvedor define não só o estilo desejado da resposta, mas também as condições formais de aceitação: quais temas são permitidos, a qual JSON schema o resultado deve obedecer, o que fazer em caso de conflito de instruções, quando bloquear a resposta por completo e quando entregar uma versão reduzida e segura.
Isso torna o comportamento do serviço mais estável e os incidentes mais fáceis de analisar: em vez da explicação vaga de que o modelo inventou algo, surge um ponto de controle concreto, onde é possível ver exatamente o que não passou na verificação. Para equipes Java, essa também é uma forma de incorporar a segurança de LLMs ao processo de produção que elas já conhecem. Os guardrails podem ser implementados como filtros, middleware, camada de políticas ou serviços separados em torno do modelo, cobertos por testes e incluídos no pipeline geral de qualidade.
Assim, a proteção deixa de depender de um único prompt bem escrito no início do projeto e passa a fazer parte da arquitetura. Quanto mais crítico o cenário — finanças, medicina, suporte ao cliente, conhecimento interno da empresa —, mais importante é essa mudança: não confiar na palavra do modelo e não liberar suas respostas sem validação técnica. A conclusão é direta: um bom system prompt continua necessário, mas não deve ser a última linha de defesa.
Se o produto usa LLMs para valer, guardrails no nível do código se tornam um elemento obrigatório, e não uma opção para os mais cautelosos. Eles não tornam o modelo perfeito, mas reduzem drasticamente a chance de que uma prompt injection, uma resposta tóxica ou um contorno acidental das regras chegue à interface e prejudique o usuário ou o negócio.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.