Auditoria no Cursor encontra quatro falhas na proteção do editor de código, mas não consegue quebrar a autorização
Um pesquisador destrinchou a arquitetura interna do Cursor, reconstruiu os esquemas protobuf e testou se era possível contornar a autorização no servidor para acessar modelos caros. Não houve um bypass completo. Ainda assim, a auditoria encontrou quatro pontos fracos: prototype pollution nos endpoints de billing, um campo dev oculto para roteamento de modelos, vazamento de detalhes do service mesh e validação fraca de parte dos campos protobuf no servidor.
Processado por IA de Habr AI; editado por Hamidun News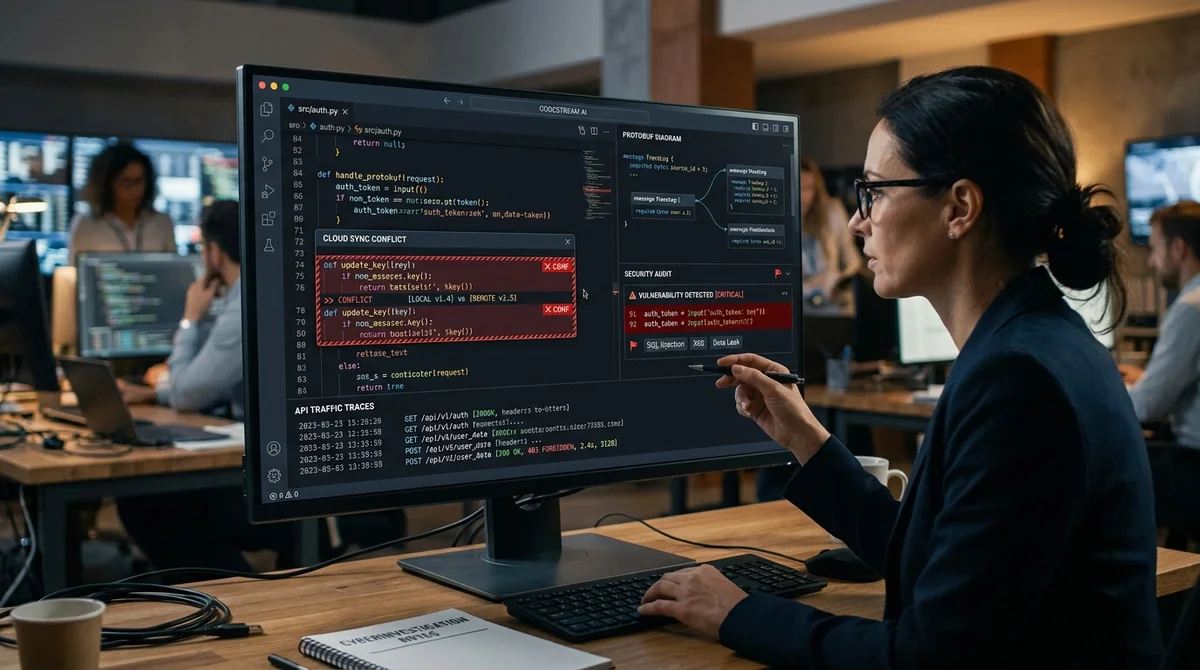
A auditoria de segurança do Cursor chegou a um resultado raro entre ferramentas de AI. O pesquisador não conseguiu contornar a autorização no servidor nem acessar modelos premium por meio de uma vulnerabilidade no cliente. No caminho, porém, encontrou quatro problemas relevantes no perímetro de proteção.
A análise chama atenção justamente por não ser uma história de "está tudo quebrado". Trata-se de uma verificação detalhada de como funciona um editor com AI que processa em seus servidores grandes volumes de código e de requisições de desenvolvedores. O trabalho começou com a descompilação do cliente Electron do Cursor, baseado no VS Code.
Em um único arquivo JavaScript minificado, com mais de 1,1 milhão de linhas, o autor reconstruiu as definições protobuf, o mapa da API, a lógica de OAuth e a lista de feature gates. Ele também mostrou que o token JWT do usuário não traz claims sobre assinatura ou plano. As permissões de acesso aos modelos não são verificadas no cliente nem pelo conteúdo do token, e sim no servidor, com base nos dados do banco.
Para um produto SaaS que oferece LLMs caros, essa é uma escolha arquitetural decisiva: é esse esquema que impede um usuário "gratuito" de simplesmente alterar parâmetros locais e liberar para si o Claude 4 Opus ou outro modelo premium. Depois da engenharia reversa, o pesquisador passou aos ataques contra a API. A primeira descoberta foi um prototype pollution em endpoints JSON ligados à assinatura e a promoções.
Quando campos como __proto__ ou constructor.prototype são adicionados ao corpo da requisição, o servidor responde com 500 Internal Server Error em vez da recusa esperada. Isso não gera um upgrade automático de plano, mas mostra que a contaminação da prototype chain acontece antes das verificações de negócio e pode alterar o fluxo de validação.
O segundo problema é o campo oculto devRawModelSlug em AgentRunRequest. Ele não consta do esquema do cliente, mas os servidores de produção aceitam o campo, reconhecem seu nome e devolvem um erro específico. Esse erro revela que existe no sistema um mecanismo dev para indicar diretamente o modelo de backend, contornando o routing padrão.
Hoje esse caminho está desativado, mas a simples presença dele no ambiente de produção aumenta o risco de erros de configuração. As outras duas vulnerabilidades não envolvem burlar a assinatura, e sim exposição excessiva da arquitetura interna e validação incompleta. Um dos métodos internos responde com a mensagem Invalid internal service header.
Por ela, dá para concluir que o endpoint existe, é protegido por uma autorização service-to-service separada e espera um cabeçalho especial. Um cliente externo não precisa desse nível de detalhe: seria mais seguro responder com um 404 ou 401 genérico, sem pistas internas. Além disso, a auditoria mostrou que alguns campos protobuf usados em cenários de subagent aceitam referências a modelos premium sem uma verificação de plano própria.
Na prática, isso não muda o modelo que de fato responde nem abre um bypass, porque o routing ignora esses campos de qualquer forma. Mesmo assim, essa lógica amplia a attack surface e pode virar um problema após futuras mudanças no produto. Uma parte importante da análise é a lista de vetores que não funcionaram.
O autor testou bruteforce de nomes de modelos, adulteração de claims do JWT, injeções no callback de OAuth, replay de webhooks do Stripe, confusão entre requested_model e model_details, conflitos de wire types no protobuf e condições de corrida em torno da assinatura. Nenhum deles resultou em um bypass relevante. O servidor rejeita tags protobuf inválidas, não confia nos dados do JWT, valida as assinaturas do Stripe e mantém o plan check centralizado.
Isso torna a conclusão mais sólida: os problemas existem, mas o modelo básico de proteção do Cursor parece maduro e bem pensado em comparação com muitos serviços de AI que confiam demais no cliente. O alcance prático dessa história vai além do próprio Cursor. Para quem desenvolve AI-SaaS, ela funciona como um bom checklist: não guardar privilégios no token, verificar o plano no servidor a cada requisição, validar o protobuf com rigor e não deixar campos dev em esquemas de produção.
Para os usuários, é um sinal de que mesmo AI-IDEs avançados ainda têm uma superfície vulnerável em torno do billing, dos serviços internos e dos mecanismos de roteamento de modelos. E o principal: hoje a segurança de um produto de AI não depende de quantos modelos ele suporta, mas da disciplina com que separa o cliente das permissões reais de acesso no servidor.
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026IAs locais aceitaram pagar golpistas, mas as regras barraram os 42 golpes
- 31 de out. de 2026Autor levou seu roteiro a um júri de IA: o veredito custou 850 mil tokens
- 31 de out. de 2026Anthropic: unir subagentes em um só ciclo fez as tarefas de um cliente rodarem duas vezes mais rápido
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.