Por que a LoRA falha em produção e como a RS-LoRA salva o ajuste fino de modelos
A LoRA funciona bem quando o modelo só precisa mudar de tom, formato ou persona, mas vai pior quando é preciso ensinar fatos novos. Um rank baixo corta um sinal de alta dimensão, e simplesmente aumentar o rank enfraquece o aprendizado. A RS-LoRA propõe um ajuste simples: usar alpha/√r em vez de alpha/r, mantendo a estabilidade em ranks altos.
Processado por IA de MarkTechPost; editado por Hamidun News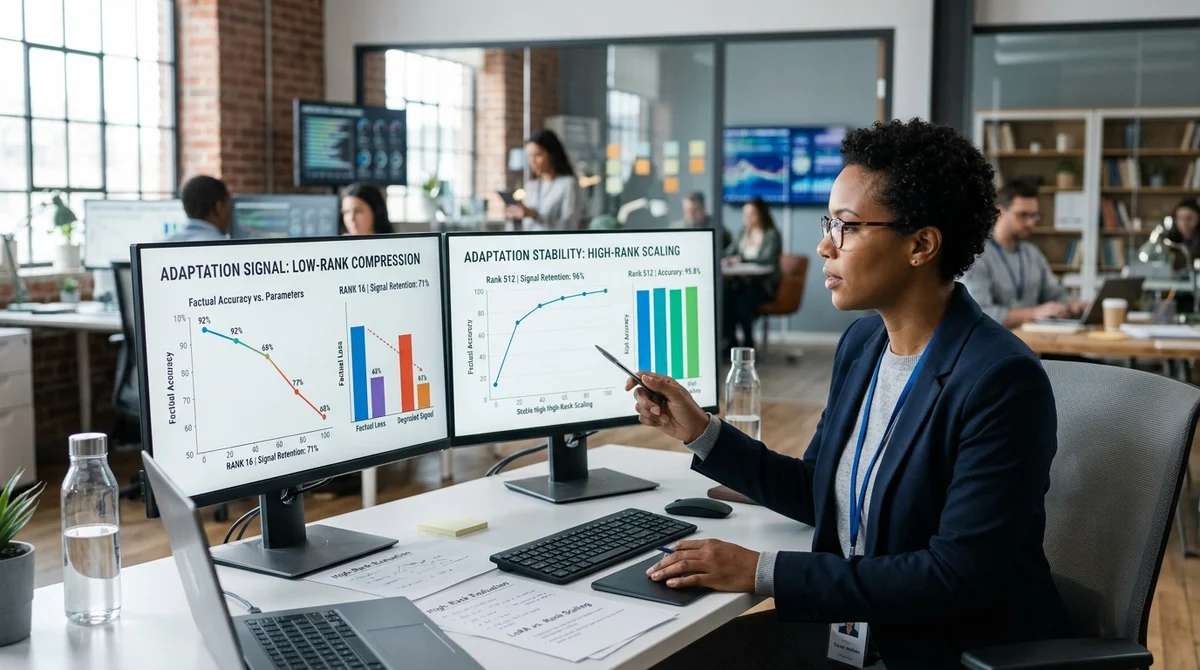
A LoRA já virou o padrão para ajuste fino barato de modelos grandes, mas em produção carrega uma suposição escondida: a de que todas as atualizações de pesos são parecidas. Na prática, não são. As mudanças responsáveis pelo estilo são de fato compactas, enquanto as atualizações que adicionam fatos novos e conhecimento de domínio se espalham por muitas dimensões, e é aí que a LoRA comum começa a perder informação.
A popularidade da LoRA tem explicação: o método permite ajustar um modelo sem recalcular todos os parâmetros, usando pequenas matrizes de rank baixo. Funciona bem quando é preciso mudar o tom, o formato de resposta, o personagem ou os vícios de fala de um assistente. O artigo mostra isso numa matriz de pesos simplificada de 64×64: na atualização de estilo, alguns valores singulares dominam de forma acentuada, então uma aproximação de rank 4 ou 8 preserva quase todo o sinal.
Na simulação deles, já com rank 4 se cobre mais de 99% da variação útil. Por isso um chatbot aprende com facilidade um novo estilo de conversa, um modelo de resposta ou a maneira desejada, sem retreinar todo o modelo.
Os problemas começam quando é preciso ensinar conteúdo, não forma: fatos médicos, catálogos de produtos, regulamentos internos, estatísticas ou regras setoriais. Essas atualizações se comportam como de rank alto: a informação está espalhada por muitas direções, em vez de concentrada em poucos componentes dominantes. No experimento do artigo, o rank 8 retém apenas cerca de 28% do sinal real.
Daí um efeito conhecido em produção: o modelo soa confiante, usa a terminologia certa e a estrutura geral da resposta, mas confunde números, deixa passar detalhes ou dá uma conclusão incompleta. Para assistentes corporativos, análise de dados, suporte e cenários baseados em conhecimento, isso não é um defeito cosmético, e sim um risco de qualidade.
A diferença-chave aparece no espectro de valores singulares. Tarefas de estilo têm um cotovelo nítido: depois de poucos componentes, as dimensões extras quase não acrescentam nada. Fatos têm uma cauda longa, em que cada componente seguinte adiciona parte do conhecimento útil. Quando a LoRA trunca à força uma atualização assim para um rank baixo, ela corta justamente essa cauda. Por fora, o sistema ainda pode parecer melhor, porque formato, tom e estrutura ficaram mais caprichados, mas a precisão factual cresce bem menos do que os testes superficiais indicam. Isso explica por que demos com respostas bonitas e bom estilo não garantem comportamento confiável com dados reais de trabalho.
A reação lógica de um engenheiro é simplesmente aumentar o rank. Mas a LoRA padrão tem um segundo problema escondido: a escala alpha/r. Quanto maior o rank, mais o coeficiente encolhe e mais fraco fica o sinal de treinamento.
No exemplo com alpha = 16, a escala cai de 16 com rank 1 para 0,25 com rank 64. O resultado é um paradoxo: você adiciona capacidade para o modelo representar uma atualização mais complexa, mas ao mesmo tempo reduz a influência real dessa atualização sobre os pesos. O otimizador precisa compensar com passos mais agressivos, e o treinamento ou converge pior ou fica instável.
Por isso, o conselho de aumentar o rank em produção muitas vezes não resolve o problema e, às vezes, só o disfarça.
A RS-LoRA propõe uma correção mínima, mas importante: usar alpha/√r em vez de alpha/r. Formalmente, é quase a troca de um símbolo, mas na prática o efeito é grande. Com rank 64, a escala permanece em 2,0 em vez de 0,25, então a adaptação de rank alto mantém uma magnitude significativa e não mata o sinal.
O artigo mostra isso sem loops de treinamento pesados nem frameworks, apenas com NumPy, SVD e uma comparação de erros de reconstrução. Isso deixa o argumento especialmente claro: tarefas de estilo de rank baixo continuam bem atendidas pela LoRA comum, enquanto tarefas de inclusão de conhecimento exigem a RS-LoRA ou uma estratégia de adaptação diferente desde a origem.
A conclusão para equipes que colocam LLMs ajustados em produção é bem direta: a configuração do adaptador deve ser escolhida não só por orçamento e velocidade, mas também pelo tipo de atualização. Se você muda tom, persona ou formato de resposta, a LoRA padrão de rank baixo costuma bastar. Se você incorpora fatos novos, dados de referência, regras ou conhecimento de domínio, um rank baixo pode criar a ilusão de um treinamento bem-sucedido enquanto perde em silêncio uma parte substancial da informação. Nesses casos, a RS-LoRA deixa de parecer uma otimização fina e passa a ser um requisito de confiabilidade do modelo em operação real.
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.