Por que modelos de difusão deixam emendas em fotos de 40 megapixels e como dar memória aos tiles
Modelos de difusão lidam bem com imagens comuns, mas em quadros profissionais de 40–150 MP o tiling quase inevitavelmente deixa emendas, cor oscilante e texturas rompidas. O material analisa por que os modelos de foto não conseguem manter memória entre tiles vizinhos e quais ideias da difusão de vídeo, do FramePack ao AnimateDiff, podem ajudar a corrigir isso. O autor argumenta que o limite não é só o hardware nem o tamanho da imagem, mas a própria arquitetura da difusão fotográfica.
Processado por IA de Habr AI; editado por Hamidun News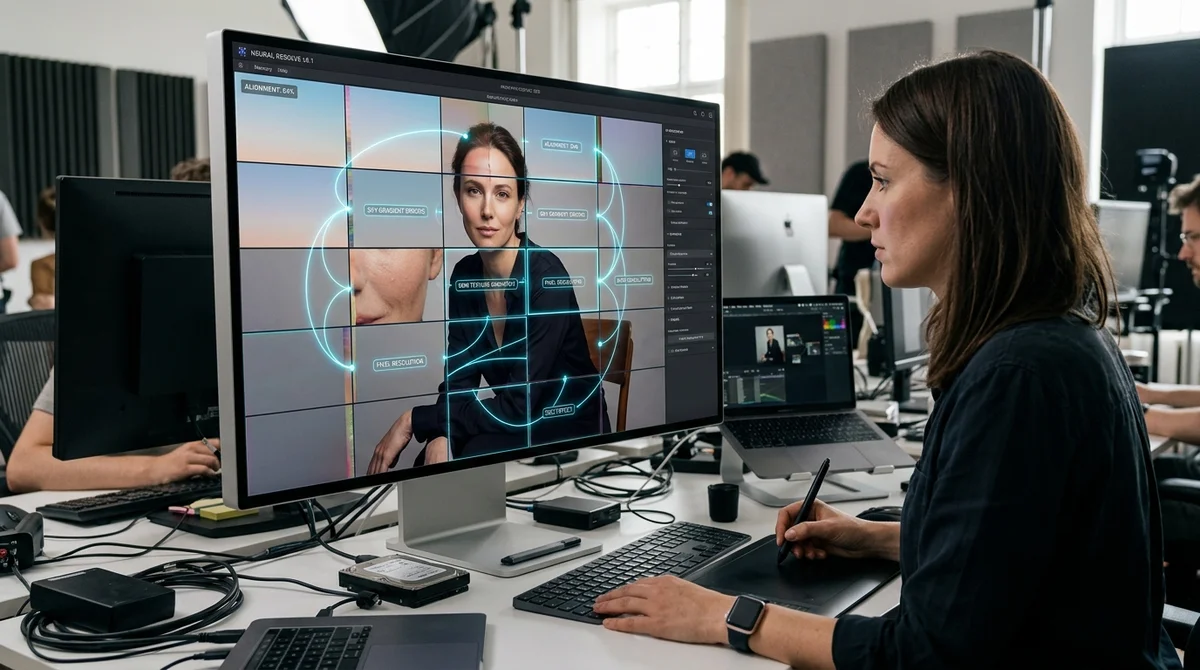
A principal causa das emendas em imagens ultragrandes não é uma costura malfeita nem apenas a falta de memória de vídeo. O problema é mais profundo: os modelos de difusão para fotos não mantêm memória entre fragmentos vizinhos da imagem. Quando um quadro de 40–150 megapixels é cortado em dezenas ou centenas de tiles, o modelo toma cada decisão do zero. Ele não sabe qual tom de céu, cor de pele ou escala de textura já escolheu no fragmento ao lado. Daí surgem os degraus nos gradientes, a cor oscilante e as junções visíveis, que são especialmente danosas na retocagem profissional.
O autor aborda o tema pela prática, não pela teoria: tem vinte anos de retoque e quatro anos tentando adaptar modelos de difusão à produção. Em fotografia de estúdio, publicitária e de revista, alta resolução não é luxo, mas padrão de trabalho, e esses quadros raramente cabem em uma única passada de geração ou edição. Por isso a indústria volta sempre ao mesmo recurso: dividir a imagem em 100 ou mais fragmentos, processá-los separadamente e depois remontá-los. Em detalhes pequenos isso pode funcionar de forma aceitável, mas em pele, tecido, fundo e transições de luz os artefatos são quase inevitáveis.
A raiz do problema é que o tiling comum preserva o detalhe local, mas quebra a coerência global. Cada tile vê apenas o seu pedaço da cena e não entende o que acontece à esquerda, à direita, acima e abaixo. Mesmo que áreas vizinhas se sobreponham, o modelo ainda pode deslocar um pouco o balanço de cor, interpretar o grão de outro jeito, acrescentar poros que não combinam ou construir outro ritmo de textura. Blending e máscaras escondem parte dos defeitos, mas não eliminam a causa: o modelo de foto não tem um mecanismo que ligue as decisões entre vizinhos. Por isso a emenda perfeita em quadros muito grandes continua sendo mais exceção que regra.
O artigo propõe olhar para a difusão de vídeo, onde a consistência há tempos está no centro da arquitetura. Um modelo de vídeo precisa lembrar como o objeto aparecia no quadro anterior para não perder o rosto, a luz, a textura e a posição dos detalhes durante o movimento. O autor analisa oito classes dessa memória, do BCLA do SANA-Video e do FramePack ao SVD reshape, AnimateDiff e outras abordagens, e avalia o que pode ser transferido para os tiles e o que não pode.
A questão central não é o nome do método, mas o princípio: é possível fazer um modelo de foto passar ao fragmento vizinho um contexto compacto, um estado oculto ou uma estrutura de cena compartilhada, para que as decisões não sejam tomadas no vácuo?
Disso decorrem três grandes ideias para a prática. A primeira é a troca de contexto entre tiles vizinhos, em que o modelo recebe não só o fragmento atual, mas também informação comprimida sobre as áreas já processadas. A segunda é uma memória compartilhada no nível dos latentes ou dos mecanismos de atenção, que mantenha cor, iluminação e caráter de superfície uniformes em toda a imagem.
A terceira é um esquema em várias etapas, em que primeiro se constrói uma representação global grosseira de toda a cena e depois os tiles locais apenas refinam os detalhes, sem quebrar o conjunto. Para impressão, publicidade externa, retoque de beleza e fotografia comercial isso é crítico: ali qualquer ruptura de textura ou salto de tom aparece de imediato.
A conclusão principal é simples: o limite não está só no hardware nem só no tamanho da imagem, mas na própria arquitetura da difusão fotográfica. Enquanto o modelo não aprender a lembrar o que já aconteceu ao lado, o processamento de quadros de 40 megapixels ou maiores continuará sendo um compromisso entre detalhe e integridade. Se os mecanismos de memória do vídeo puderem ser adaptados aos tiles, os modelos de difusão darão um passo notável das demos chamativas rumo a uma ferramenta profissional completa de retoque e pós-produção.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.