Embeddings da OpenAI e RL: como montar um agente com memória de longo prazo para respostas precisas
Um novo tutorial mostra como construir um agente de RL com memória de longo prazo que aprende a buscar, em uma base de conhecimento, exatamente os registros que ajudam o LLM a responder com mais precisão. O esquema parte de um dataset sintético e de consultas que exigem recuperar fatos. Em seguida, usa embeddings da OpenAI para transformar memórias e perguntas em vetores e treinar de forma direcionada uma política de seleção das memórias relevantes.
Processado por IA de MarkTechPost; editado por Hamidun News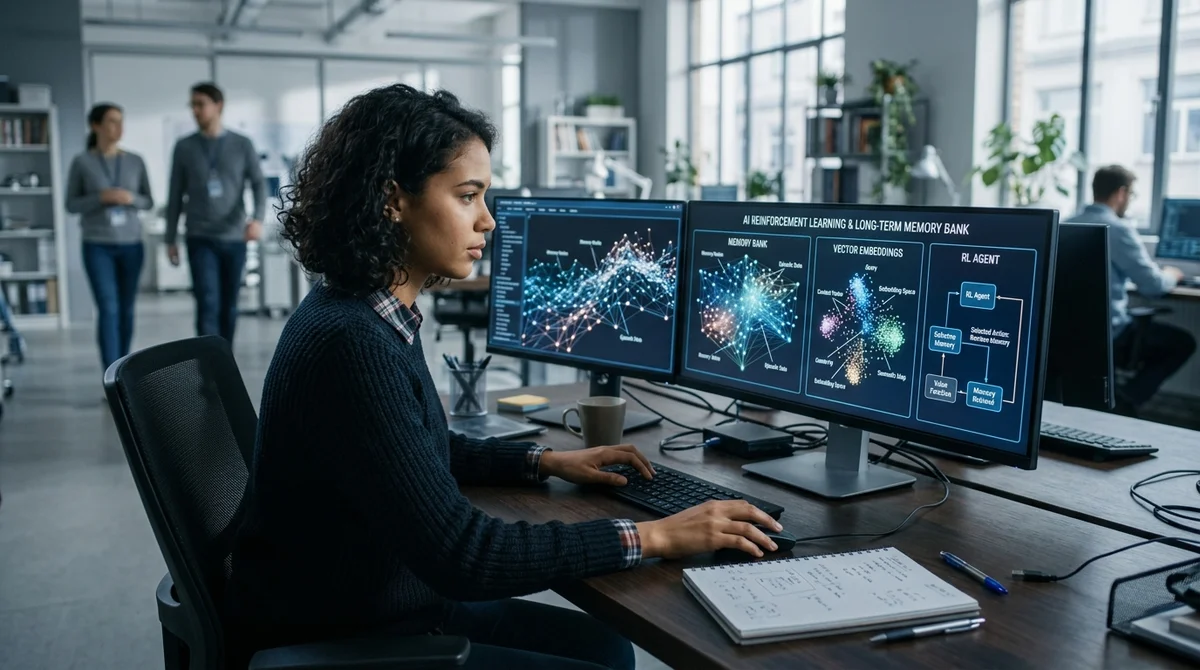
A ideia de memória de longo prazo para IA está virando um problema prático. Um novo tutorial mostra como montar um agente baseado em aprendizado por reforço que não se limita a procurar registros parecidos: ele aprende a buscar na memória exatamente os fatos necessários para que o LLM responda com precisão. Essa abordagem importa em sistemas com conhecimento demais para caber em uma única janela de contexto, nos quais errar a escolha da memória certa afeta de imediato a qualidade da resposta.
Os autores começam com um conjunto de memória sintético: criam uma coleção de registros e, depois, formulam consultas que exigem lembrar detalhes específicos. É uma formulação conveniente, porque permite controlar qual registro é de fato relevante e avaliar não só a resposta final do modelo, mas também a própria etapa de recuperação da memória. Em vez de regras definidas manualmente, entra em cena um agente treinável, que recebe aos poucos um sinal sobre quais ações ajudam a chegar ao fato correto. Isso também reduz o risco de overfitting a um cenário de busca específico e facilita a verificação automática dos experimentos.
Em seguida, memórias e consultas são levadas a um espaço vetorial com os embeddings da OpenAI. Assim, o sistema ganha um sinal básico de similaridade: quais registros parecem semanticamente próximos da pergunta. Mas sistemas desse tipo costumam tropeçar quando dependem apenas da proximidade vetorial. Um registro parecido pode ser genérico demais, coincidir só parcialmente com o tema ou trazer um fato vizinho, mas não o certo. É aqui que o RL funciona como uma camada sobre a busca comum: o agente precisa aprender a escolher não o mais parecido, e sim o mais útil para a resposta.
Na prática, a etapa de busca na memória deixa de ser uma busca estática por vizinhos mais próximos e passa a ser uma sequência de decisões. O agente pode ranquear candidatos, refinar a escolha, combinar sinais e ser recompensado por recuperar trechos que levam o LLM a responder com mais precisão. Para desenvolvedores, é uma mudança importante: a memória deixa de ser um repositório passivo e passa a integrar o ciclo de otimização.
Esse design é especialmente útil para assistentes pessoais, bases de conhecimento corporativas, sistemas de agentes com histórico de diálogo e qualquer produto em que o modelo precise lembrar fatos antigos sem carregar o arquivo inteiro no prompt o tempo todo. É justamente essa arquitetura que ajuda a separar o contexto de curto prazo da consulta atual da memória acumulada, que cresce junto com o produto.
Merecem atenção à parte o caráter sintético do dataset e a forma como o resultado é avaliado. Nas primeiras etapas, um conjunto assim ajuda a rodar o treinamento rapidamente e a verificar se a mecânica do sinal de recompensa funciona, mas depois o esquema terá de ser levado a dados reais, bem mais bagunçados: anotações de usuários, eventos de CRM, trechos de documentos, trocas de mensagens e atas de reuniões. No mundo real, a relevância quase nunca é binária, e fatos importantes podem estar espalhados por vários registros.
Por isso, não basta checar se o modelo encontrou algo parecido: é preciso medir se a recuperação ajudou a gerar a resposta correta, se o número de alucinações caiu e quão estável é o comportamento do agente em diferentes tipos de consulta. Nesse sentido, o valor do RL está em otimizar justamente a utilidade da memória recuperada para a tarefa final, e não uma métrica abstrata de similaridade.
A principal conclusão do material é que a próxima onda de melhorias em agentes de LLM virá não só do tamanho do modelo, mas também da qualidade da gestão de memória. Se o agente consegue aprender com um sinal de utilidade e escolher a memória certa na hora certa, é possível, mesmo sem ampliar a janela de contexto, aumentar sensivelmente a precisão das respostas, reduzir o ruído e tornar o comportamento do sistema mais estável no longo prazo. Para equipes que constroem produtos de IA sobre RAG e cenários com agentes, fica uma boa referência: vale otimizar não só a geração, mas também a política de recuperação de conhecimento.
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Kimi marca 96,2% em teste de análise em base 1C e vira reserva caso o Claude seja bloqueado
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Google admite que o AI Mode reduz a receita da Busca; ações caem 15%
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.