Fim da era do IA caro: Google e NVIDIA derrubam o custo da inferência
O maior gargalo do desenvolvimento da inteligência artificial nunca foi o custo de treinar modelos, mas o de operá-los todos os dias. Na conferência Google Cloud Next, Google e NVIDIA apresentaram uma solução conjunta capaz de mudar radicalmente a economia da computação em nuvem. As novas instâncias A5X, que rodam sobre os sistemas monolíticos em rack NVIDIA Vera Rubin NVL72, prometem reduzir em dez vezes o custo da inferência de IA. Segundo as empresas, esse resultado foi possível graças a uma integração sem precedentes entre hardware e software. Uma queda de custo dessa magnitude deve inevitavelmente tornar a IA multimodal avançada acessível a serviços de consumo em massa.
Processado por IA de AI News; editado por Hamidun News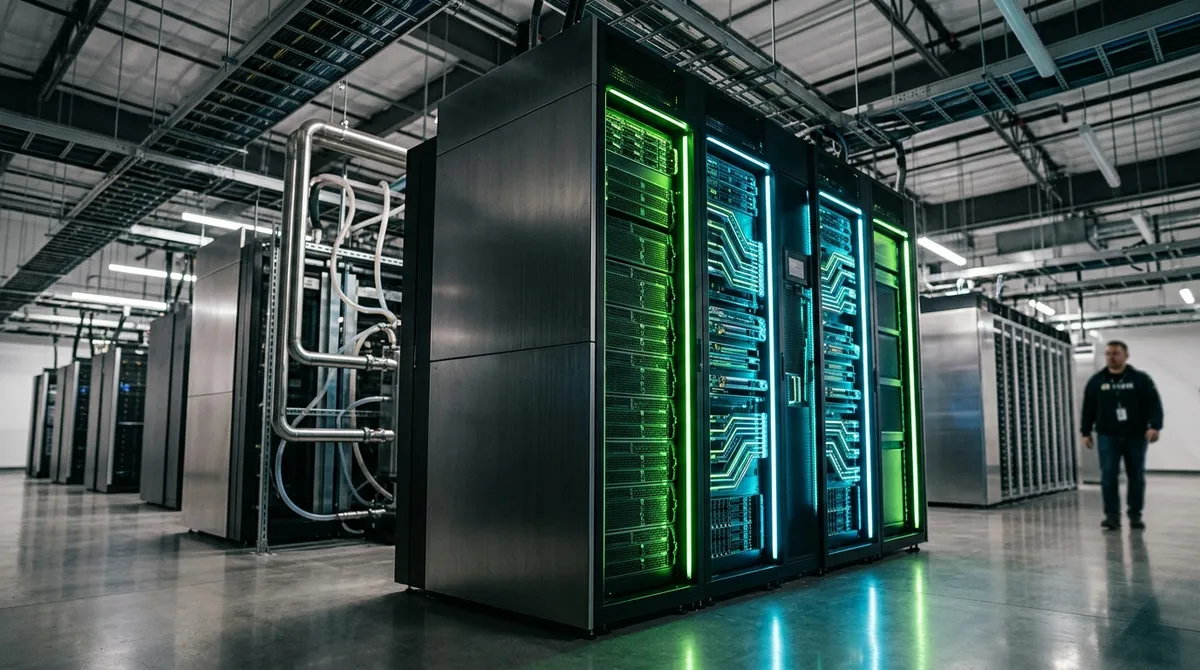
Durante muito tempo, a indústria de inteligência artificial foi refém da própria ambição, escondendo problemas econômicos fundamentais atrás de lançamentos barulhentos. As atenções do público se voltam tradicionalmente para os custos colossais do treinamento inicial de novos modelos de linguagem, mas o verdadeiro buraco negro financeiro está na operação diária deles. O processo de gerar respostas para milhões de solicitações de usuários por dia, conhecido no setor como inferência, exige o funcionamento contínuo de clusters enormes e extremamente famintos por energia.
Esse fator até hoje tornou economicamente inviável, para a grande maioria das empresas, a adoção em massa de uma IA multimodal realmente de ponta. Na Google Cloud Next, realizada recentemente, as gigantes de tecnologia Google e NVIDIA anunciaram o fim dessa era de escassez de infraestrutura, apresentando uma nova arquitetura conjunta que promete derrubar o custo da inferência em dez vezes.
A base desse avanço tecnológico são as novas instâncias computacionais A5X, oferecidas em modalidade bare metal ("hardware puro"). Abrir mão da virtualização clássica elimina por completo a perda de desempenho nas camadas intermediárias de software, entregando todo o poder de processamento diretamente aos algoritmos. Essas instâncias usam a monumental arquitetura NVIDIA Vera Rubin, a aguardada troca de geração que sucede a Blackwell.
O elemento central da nova infraestrutura são os sistemas em rack NVL72. Na abordagem modular tradicional, GPUs individuais são reunidas em servidores padrão, com gargalos inevitáveis na transferência de dados. O NVL72, por outro lado, é um sistema computacional monolítico do tamanho de um armário inteiro.
Dentro desse rack, setenta e dois processadores gráficos de nova geração funcionam como um único supercomputador gigante, interligados por conexões ópticas de interconexão ultrarrápidas.
Essa abordagem radical de montagem dos servidores ataca o principal problema da inferência atual: a largura de banda da memória. Agora, mesmo os maiores modelos de linguagem, com centenas de bilhões de parâmetros, podem ser carregados por inteiro na memória compartilhada do sistema. Isso poupa o cluster de ficar movendo blocos de dados, de forma constante, lenta e cara em energia, entre nós distintos.
A redução de dez vezes no custo de geração de tokens, segundo as empresas, vem não apenas da força bruta de silício dos chips da arquitetura Rubin, mas também de um nível sem precedentes de projeto conjunto e profundo entre hardware e software. Vale notar que o Google, dono de processadores tensoriais TPU próprios e muito potentes, tenha chegado a uma integração tão profunda com a NVIDIA, reconhecendo a necessidade de uma abordagem híbrida para atender à demanda gigantesca dos desenvolvedores.
Os engenheiros das duas empresas reescreveram, literalmente, a pilha básica de gerenciamento computacional, otimizando-a para as necessidades específicas da geração de conteúdo em larga escala. Os novos algoritmos de distribuição de carga em nível de software agora levam em conta a topologia física do rack Vera Rubin, minimizando a latência de sinal na casa dos microssegundos. Em paralelo, o uso de refrigeração líquida avançada e de novos controladores inteligentes de energia permitiu reduzir radicalmente o consumo de eletricidade por megabyte de dados gerado. Para os data centers atuais, em que a conta de energia muitas vezes supera o custo dos próprios servidores, esse é um fator crítico de rentabilidade.
É difícil exagerar as consequências desse anúncio de infraestrutura para o mercado de tecnologia, porque ele derruba uma barreira fundamental na economia unitária de serviços baseados em inteligência artificial. Até hoje, desenvolvedores independentes e grandes corporações precisavam fazer concessões o tempo todo. Tinham de limitar artificialmente a funcionalidade de seus produtos, usando modelos menos capazes, porém mais baratos, ou impor limites rígidos ao número de solicitações para não quebrar com as faturas da nuvem. Uma redução de dez vezes nos custos significa que modelos de negócio que ontem pareciam pura ficção científica, por causa do custo absurdo da computação, hoje se tornam plenamente rentáveis.
No futuro próximo, a inferência mais barata levará a uma revolução discreta, mas grandiosa, na experiência do usuário. Análise de vídeo complexa em tempo real, geração personalizada de mundos tridimensionais em jogos, em tempo de execução, e agentes de IA inteligentes que trabalham em segundo plano 24 horas por dia, analisando todo o fluxo de informação recebida: tudo isso pode virar padrão de massa, e não um serviço premium caro. Para o mercado de provedores de nuvem, a aliança entre Google e NVIDIA estabelece um patamar de eficiência assustadoramente alto.
As abordagens tradicionais de construção de data centers envelhecem rapidamente, cedendo espaço a soluções hiperotimizadas em nível de racks inteiros. A parceria marca uma mudança de paradigma importante: o setor passa de vez da corrida para criar a inteligência artificial mais inteligente para uma corrida pragmática para entregá-la da forma mais barata, rápida e eficiente a cada usuário do planeta.
- 2 de nov. de 2026Criador do Bun migra 750 mil linhas de Zig para Rust em 11 dias com Claude Code
- 2 de nov. de 2026Jornalista da The Verge monta um rival do Meta Muse Charm por $50 com ajuda do Claude Code
- 1 de nov. de 2026Teste com 16 modelos em 7 buscadores: Exa fez em média 10,5 pontos de 14; SearXNG, cerca de 3
- 1 de nov. de 2026Agente de vídeo StreamVibe, do Google, supera outros modelos em 10,7% em timing e qualidade das respostas
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.