Amazon SageMaker e DVC: rastreamento de ponta a ponta de modelos de ML, dos dados à previsão
A AWS publicou um guia sobre rastreamento de ponta a ponta de modelos de ML com DVC, Amazon SageMaker AI e MLflow Apps. O texto analisa dois padrões: lineage em nível de dataset e em nível de registro individual. Ambos são implantados na sua conta da AWS por meio de notebooks prontos.
Processado por IA de AWS Machine Learning Blog; editado por Hamidun News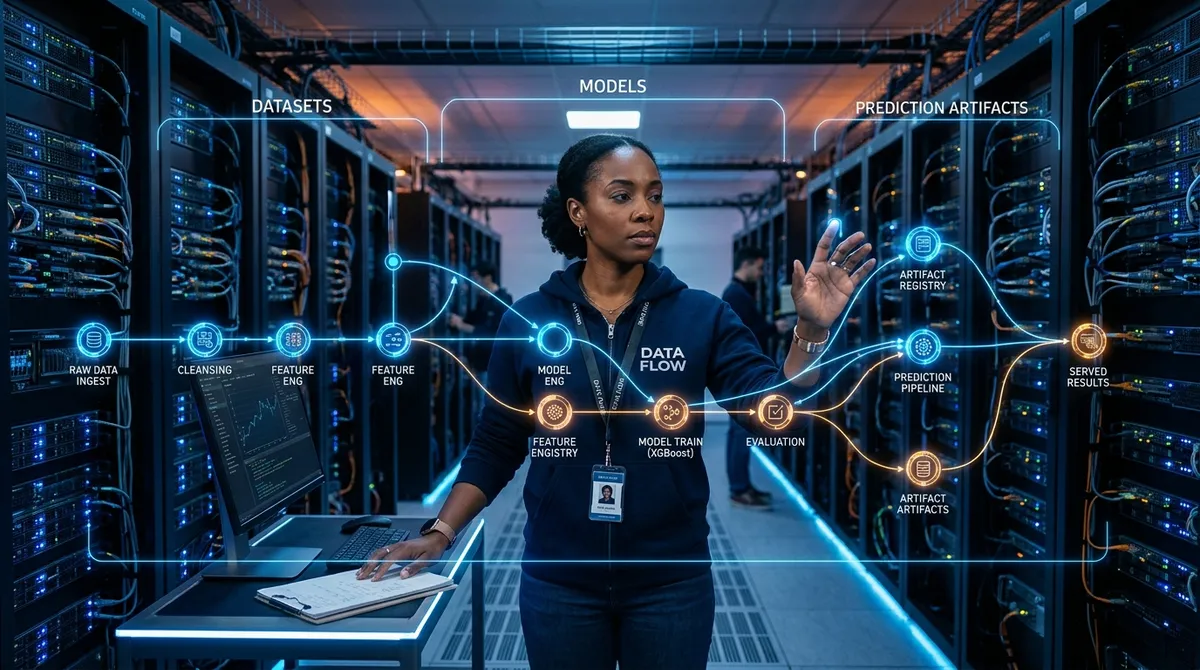
O AWS Machine Learning Blog publicou um guia detalhado para construir o rastreamento de ponta a ponta de modelos de ML, dos dados brutos até a previsão final, usando três ferramentas: DVC, Amazon SageMaker AI e Amazon SageMaker AI MLflow Apps.
O problema que o material aborda é bem conhecido das equipes que operam em produção: não fica claro com quais dados exatos um modelo específico foi treinado, quais transformações foram aplicadas a eles e como um registro individual influenciou a previsão. Isso é crítico em auditorias, na depuração de desvios (data drift) e no cumprimento de exigências regulatórias.
O DVC (Data Version Control) é uma ferramenta de código aberto que adiciona ao Git o versionamento de arquivos grandes e datasets. Combinado ao SageMaker, ele permite registrar um retrato exato dos dados usados em cada execução de treinamento. O SageMaker MLflow Apps, por sua vez, armazena métricas, parâmetros e artefatos dos experimentos: é um servidor MLflow padrão, gerenciado pela AWS, sem necessidade de montar a infraestrutura manualmente.
Os autores descrevem dois padrões concretos. O primeiro é o lineage em nível de dataset: registra-se a versão do dataset (por meio de uma tag do DVC), os parâmetros do pipeline de processamento e uma referência ao modelo treinado no MLflow. O segundo é o lineage em nível de registro: cada registro do conjunto de treinamento é vinculado ao modelo, o que permite responder à pergunta "quais exemplos específicos formaram esta previsão". Os dois padrões vêm como notebooks Jupyter prontos para rodar na sua conta da AWS.
A arquitetura funciona assim: os dados ficam no S3 e são versionados pelo DVC; os metadados dos experimentos (parâmetros, métricas, artefatos) ficam no MLflow App; e a ligação entre a versão dos dados e a versão do modelo é feita por tags personalizadas e artefatos do DVC registrados no MLflow.
O valor prático da abordagem está na reprodutibilidade. Se, daqui a seis meses, se descobrir que um modelo se comporta de forma inesperada em determinada coorte de usuários, os engenheiros poderão reconstituir com exatidão em qual dataset ele foi treinado, quais registros entraram nele e com quais hiperparâmetros o treinamento foi executado.
O material é voltado a engenheiros de ML e equipes de MLOps que já trabalham no ecossistema da AWS. Os notebooks prontos reduzem bastante a barreira de entrada: não é preciso projetar a integração do zero, basta adaptar os exemplos ao seu dataset e ao seu pipeline de processamento. Para empresas que se preocupam com a auditabilidade de sistemas de ML, principalmente nos setores financeiro, de saúde e em projetos governamentais, essa abordagem está virando padrão de fato.
A AWS vem construindo, de forma consistente, ferramentas em que o lineage deixa de ser uma "boa prática" opcional e passa a ser uma propriedade embutida do pipeline.
- 2 de nov. de 2026Jornalista da The Verge monta um rival do Meta Muse Charm por $50 com ajuda do Claude Code
- 31 de out. de 2026Worldwide Express entrega contas contestadas a agentes de IA e reduz dívida em 75%
- 30 de out. de 2026AWS dá a agentes de código uma prévia ao vivo do site direto da sessão isolada
- 30 de out. de 2026Tráfego de agentes no Zocdoc cresce 30 vezes desde julho, e o ChatGPT recebe dois processos ligados à saúde
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.