OpenAI apresenta seu primeiro modelo de IA baseado em chips da Cerebras
A OpenAI apresentou oficialmente o GPT-5.3-Codex-Spark, seu primeiro modelo a rodar em hardware da startup Cerebras Systems. Trata-se de uma versão otimizada e mais rápida do Codex, sistema da empresa para automatizar a escrita de código. O lançamento marca o início da diversificação do hardware da OpenAI para driblar o domínio da Nvidia. O modelo busca fortalecer a posição da empresa diante de Google e Anthropic no segmento de assistentes de IA para desenvolvedores, com alta velocidade sem perder precisão na geração de código.
Processado por IA de 36Kr (36氪); editado por Hamidun News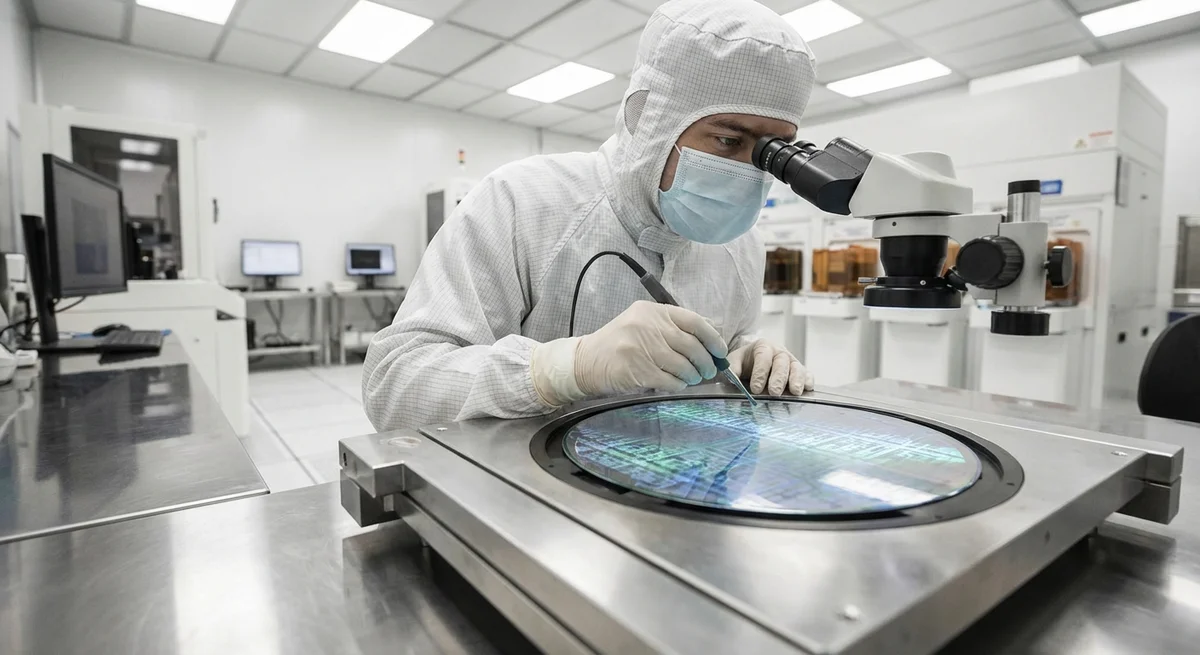
A OpenAI fez uma jogada estratégica rumo à independência tecnológica: a empresa apresentou o GPT-5.3-Codex-Spark, o primeiro modelo de inteligência artificial desenvolvido especificamente para rodar em chips da Cerebras Systems. Não é apenas um produto novo, mas uma demonstração de que a OpenAI está disposta a diversificar suas parcerias de hardware e reduzir a dependência da Nvidia, que domina o mercado de aceleradores de IA.
O Codex-Spark é posicionado como uma versão otimizada da conhecida ferramenta Codex para automatizar a escrita de código: por um lado, mais leve de operar; por outro, bem mais rápida na execução de tarefas. O lançamento coincide com o acirramento da concorrência entre assistentes de IA para desenvolvedores, em que a OpenAI enfrenta o Google Gemini e o Claude, da Anthropic.
O contexto da decisão são as limitações sistêmicas crescentes que a OpenAI enfrenta. A empresa compra GPUs da Nvidia em escala global, mas isso cria uma vulnerabilidade: a qualquer momento o fornecimento pode ser restringido, os preços podem subir e a Nvidia pode impor suas próprias condições. A Cerebras Systems oferece uma alternativa com arquitetura própria, a WSE (Wafer Scale Engine), um chip projetado de forma diferente que entrega outro equilíbrio entre largura de banda e eficiência energética. Para a OpenAI, é uma necessidade estratégica: ampliar as fontes de desempenho significa uma posição de mercado mais sólida e menos exposta a fatores externos.
O GPT-5.3-Codex-Spark não é um modelo totalmente novo, e sim uma versão otimizada do Codex, adaptada às particularidades dos chips da Cerebras. É uma decisão técnica importante: arquiteturas diferentes exigem abordagens diferentes para distribuição de memória, paralelização de cálculos e cache de dados. Os engenheiros da OpenAI reformularam a estrutura do modelo para aproveitar ao máximo a topologia específica da Cerebras. O resultado é uma aceleração notável sem perda de precisão na geração de código. Para os desenvolvedores, isso significa um ciclo de feedback mais rápido: as solicitações de autocompletar código serão executadas com latência mínima, o que é crítico para o ecossistema de IDEs e o desenvolvimento contínuo.
O tamanho e o peso do modelo também pesaram nessa otimização. O Codex-Spark é posicionado como uma versão "leve", o que permite carregá-lo mais rápido na memória e reduz os requisitos de largura de banda de rede. Em um mundo em que cada milissegundo de latência afeta a experiência do usuário, isso importa. Principalmente no contexto da concorrência: Google Gemini e Claude já oferecem ferramentas integradas para trabalhar com código, mas os desenvolvedores costumam criticar a velocidade delas. O Codex-Spark pode conquistar parte desse público se de fato for mais rápido e mantiver a alta precisão das sugestões.
O movimento reflete uma tendência mais ampla do setor: o monopólio da Nvidia em GPUs é insustentável, e todos os grandes players começam a buscar alternativas. A Apple desenvolveu o Neural Engine, o Google investiu em TPUs e a Amazon cria o Trainium e o Inferentia. A OpenAI, desenvolvedora de modelos e não fabricante de chips, escolheu outro caminho: a parceria com a Cerebras permite que ela continue flexível e não fique presa a um único fornecedor.
O lançamento do Codex-Spark marca o início de uma nova etapa na estratégia da OpenAI: não só criar modelos melhores, mas também fazê-los rodar em hardware diversificado. Isso complica a vida dos concorrentes que ainda dependem do hardware padrão e fortalece a posição da OpenAI em ferramentas de IA para desenvolvedores. A questão agora é quão bem essa estratégia funcionará na prática e se a Cerebras conseguirá escalar seus chips rápido o bastante para a demanda crescente.
- 2 de nov. de 2026Assistente Muse, da Meta, mantém dossiê sobre pessoas próximas e recebe root no Ubuntu por padrão
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Kimi marca 96,2% em teste de análise em base 1C e vira reserva caso o Claude seja bloqueado
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.