OpenAI apresenta GPT-5.3-Codex-Spark, rodando em chips da Cerebras em vez de Nvidia
A OpenAI deu um passo importante rumo à independência de hardware com o GPT-5.3-Codex-Spark. Pela primeira vez, um produto principal da empresa foi treinado e executado não em GPUs da Nvidia, mas em chips Wafer Scale Engine 3 da startup Cerebras Systems. O WSE-3 é um enorme chip do tamanho de um wafer de silício inteiro, com poder de processamento colossal. A iniciativa visa diversificar as cadeias de suprimentos da OpenAI e reduzir a dependência dos escassos aceleradores da Nvidia. A migração para hardware alternativo pode mudar de forma significativa a economia do treinamento de grandes modelos de linguagem e acelerar o desenvolvimento de novas arquiteturas.
Processado por IA de 3DNews AI; editado por Hamidun News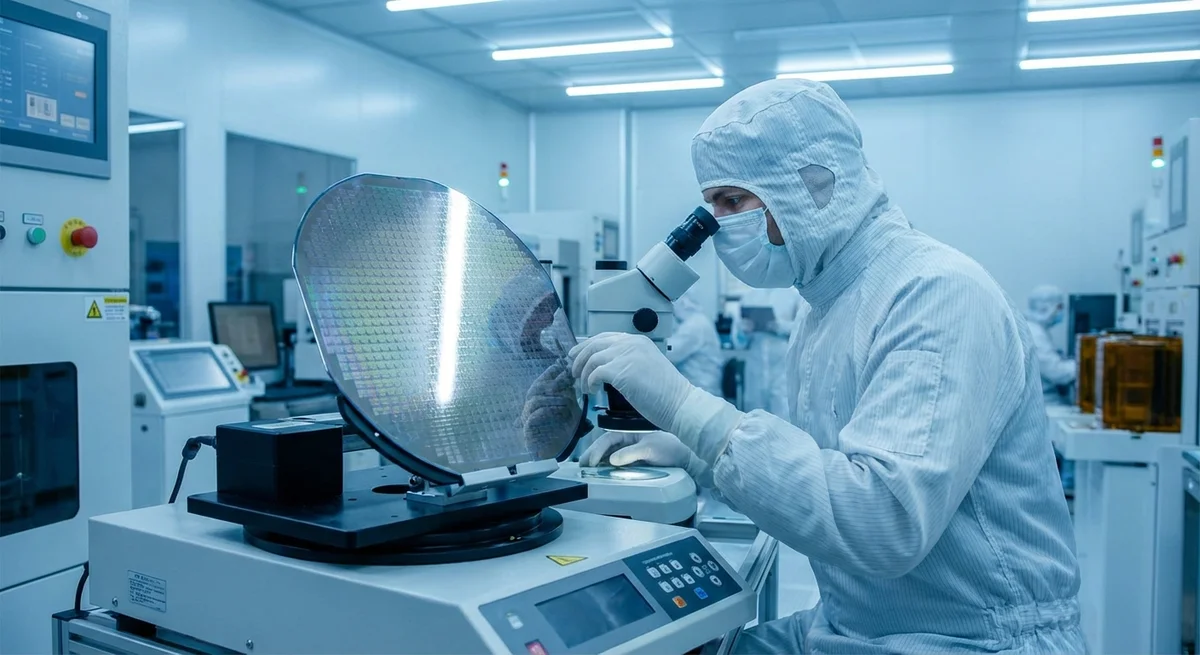
# OpenAI abandona a Nvidia. O que isso significa para o futuro da inteligência artificial
Na história dos grandes modelos de linguagem, aconteceu algo que muita gente considerava impossível. A OpenAI apresentou o GPT-5.3-Codex-Spark, o primeiro modelo principal da empresa treinado e implantado não em processadores gráficos da Nvidia, mas em chips alternativos Wafer Scale Engine 3, da Cerebras Systems. O passo diz menos sobre uma conquista técnica do que sobre uma virada na economia da inteligência artificial e na luta por independência das empresas mais poderosas do setor.
Nos últimos cinco anos, a Nvidia estabeleceu um controle quase monopolista do mercado de aceleradores para treinar redes neurais. Quando ficou claro que as arquiteturas transformer exigem um poder de processamento enorme, todos os grandes laboratórios, da OpenAI à Meta* e ao Google, apostaram em suas GPUs. Mas depender de um único fornecedor traz risco. Restrições à exportação para a China, escassez de chips e preços em alta pressionaram as empresas que tentam escalar seus modelos. A OpenAI sofreu em silêncio junto com todos, mas agora decidiu agir.
A Cerebras Systems propôs uma abordagem incomum. Em vez de criar milhares de processadores pequenos, a empresa projetou o WSE-3, um chip de silício monolítico do tamanho de um wafer inteiro, que não pode ser instalado em um soquete comum. Não é apenas um chip, mas uma minifazenda inteira em um único pedaço de silício, com mais de 900 mil núcleos. Parece que a solução vai contra os princípios de modularidade, mas foi justamente isso que permitiu à Cerebras evitar os gargalos de transferência de dados entre processadores separados, o principal inimigo do treinamento paralelo.
Quando a OpenAI testou o treinamento do GPT-5.3-Codex-Spark no WSE-3, os resultados foram inesperados. A velocidade de convergência do modelo ficou no nível do treinamento em Nvidia H100, mas foi necessária menos sincronização e movimentação de dados entre aceleradores. Ou seja, as horas de ociosidade da rede que a empresa gastava antes agora podem ser usadas em computação útil. Isso significa mais barato. Isso significa mais rápido.
Mas o principal não são os números técnicos, e sim o sentido estratégico. A OpenAI mostrou que existe alternativa à Nvidia e que grandes modelos podem ser treinados em outros chips que não os dela. É o primeiro desafio sério ao monopólio, e o mercado já reage. Outras empresas, como a Intel com o Gaudi, a AMD com EPYC e MI300 e até o Google com as TPUs, agora sabem que há uma janela de oportunidade. Se a OpenAI consegue retreinar um modelo em hardware novo e obter resultados comparáveis, elas também podem.
A economia da inteligência artificial vai mudar, mas não de imediato. A Cerebras ainda não consegue produzir WSE-3 nos volumes em que a Nvidia fabrica H100. Reconstruir a infraestrutura e reescrever o código para otimizar para a nova arquitetura vai levar tempo. Mesmo assim, o começo foi dado. Nos próximos dois a três anos, provavelmente veremos projetos de aceleradores mais extravagantes e experimentação mais ativa com chips neuromórficos e computadores quânticos. A Nvidia continuará sendo um player poderoso, mas não mais o único.
Para os usuários comuns do ChatGPT, isso praticamente não muda nada: o modelo continua o mesmo e as capacidades, iguais. Para o setor, porém, a diferença é enorme. A OpenAI provou que uma grande inteligência pode ser construída de outro jeito, e que na corrida por hardware quem manda não é quem chegou primeiro, mas quem pensa mais rápido.
*A Meta é reconhecida como organização extremista e proibida na Rússia.
- 2 de nov. de 2026Assistente Muse, da Meta, mantém dossiê sobre pessoas próximas e recebe root no Ubuntu por padrão
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Kimi marca 96,2% em teste de análise em base 1C e vira reserva caso o Claude seja bloqueado
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.