OpenAI apresenta modelo de programação ultrarrápido que dispensa chips da Nvidia
A OpenAI anunciou o GPT-5.3-Codex-Spark, um modelo de linguagem especializado em escrever código que apresenta ganho de desempenho de 15 vezes. A principal conquista é uma arquitetura otimizada para chips não convencionais do tamanho de um prato. O movimento permite à empresa acelerar bastante a geração de código e reduzir a dependência crítica das escassas GPUs da Nvidia. O desenvolvimento destaca a tendência de integração vertical entre software e hardware nos maiores laboratórios de IA do mundo.
Processado por IA de Ars Technica; editado por Hamidun News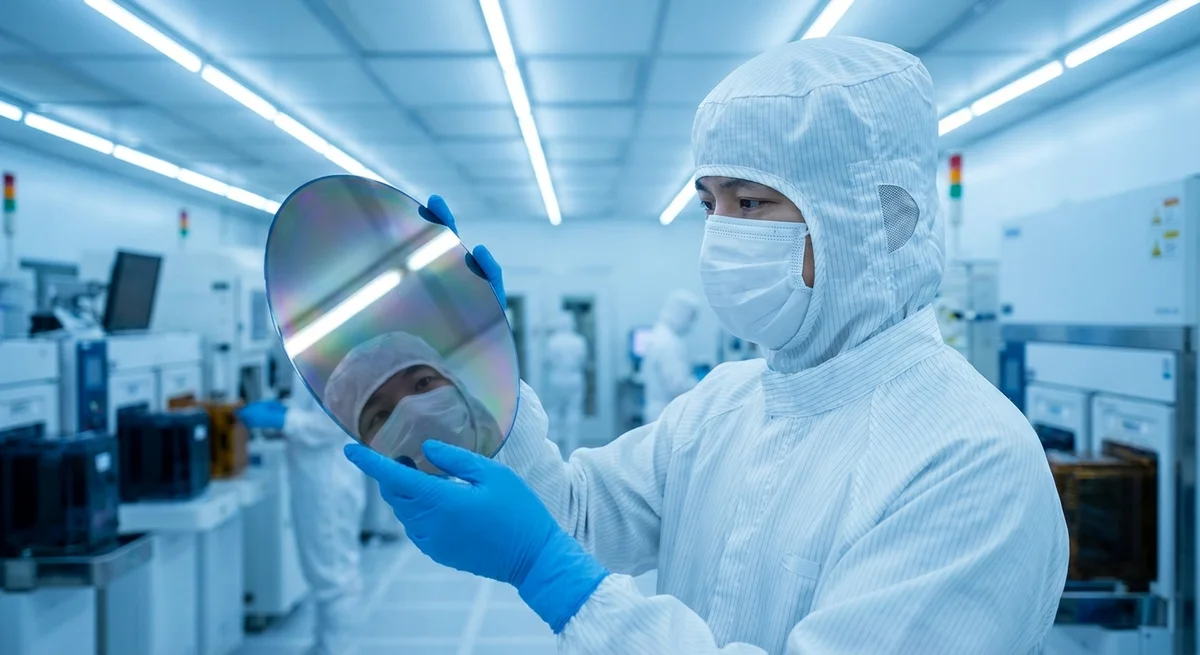
A OpenAI apresentou o GPT-5.3-Codex-Spark, um modelo especializado em geração de código que roda 15 vezes mais rápido que a versão anterior. Mas a verdadeira notícia não é tanto a velocidade, e sim como ela foi alcançada: a empresa otimizou a arquitetura para chips não convencionais do tamanho de um prato, na prática contornando a dependência crítica das escassas GPUs da Nvidia. A jogada mostra o desejo da OpenAI de controlar toda a pilha, do software ao hardware físico, e evidencia a rivalidade crescente no mercado de processadores especializados para IA.
Nos últimos dois anos, a Nvidia virou uma espécie de gargalo para todas as grandes empresas de IA. As GPUs H100 e A100, que se tornaram o padrão para treinar grandes modelos de linguagem, têm demanda enorme, e a oferta não acompanha. Os preços pesam, as entregas atrasam e as restrições geopolíticas complicam tudo. OpenAI, Meta*, Google: todas buscam reduzir a dependência da Nvidia ou otimizar o uso dos recursos que já têm. A x.AI, empresa de Elon Musk, anunciou recentemente um chip próprio, a Apple faz o mesmo com o Neural Engine, e a Amazon investe nos processadores Trainium e Inferentia. O mercado se fragmenta, e a OpenAI decidiu não ficar para trás.
O GPT-5.3-Codex-Spark é um desenvolvimento com foco definido. Enquanto modelos de uso geral, como o GPT-4o, precisam dar conta de muitas tarefas, o Codex mira numa só: escrever código o mais rápido e com a maior precisão possível.
Isso permitiu aos engenheiros da OpenAI fazer uma otimização profunda. Eles reformularam a arquitetura para as particularidades da programação, removeram camadas de computação redundantes e reestruturaram as operações tensoriais. O resultado é a mesma qualidade de saída com custo computacional bem menor.
Mas a mudança principal veio na camada de hardware. A OpenAI desenvolveu, ou repensou para si, chips não convencionais que trabalham com essa arquitetura de forma nativa. Esses processadores são mais compactos que as GPUs padrão, se integram com mais facilidade e exigem menos energia e refrigeração, tudo o que deixa os data centers mais baratos e mais resistentes a falhas.
O ganho de desempenho de 15 vezes impressiona, mas o número precisa de contexto. Muito provavelmente, isso não significa que o modelo faça os cálculos diretos 15 vezes mais rápido. Trata-se do tempo de geração de código de ponta a ponta, da solicitação do usuário até a saída pronta. Aqui as melhorias se somam: arquitetura otimizada, chips especializados e um pipeline de processamento reformulado. É uma abordagem típica da indústria de IA: o algoritmo mais eficiente no hardware mais eficiente entrega o melhor resultado.
Para a indústria, isso significa várias coisas ao mesmo tempo. Primeiro, a pressão sobre a Nvidia aumenta. Se outras empresas passarem a usar chips próprios com sucesso, a demanda por GPUs pode cair. Segundo, reforça a tendência de integração vertical nos laboratórios de IA. Apple, Google, Meta* e agora a OpenAI desenvolvem chips próprios. Terceiro, é uma boa notícia para os desenvolvedores: um gerador de código mais rápido e barato pode reduzir o custo de uso das APIs e tornar os assistentes de IA mais acessíveis.
Mas a OpenAI não vai se livrar totalmente da Nvidia. Os modelos de uso geral ainda exigem GPUs potentes no treinamento. Os chips próprios da OpenAI, ao que parece, são otimizados especificamente para inferência, ou seja, para executar modelos já treinados. Faz sentido: o treinamento acontece raramente, enquanto as solicitações dos usuários chegam o tempo todo. A OpenAI encontrou um jeito de controlar justamente a camada em que dá para ganhar dinheiro em escala. E é uma jogada estratégica acertada.
*A Meta foi reconhecida como organização extremista e é proibida na Rússia.
- 2 de nov. de 2026Assistente Muse, da Meta, mantém dossiê sobre pessoas próximas e recebe root no Ubuntu por padrão
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Kimi marca 96,2% em teste de análise em base 1C e vira reserva caso o Claude seja bloqueado
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.