Robôs presos nos dados: por que os vídeos de salto mortal são só o começo
Vídeos virais criam a ilusão de um avanço tecnológico, mas o progresso real é freado por uma "crise de dados". Ao contrário das IAs de texto, os robôs precisam de dados multidimensionais do mundo físico: visão, tato e força. A China está construindo centros de coleta de dados em massa, onde operadores ensinam tarefas básicas às máquinas manualmente. Os principais problemas são o alto custo dos dados "ao vivo" e a incompatibilidade de equipamentos de fabricantes diferentes. Especialistas comparam esta fase ao início do piloto automático e destacam que o caminho até robôs assistentes universais será muito mais difícil e caro do que parecia no começo.
Processado por IA de 36Kr (36氪); editado por Hamidun News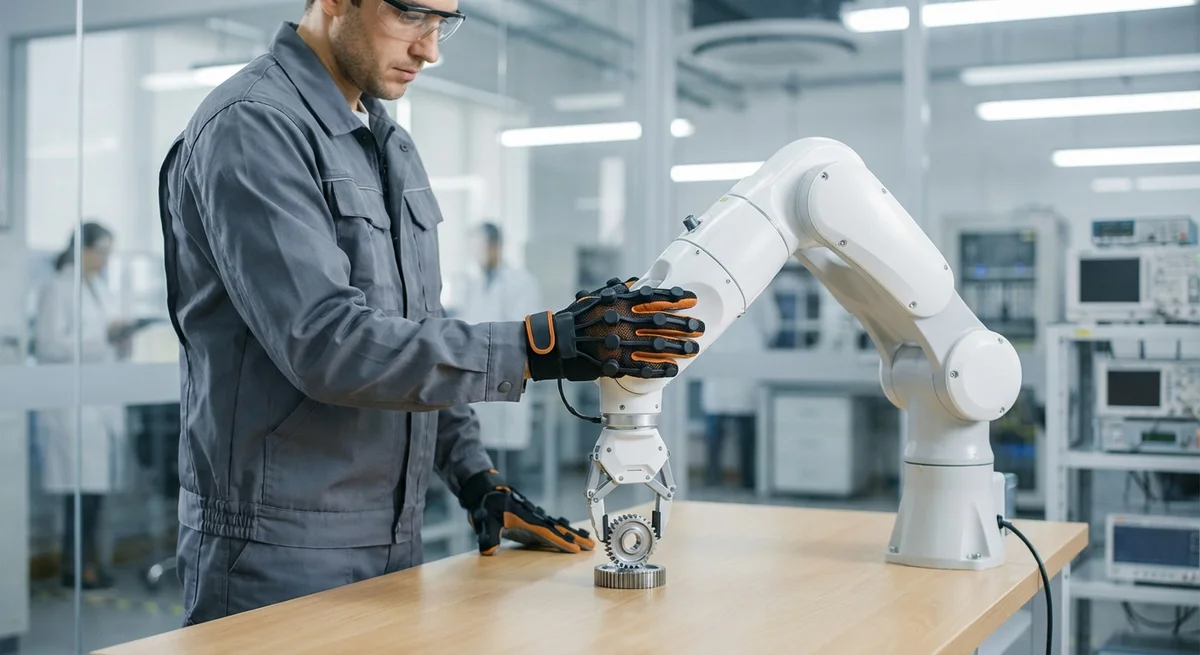
# Robôs presos nos dados: por que os vídeos de salto mortal são só o começo
No último ano, a internet foi inundada por vídeos de truques impressionantes: robôs pulam, dançam, desferem socos e quebram melancias com um chute. Os investimentos crescem, a imprensa está cheia de manchetes otimistas e o público tem certeza de que a era dos robôs assistentes domésticos está prestes a começar. Mas, ao olhar os bastidores desse teatro tecnológico, o quadro se revela bem mais complexo e mais triste.
Neste exato momento, em silenciosos centros de preparação de dados por toda a China, operadores humanos de luvas controlam manipuladores de forma lenta, quase penosa, ensinando as máquinas a pegar peças, guardar ferramentas e fechar tampas de caixas. Essa cena não tem nada da aura cinematográfica dos vídeos virais, mas é ela que define o progresso real da robótica. Entre um truque impressionante e um ajudante doméstico útil existe um problema fundamental: a falta catastrófica de dados de qualidade.
Modelos de linguagem como ChatGPT e DeepSeek se apoiam no triunfo de uma lógica simples: milhares de bilhões de exemplos de texto da internet permitiram que a IA entendesse a linguagem e passasse a gerar conteúdo com sentido. Já a robótica encara uma realidade bem diferente. Os dados de texto vivem em um espaço digital bidimensional e são fáceis de copiar e distribuir, mas o mundo físico é um fluxo de informação multidimensional e contínuo.
Um robô precisa perceber o mundo por vários canais ao mesmo tempo: vídeo de várias câmeras, sensores de força, sensores de toque, informações sobre a posição das articulações. Cada operação realizada pelo manipulador gera dados estruturados, com 57 dimensões em alguns sistemas. E todos esses fluxos precisam estar perfeitamente sincronizados até o milissegundo; do contrário, o modelo aprenderá pura alucinação em vez de uma relação de causa e efeito.
A China já tem mais de cinquenta centros de coleta e processamento de dados de robótica. Só em Pequim, um desses centros produz cerca de seis mil registros de exemplos de treinamento por dia. Uma extrapolação grosseira indica que a produção anual pode chegar a dezenas de bilhões de exemplos.
Parece impressionante, mas na prática é uma gota no oceano do que se precisa. Especialistas da empresa PowerTech fizeram um cálculo conservador: para um robô aprender um movimento, são necessários cerca de mil a cinco mil exemplos. Uma tarefa simples, composta por alguns movimentos, exige de dez mil a vinte mil.
Mas um robô universal capaz de dar conta de oitenta por cento dos trabalhos humanos em um setor exigiria um conjunto de dados de cem milhões. E, se a ambição alcançar milhares de setores, falamos de trilhões de exemplos. O déficit é de quatro a cinco ordens de magnitude.
Mas esse ainda não é o problema mais sério. A incompatibilidade de equipamentos se mostrou bem mais traiçoeira. Cada fabricante cria robôs com configurações de sensores, protocolos de controle e parâmetros físicos diferentes. Os dados coletados em um modelo de manipulador muitas vezes simplesmente não funcionam em outro: a linguagem de uma máquina continua totalmente estranha à outra. Isso significa que o conhecimento não se soma nem se acumula em um ativo comum da indústria. Cada fabricante precisa montar seu próprio conjunto de dados do zero, repetindo várias vezes o mesmo trabalho caro.
Alguns centros lidam com esse dilema concentrando-se em modelos populares, na prática ignorando a diversidade. Outros seguem um caminho mais ambicioso: coletam dados de robôs de diferentes fabricantes em um espaço único, tentando ensinar o modelo a generalizar o conhecimento para equipamentos heterogêneos. Nenhuma das abordagens provou ainda ser universal.
Tudo isso lembra os primeiros dias do piloto automático, uma época em que parecia que o problema estava nos algoritmos, e não nos dados. Passaram-se quase vinte anos e bilhões em investimentos, e a verdade estava por perto, mas não exatamente onde era procurada. Antes que os robôs de fato entrem em nossas casas, ainda há um trabalho longo e tedioso pela frente nos centros de dados, onde pessoas de luvas ensinarão com paciência as máquinas a entender o mundo físico. Vídeos virais são marketing. O progresso real é uma história totalmente diferente.
- 2 de nov. de 2026Framework AICG, da NC State, reduz o MAE em 50,3% na correção de respostas de matemática
- 2 de nov. de 2026Verificamos 929 automações na Alpina: como deve ser o treinamento corporativo em IA em 2026
- 2 de nov. de 2026Interroguei 6 IAs sobre mim como um comprador corporativo: Amazon, esoterismo, «Telo Hudelo» e 5 brechas que fechamos em um dia
- 2 de nov. de 2026TJ Digital: 23% das páginas citadas por IA começam com resposta direta, contra 14% das não citadas
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.