Autor animou uma pintura do século XIX camada por camada: para cada clipe bom, 4 a 5 ruins
Se você entregar a pintura inteira a um modelo de vídeo, ele vai redesenhar rostos, uniformes e a ponte. Por isso, o autor separou o quadro de Alma-Tadema sobre a travessia do Berezina em camadas no Photoshop, animou as figuras uma a uma no MiniMax H3 e montou a cena no After Effects. O preço do controle é tempo: para cada clipe aproveitável, havia de 4 a 5 descartados. Em cenas complexas, compensa dividir a tarefa e verificar cada pedaço.
Processado por IA de Habr AI; editado por Hamidun News
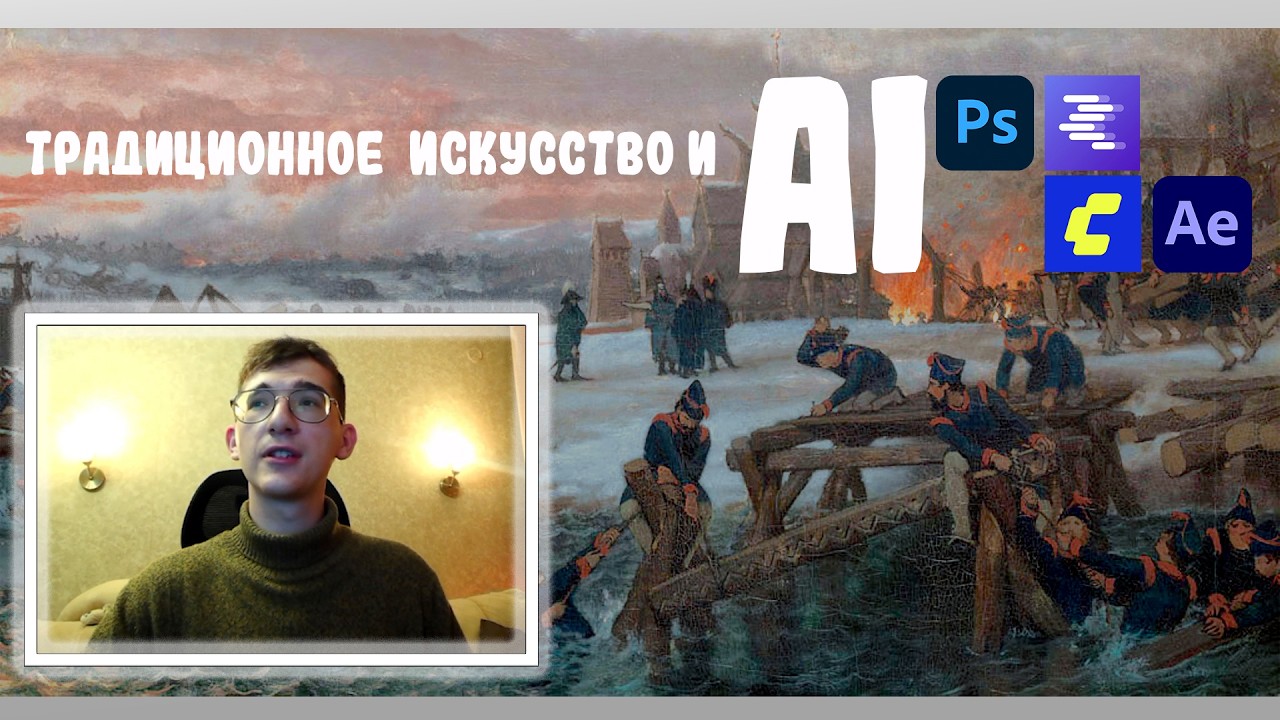
Geradores de vídeo aprenderam a movimentar imagens de forma bonita, mas, ao receber uma cena complexa com dezenas de pessoas, passam a inventar por conta própria: trocam rostos, uniformes, arquitetura e até o número de mãos. Imagine pedir a um modelo que anime uma pintura histórica e receber um soldado com outra roupa e uma ponte construída no sentido oposto. O autor Dmitrii (canal Dmitrii DAK, no Habr) contornou esse problema com a obra de Lawrence Alma-Tadema «Anno 1812.
Kapitein Benthien aan de Beresina», que mostra pontoneiros holandeses construindo uma travessia sobre o Berezina durante a retirada do exército de Napoleão. Em vez de um único pedido do tipo «anime tudo», ele dividiu o trabalho em pequenos pedaços controláveis. O preço desse controle é o tempo: segundo sua observação, para cada clipe aproveitável surgem de 4 a 5 gerações malsucedidas ou «quase» boas.
Trata-se da experiência de um único processo, e não de uma estatística universal, mas ela mostra bem onde a energia realmente se perde.
Primeiro as camadas, depois o movimento
A primeira etapa acontece no Photoshop. O autor seleciona personagens e objetos, passa cada um para uma camada separada e agrupa as camadas por significado: água, pessoas, construções. A regra principal é que os fragmentos mantêm o sistema de coordenadas original da tela, sem recorte até o retângulo mínimo. Assim, no After Effects as camadas se encaixam sem ajuste manual de escala e posição.
Em seguida surge o problema dos buracos. Se você remove um soldado, atrás dele devem aparecer tábuas, o ombro de outra pessoa, neve. Essas áreas são completadas por inpainting (repintura do fundo por uma rede neural), de modo que cor, luz, direção das pinceladas e perspectiva coincidam. Numa imagem parada a emenda passa despercebida, mas em movimento o fundo começa a deslizar em relação à figura, por isso o autor verifica as junções com especial cuidado.
Um passo à parte são os rostos. Na pintura, muitas figuras são pequenas, e na animação um rosto borrado entrega a substituição. Os personagens passam por um aprimoramento de detalhes com a condição de não alterar pose, proporções e o caráter pictórico. Além disso, o fundo atrás deles é trocado por verde: depois ele é removido na composição com a pipeta, porque atrás ficam outros personagens animados.
Um LLM local escreve os prompts, o MiniMax H3 movimenta os fragmentos
Para não escrever descrições longas à mão, o autor roda no LM Studio um modelo multimodal local, o Qwen 3.8 27B na quantização Q5_K_XL (versão compactada que cabe na memória de vídeo). A ele são fornecidos três elementos: a descrição básica do movimento desejado, o próprio fragmento da pintura e uma lista de restrições (roupas, aparência, posição dos vizinhos, câmera fixa). O modelo analisa a imagem e gera um prompt detalhado em inglês. Por exemplo: oito soldados de uniforme escuro avançam da esquerda para a direita pela margem nevada carregando toras, câmera estática, plano médio em 35 mm, textura da tela.
O vídeo é gerado no ComfyUI com o modelo MiniMax H3. Para acelerar, o autor usa uma LoRA de 10 passos (um pequeno complemento que permite calcular mais rápido), SageAttention e o nó Spectrum. O primeiro plano foi feito em 1,8 megapixel (1824×1024), e os demais planos, em 0,3 megapixel (736×416).
O resultado é avaliado não pelo critério de «bonito ou não», mas pela aptidão para a montagem:
- se a pose original foi preservada;
- se não mudaram o número de objetos e membros;
- se a mão ou a perna de um personagem não atravessa outro;
- se o movimento corresponde à física do ambiente.
É justamente por esses critérios que se acumulam as tais 4 a 5 tentativas malsucedidas para cada uma bem-sucedida. A cena com oficiais e toras teve de ser refeita mais de 15 vezes: um oficial atravessava o soldado que consertava a ponte. Pessoas na água gelada até a cintura, empurrando toras e se segurando umas nas outras, saem piores do que as figuras na margem.
Montagem no After Effects e o custo do experimento
No After Effects, as camadas e os clipes gerados são posicionados segundo as coordenadas originais. Para separar as figuras do fundo, usa-se o Roto Brush: o autor verifica a estabilidade da máscara, corrige as bordas e observa com atenção roupas, mãos e pernas, onde os erros aparecem com mais nitidez. No fim, ele iguala cor e luz para que os fragmentos não destoem da pintura como um todo.
O trabalho foi feito numa estação com Intel Core i9-14900K e NVIDIA GeForce RTX 5090 com 32 GB de memória de vídeo, inteiramente localmente. O autor ressalta que essa placa de vídeo não é obrigatória: as etapas podem ser executadas em hardware mais modesto, com versões mais leves dos modelos ou com a geração na nuvem. Nesse caso, mudam a resolução, a velocidade e o conjunto de modelos disponíveis.
O que isso significa na prática
O artigo descreve a experiência de um único autor, e não um benchmark reproduzível, e essa é a principal limitação do texto. Mesmo assim, a conclusão se aplica de forma mais ampla. Quanto mais complexa a cena, mais compensa dividi-la em pedaços independentes e colocar uma pessoa para verificar cada etapa.
A duração do vídeo final reflete mal o esforço: alguns segundos de animação podem custar dezenas de gerações e retoques manuais. Se o mesmo for feito na nuvem, o custo será medido em tokens ou créditos, e o orçamento deve prever uma folga de 4 a 5 tentativas por fragmento. Para instalações em museus, exposições e projetos educacionais, esse pipeline entrega algo que um único pedido ao modelo de vídeo não entrega: a composição original preservada.
- 21 de nov. de 2026MLCommons começou a medir APIs de IA sob carga real: 7 medições para agentes
- 21 de nov. de 2026Unsloth atualizou os modelos comprimidos do Qwen3.8-27B: precisão sobe 5–10% com o mesmo tamanho
- 21 de nov. de 2026Google abre pré-venda de óculos inteligentes com Gemini a partir de US$ 395 — vendas começam em 10 de dezembro
- 21 de nov. de 2026Por meio do OpenRouter, DeepSeek adulterada respondeu por três dias: recusas caíram de 83–98% para 1%
Perguntas frequentes sobre a notícia
O que se sabe sobre Primeiro as camadas, depois o movimento?
A primeira etapa acontece no Photoshop. O autor seleciona personagens e objetos, passa cada um para uma camada separada e agrupa as camadas por significado: água, pessoas, construções. A regra principal é que os fragmentos mantêm o sistema de coordenadas original da tela, sem recorte até o retângulo mínimo. Assim, no After Effects as camadas se encaixam sem ajuste manual de escala e posição. Em seguida surge o problema dos buracos.
O que se sabe sobre Um LLM local escreve os prompts, o MiniMax H3 movimenta os fragmentos?
Para não escrever descrições longas à mão, o autor roda no LM Studio um modelo multimodal local, o Qwen 3.8 27B na quantização Q5_K_XL (versão compactada que cabe na memória de vídeo). A ele são fornecidos três elementos: a descrição básica do movimento desejado, o próprio fragmento da pintura e uma lista de restrições (roupas, aparência, posição dos vizinhos, câmera fixa). O modelo analisa a imagem e gera um prompt detalhado em inglês.
O que se sabe sobre Montagem no After Effects e o custo do experimento?
No After Effects, as camadas e os clipes gerados são posicionados segundo as coordenadas originais. Para separar as figuras do fundo, usa-se o Roto Brush: o autor verifica a estabilidade da máscara, corrige as bordas e observa com atenção roupas, mãos e pernas, onde os erros aparecem com mais nitidez. No fim, ele iguala cor e luz para que os fragmentos não destoem da pintura como um todo.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.