Wikipédia abre seu conteúdo a empresas de IA por meio de acordos de licenciamento
A Wikimedia Enterprise firmou acordos de licenciamento com grandes empresas de IA, entre elas Microsoft, Meta e Amazon. Agora elas poderão usar o conteúdo da Wikipédia para treinar seus modelos, o que marca uma nova etapa no desenvolvimento da IA e na monetização do conhecimento. *A Meta é considerada organização extremista e está proibida na Rússia.
Processado por IA de Ars Technica; editado por Hamidun News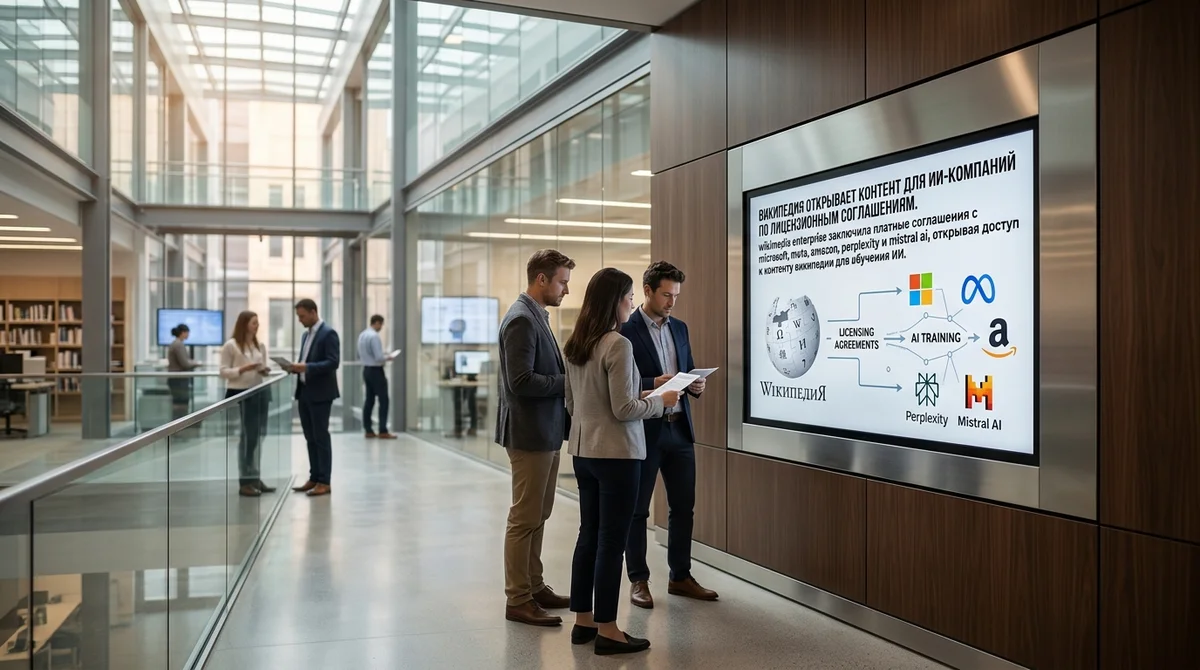
A Wikipédia, uma das maiores fontes de conhecimento do mundo, está abrindo as portas para a inteligência artificial. A Wikimedia Enterprise, braço comercial da Fundação Wikimedia, firmou uma série de acordos de licenciamento com gigantes de tecnologia como Microsoft, Meta e Amazon, além das startups promissoras Perplexity AI e Mistral AI. Os acordos dão às empresas de IA acesso ao enorme volume de dados da Wikipédia para treinar e aprimorar seus modelos.
Por muito tempo, a Wikipédia foi um recurso gratuito e aberto, acessível a todos. Mas, com a popularização dos grandes modelos de linguagem (LLMs), a demanda por dados de qualidade para treiná-los disparou. A Wikimedia Enterprise enxergou aí a chance de monetizar seu conteúdo sem violar os princípios de abertura e acessibilidade que sustentam a Wikipédia. As licenças pagas oferecem às empresas acesso estruturado e otimizado aos dados, além de suporte técnico, o que simplifica bastante o treinamento de modelos de IA.
O que isso significa para a indústria de IA? Primeiro, garante acesso a um enorme volume de informações verificadas e estruturadas, algo crítico para treinar LLMs de qualidade e confiáveis. A Wikipédia reúne milhões de artigos em vários idiomas, cobrindo uma ampla gama de temas, da história e da ciência à cultura e à tecnologia. Usar esses dados deve ajudar os modelos de IA a entender melhor o mundo e a gerar respostas mais relevantes e precisas. Segundo, os acordos de licenciamento trazem uma fonte sustentável de financiamento para a Fundação Wikimedia, o que deve permitir que ela continue apoiando e desenvolvendo a Wikipédia como recurso global de conhecimento.
Mas a decisão também traz riscos potenciais. É importante que o uso do conteúdo da Wikipédia respeite os princípios de neutralidade e objetividade que sustentam a enciclopédia. É preciso evitar que modelos de IA treinados com dados da Wikipédia espalhem desinformação ou opiniões enviesadas. A Fundação Wikimedia precisa acompanhar de perto o uso de seu conteúdo e reagir rapidamente a qualquer violação. Além disso, é importante garantir transparência sobre quais dados da Wikipédia são usados para treinar cada modelo de IA.
Fechar acordos de licenciamento com empresas de IA é um passo importante para a Wikipédia e para toda a indústria de inteligência artificial. Isso abre novas possibilidades para o desenvolvimento da IA, mas exige uma abordagem responsável e o respeito aos princípios de abertura e neutralidade. No futuro, é provável que outras grandes fontes de dados sigam o exemplo da Wikipédia e passem a monetizar seu conteúdo para treinamento de IA. Isso pode levar à formação de um novo mercado de dados para IA, que, por sua vez, teria impacto significativo no desenvolvimento das tecnologias de inteligência artificial.
*A Meta é considerada organização extremista e está proibida na Rússia.
- 2 de nov. de 2026Assistente Muse, da Meta, mantém dossiê sobre pessoas próximas e recebe root no Ubuntu por padrão
- 2 de nov. de 2026Jornalista da The Verge monta um rival do Meta Muse Charm por $50 com ajuda do Claude Code
- 1 de nov. de 2026Camada de proteção MoneyGate barrou os 42 pedidos fraudulentos feitos a IAs locais
- 31 de out. de 2026Gateway de LLM open source KTMS 1.0 conecta GPUs próprias à nuvem e sobrevive a falhas
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.