PostgreSQL na OpenAI: como escalar o banco de dados do ChatGPT
A OpenAI compartilhou sua experiência escalando o PostgreSQL para sustentar o ChatGPT. A equipe usou replicação, cache, limitação de taxa e isolamento de cargas de trabalho para chegar a milhões de consultas por segundo. Este texto analisa a arquitetura e as decisões tomadas.
Processado por IA de OpenAI Blog; editado por Hamidun News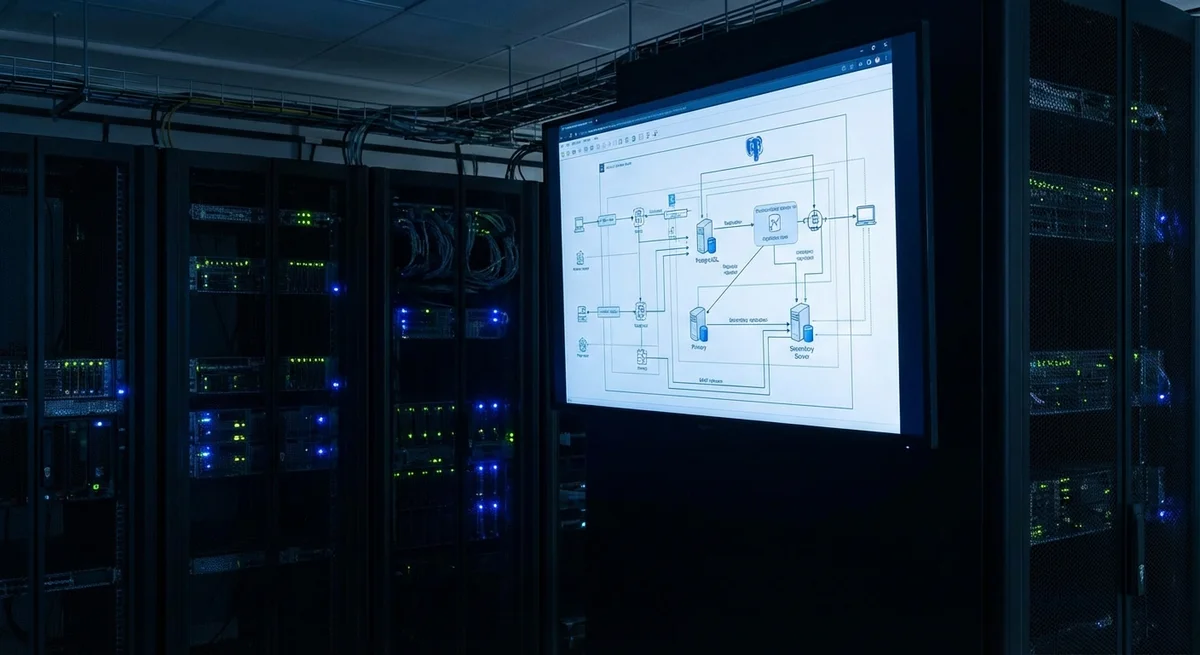
Quando o ChatGPT decolou, a equipe da OpenAI enfrentou um desafio sério: garantir que o PostgreSQL, banco de dados que sustenta todo o sistema, funcionasse de forma estável e rápida. Era preciso atender centenas de milhões de usuários e processar milhões de consultas por segundo. Resolver isso exigiu bem mais do que adicionar hardware: foi necessário repensar a fundo a arquitetura e aplicar uma série de truques de engenharia.
Apesar da maturidade e da confiabilidade, o PostgreSQL não foi projetado originalmente para cargas tão extremas. Os métodos tradicionais de escalonamento, como o vertical (aumentar a potência de um único servidor), logo bateram no teto. Ficou claro que era preciso uma abordagem horizontal: distribuir a carga entre vários servidores. A OpenAI optou pela replicação, criando muitas cópias do banco de dados somente para leitura. Isso aliviou bastante o servidor principal e aumentou a vazão total.
Mas a replicação é apenas parte da solução. Para otimizar ainda mais, a equipe usou cache, que mantém na memória os dados mais requisitados e evita consultar o banco a cada requisição. Também foi implantado um sistema de limitação de taxa (rate limiting), que impediu a sobrecarga do sistema em picos bruscos de tráfego. Por fim, o isolamento de cargas de trabalho teve papel importante: os diferentes tipos de consulta foram separados em servidores distintos, para evitar conflitos e dar prioridade às operações mais importantes.
Com esses métodos, a OpenAI não só deu conta da carga atual, como criou uma arquitetura escalável, pronta para crescer mais. É um precedente importante para todo o setor, que mostra que até tecnologias maduras, como o PostgreSQL, podem sustentar com sucesso as aplicações de IA mais exigentes. A experiência da OpenAI mostra a importância de uma abordagem abrangente, que combine replicação, cache, limitação de taxa e isolamento de cargas de trabalho.
As consequências vão muito além da OpenAI. Outras empresas que lidam com grandes volumes de dados e cargas altas podem usar essas práticas para otimizar seus próprios sistemas. Isso vale em especial para plataformas de e-commerce, redes sociais e outros serviços que precisam de acesso instantâneo a grandes volumes de informação. Além disso, essa experiência pode estimular o desenvolvimento do PostgreSQL e de outros bancos de dados, com foco em escalabilidade e desempenho.
Em conclusão, o sucesso da OpenAI ao escalar o PostgreSQL não é apenas uma conquista técnica, mas uma lição importante para todo o setor. Ele mostra que a abordagem certa de arquitetura e otimização pode permitir que até tecnologias maduras resolvam as tarefas mais complexas. Isso abre novas possibilidades para a IA e outras áreas que exigem o processamento de grandes volumes de dados.
- 2 de nov. de 2026Framework AICG, da NC State, reduz o MAE em 50,3% na correção de respostas de matemática
- 2 de nov. de 2026Verificamos 929 automações na Alpina: como deve ser o treinamento corporativo em IA em 2026
- 2 de nov. de 2026Interroguei 6 IAs sobre mim como um comprador corporativo: Amazon, esoterismo, «Telo Hudelo» e 5 brechas que fechamos em um dia
- 2 de nov. de 2026TJ Digital: 23% das páginas citadas por IA começam com resposta direta, contra 14% das não citadas
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.