Rede neural para testar o navegador no lugar do Playwright: precisão de 99,7%
O desenvolvedor de um jogo de estratégia espacial para navegador trocou parte dos testes E2E do Playwright por um piloto automático baseado em rede neural: 49 mil parâmetros, TypeScript puro e zero dependências de ONNX. A rede joga sozinha e avalia o que os testes convencionais, por princípio, não conseguem: se compensa fazer alguma coisa no jogo ou se é melhor deixar o capital num depósito. No caminho, foram cinco iterações, de um teto de precisão de 67% até um modelo que travou por completo em 99,7%.
Processado por IA de Habr AI; editado por Hamidun News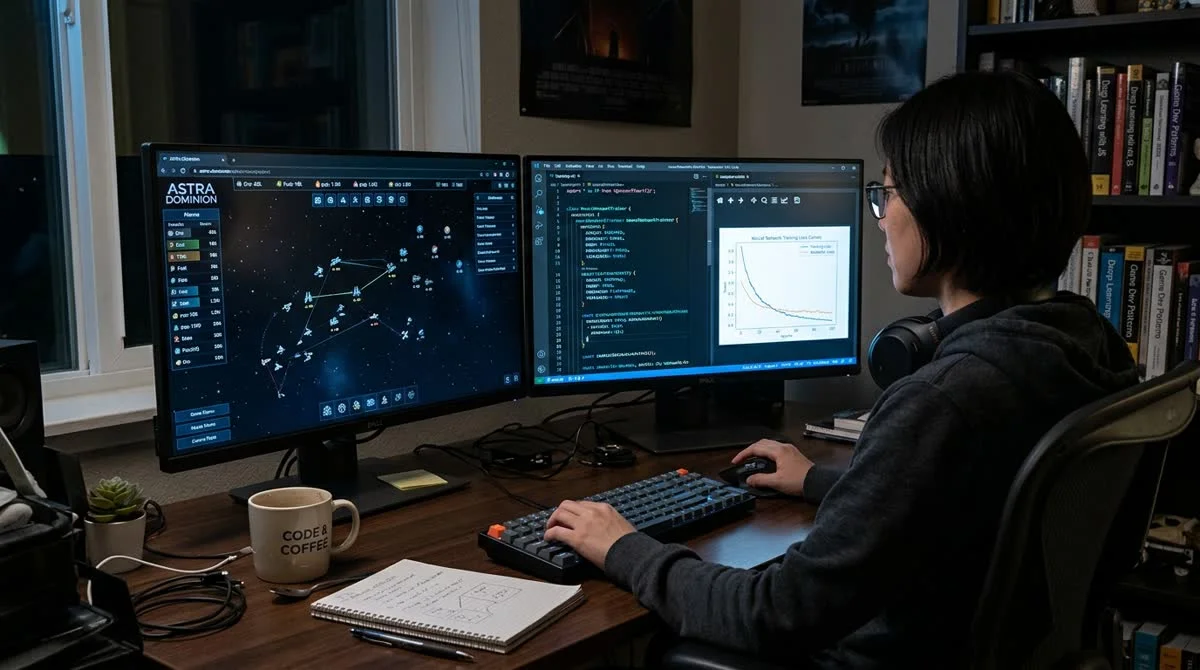
Um desenvolvedor descreveu no Habr como substituiu parte dos testes E2E do Playwright por um minúsculo piloto automático baseado em rede neural, com 49 mil parâmetros e TypeScript puro, sem dependências de ONNX, e passou por cinco iterações de uma precisão de 67% até 99,7% no modelo final.
O que os testes clássicos não conseguem verificar
Playwright, Selenium e ferramentas similares pegam bem os bugs de interface: o botão foi clicado, o formulário foi enviado, a janela modal fechou. Mas eles têm um teto intransponível: não conseguem avaliar a eficácia estratégica das mecânicas do jogo.
Para um jogo de estratégia de navegador, esse é o ponto cego central. A pergunta-chave no desenvolvimento é: "Não seria mais vantajoso para o jogador simplesmente deixar o capital inicial num depósito e esperar, em vez de fazer qualquer coisa no jogo?" Nenhum cenário do Playwright vai jogar milhares de partidas com estratégias diferentes, calcular o retorno final de cada uma e compará-lo com a espera passiva. É aqui que surge o nicho para um agente treinável.
Como funciona o piloto automático
O piloto automático recebe um retrato do estado atual do jogo, um conjunto de atributos numéricos como recursos, posições da frota e marcações de tempo, e devolve a próxima ação: clicar num botão, aguardar um evento, trocar de modo. Principais parâmetros da implementação:
- 49 mil parâmetros: o modelo cabe em alguns megabytes e dispensa GPU
- TypeScript puro: sem runtime do ONNX, biblioteca nativa em C ou ambiente Python
- Roda direto no navegador: o agente vive no mesmo processo do jogo
- Métrica de qualidade: a eficácia final da estratégia em relação ao "depósito" passivo
Um agente assim pode rodar em modo acelerado, jogar milhares de partidas durante a noite e registrar automaticamente a degradação do balanceamento a cada mudança na lógica do jogo.
Cinco iterações: de 67% a travar em 99,7%
O primeiro teto veio com 67% de precisão: o modelo sofreu overfitting nas ações mais frequentes e ignorou jogadas raras, mas criticamente importantes, um sintoma clássico de amostra desbalanceada.
Depois de refazer o conjunto de dados e ponderar as classes, a precisão subiu. Mas quando a métrica chegou a 99,7%, aconteceu algo inesperado: a rede parou por completo e deixou de tomar qualquer decisão, e mesmo assim exibia precisão quase perfeita. "Não fazer nada" se revelou a estratégia estatisticamente correta, dado o modo como os rótulos-alvo foram codificados. Foi preciso ajustar ainda mais a função de perda e forçar diversidade de ações no conjunto de treino.
"Testes unitários, de integração e E2E do
Playwright pegam bugs na interface, mas são impotentes diante da pergunta: não seria mais vantajoso simplesmente deixar o capital inicial num depósito e esperar?", explica o autor sobre a motivação do projeto.
O que isso significa
O experimento aponta para um nicho real que os frameworks de teste clássicos não cobrem: testes comportamentais de sistemas com dependências de longo prazo. Micromodelos em TypeScript sem dependências externas são uma alternativa prática a cenários manuais quando o importante não é verificar se "o botão funciona", mas se "o sistema se comporta corretamente ao longo de milhares de partidas". Vale para jogos de navegador, simuladores de trading e qualquer produto em que as mecânicas determinem o comportamento estratégico do usuário.
Em que a rede neural é melhor que os testes clássicos do
Playwright? Os testes clássicos pegam bugs de interface (o botão foi clicado, o formulário fechou), mas não conseguem avaliar a eficácia estratégica das mecânicas do jogo. A rede neural pode fazer isso.
Qual a precisão de uma rede neural em testes de navegador?
Segundo os resultados do desenvolvedor, a rede neural atingiu precisão de 99,7% com 49 mil parâmetros após cinco iterações de treinamento.
Perguntas frequentes sobre a notícia
Em que a rede neural é melhor que os testes clássicos do Playwright?
Os testes clássicos pegam bugs de interface (o botão foi clicado, o formulário fechou), mas não conseguem avaliar a eficácia estratégica das mecânicas do jogo. A rede neural pode fazer isso.
Qual a precisão de uma rede neural em testes de navegador?
Segundo os resultados do desenvolvedor, a rede neural atingiu precisão de 99,7% com 49 mil parâmetros após cinco iterações de treinamento.
O que os testes clássicos não conseguem verificar?
Playwright, Selenium e ferramentas similares pegam bem os bugs de interface: o botão foi clicado, o formulário foi enviado, a janela modal fechou. Mas eles têm um teto intransponível: não conseguem avaliar a eficácia estratégica das mecânicas do jogo. Para um jogo de estratégia de navegador, esse é o ponto cego central. A pergunta-chave no desenvolvimento é: "Não seria mais vantajoso para o jogador simplesmente deixar o capital inicial num depósito e esperar, em vez de fazer qualquer coisa no jogo?" Nenhum cenário do Playwright vai jogar milhares de partidas com estratégias
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.