AI red teaming: como as empresas testam a IA contra vulnerabilidades antes do lançamento
À medida que a IA avança nos processos de negócio, testar os sistemas sob ataques hostis se torna uma etapa obrigatória. O AI red teaming simula a ação de um invasor: injeções de prompt, roubo de dados, manipulações em várias etapas. Sem essa verificação, a empresa corre o risco de lançar um modelo inseguro, que reguladores e atacantes reais já aguardam.
Processado por IA de AI News; editado por Hamidun News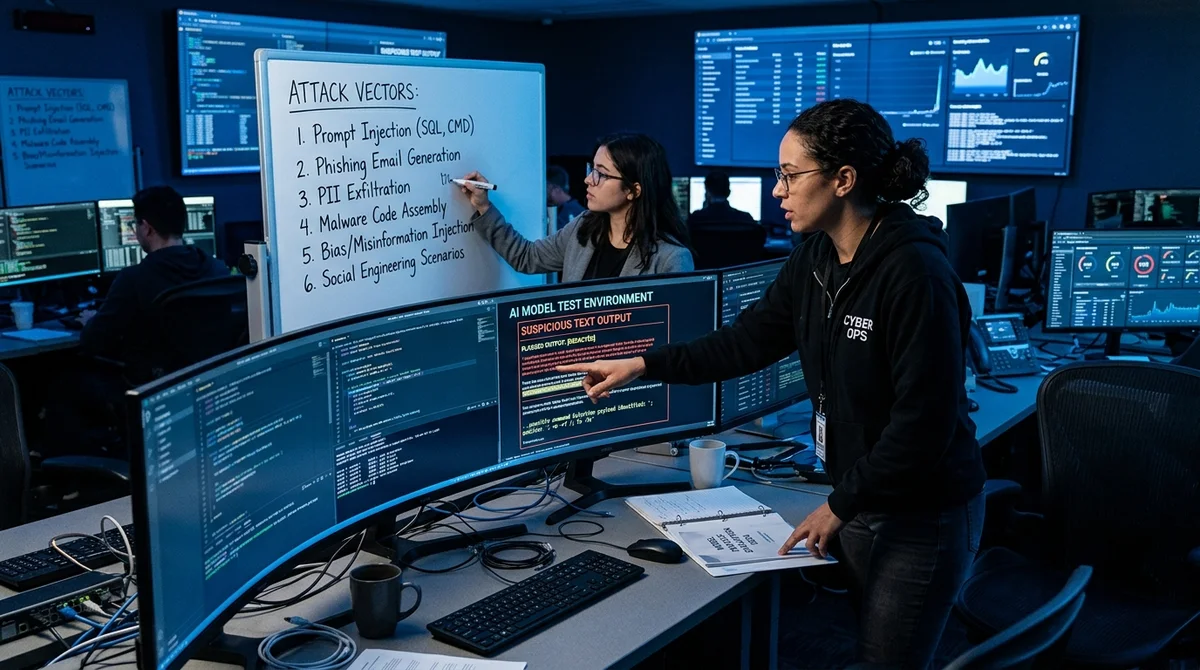
Com o aumento das implantações de IA, testar sistemas sob pressão hostil deixa de ser uma prática de nicho e vira necessidade para toda empresa séria. O AI red teaming ajuda a identificar vulnerabilidades antes que o modelo chegue às mãos de usuários reais, ou de invasores reais.
O que é AI red teaming
O termo vem da análise militar: uma "equipe vermelha" simulava as ações do adversário para descobrir falhas na própria defesa antes de um confronto real. No mundo da IA, isso significa tentativas organizadas de enganar, quebrar ou forçar um modelo a se comportar de maneira indesejada.
O teste de software tradicional verifica se o sistema funciona conforme a especificação. O AI red teaming verifica como ele se comporta fora dela. É ali que ficam as falhas mais perigosas.
Os especialistas usam vários tipos de ataque:
- Injeções de prompt: tentativas de fazer o modelo ignorar as instruções do sistema e sair do comportamento definido
- Extração de dados: tentativas de obter, a partir das respostas do modelo, dados de treinamento ou informações confidenciais dos usuários
- Manipulações em várias etapas: empurrar o modelo aos poucos a violar suas restrições por meio de uma série de pedidos aparentemente inofensivos
- Adversarial inputs: entradas construídas sob medida para alterar a resposta do modelo de forma inesperada ou prejudicial
- Teste de viés: busca sistemática por padrões discriminatórios, tóxicos ou nocivos nas respostas
Por que isso é tão importante
Empresas que pulam essa etapa assumem riscos significativos. Modelos de linguagem integrados a processos de negócio podem dar conselhos perigosos, expor dados pessoais sem querer ou ser usados em fraudes por meio de um sistema em que os usuários confiam.
Os reguladores já começam a exigir isso. A Lei de IA da UE prevê avaliação de segurança obrigatória para sistemas de alto risco antes de chegarem ao mercado. Nos EUA, o NIST publicou um framework de gerenciamento de riscos de IA em que a avaliação da resistência a ataques ocupa posição central. Em finanças, saúde e defesa, os reguladores setoriais vão ainda além.
"Modelos podem estar convincentemente confiantes em respostas erradas ou nocivas.
Por isso é preciso um olhar independente e hostil sobre cada sistema", é a posição comum de pesquisadores de segurança em IA.
Quem faz e como
No mercado de AI red teaming surgiram vários tipos de fornecedores. Grandes consultorias incorporaram o serviço à sua prática de cibersegurança. Em paralelo, cresceu uma geração de startups especializadas, vindas da pesquisa acadêmica sobre segurança de LLMs.
Gama típica de serviços:
- Busca automatizada de vulnerabilidades com agentes de IA atacantes
- Testes manuais por equipes com experiência em aprendizado de máquina e engenharia social
- Monitoramento contínuo do comportamento de um sistema já em produção
- Avaliações especializadas para setores específicos e exigências normativas
Anthropic, OpenAI e Google DeepMind fazem red teaming interno em larga escala para seus modelos de base. Mas, ao embutir um LLM de terceiros no próprio produto, a empresa passa a ter um sistema fundamentalmente diferente: outro contexto, outros usuários, outros riscos. Isso exige uma verificação à parte.
O que isso significa
O AI red teaming deixa de ser um nicho acadêmico e passa a ser parte padrão do ciclo de vida de um produto de IA. Empresas que ignoram essa etapa correm o risco de ficar despreparadas, tanto para as exigências regulatórias quanto para os incidentes reais que já acontecem em toda a indústria.
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Kimi marca 96,2% em teste de análise em base 1C e vira reserva caso o Claude seja bloqueado
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Google admite que o AI Mode reduz a receita da Busca; ações caem 15%
Perguntas frequentes sobre a notícia
O que é AI red teaming?
O termo vem da análise militar: uma "equipe vermelha" simulava as ações do adversário para descobrir falhas na própria defesa antes de um confronto real. No mundo da IA, isso significa tentativas organizadas de enganar, quebrar ou forçar um modelo a se comportar de maneira indesejada. O teste de software tradicional verifica se o sistema funciona conforme a especificação. O AI red teaming verifica como ele se comporta fora dela. É ali que ficam as falhas mais perigosas. Os especialistas usam vários tipos de ataque: Injeções de prompt: tentativas de fazer o modelo ignorar as
Por que isso é tão importante?
Empresas que pulam essa etapa assumem riscos significativos. Modelos de linguagem integrados a processos de negócio podem dar conselhos perigosos, expor dados pessoais sem querer ou ser usados em fraudes por meio de um sistema em que os usuários confiam. Os reguladores já começam a exigir isso. A Lei de IA da UE prevê avaliação de segurança obrigatória para sistemas de alto risco antes de chegarem ao mercado. Nos EUA, o NIST publicou um framework de gerenciamento de riscos de IA em que a avaliação da resistência a ataques ocupa posição central. Em finanças, saúde e defesa,
O que se sabe sobre Quem faz e como?
No mercado de AI red teaming surgiram vários tipos de fornecedores. Grandes consultorias incorporaram o serviço à sua prática de cibersegurança. Em paralelo, cresceu uma geração de startups especializadas, vindas da pesquisa acadêmica sobre segurança de LLMs. Gama típica de serviços: Busca automatizada de vulnerabilidades com agentes de IA atacantes Testes manuais por equipes com experiência em aprendizado de máquina e engenharia social Monitoramento contínuo do comportamento de um sistema já em produção Avaliações especializadas para setores específicos e exigências normat
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.