New Computer aumenta em 50% a precisão da busca na memória do agente com o LangSmith
A New Computer é uma startup que desenvolve um assistente pessoal de IA com memória de longo prazo. A equipe aumentou em 50% a precisão da busca nessa memória usando a ferramenta de observabilidade LangSmith. O segredo foi o modo de comparação de testes, que ajudou a perceber regressões antes de as mudanças chegarem à produção e a corrigir prompts rapidamente. O resultado: o agente ficou duas vezes mais confiável para encontrar o contexto certo de conversas passadas.
Processado por IA de LangChain Blog; editado por Hamidun News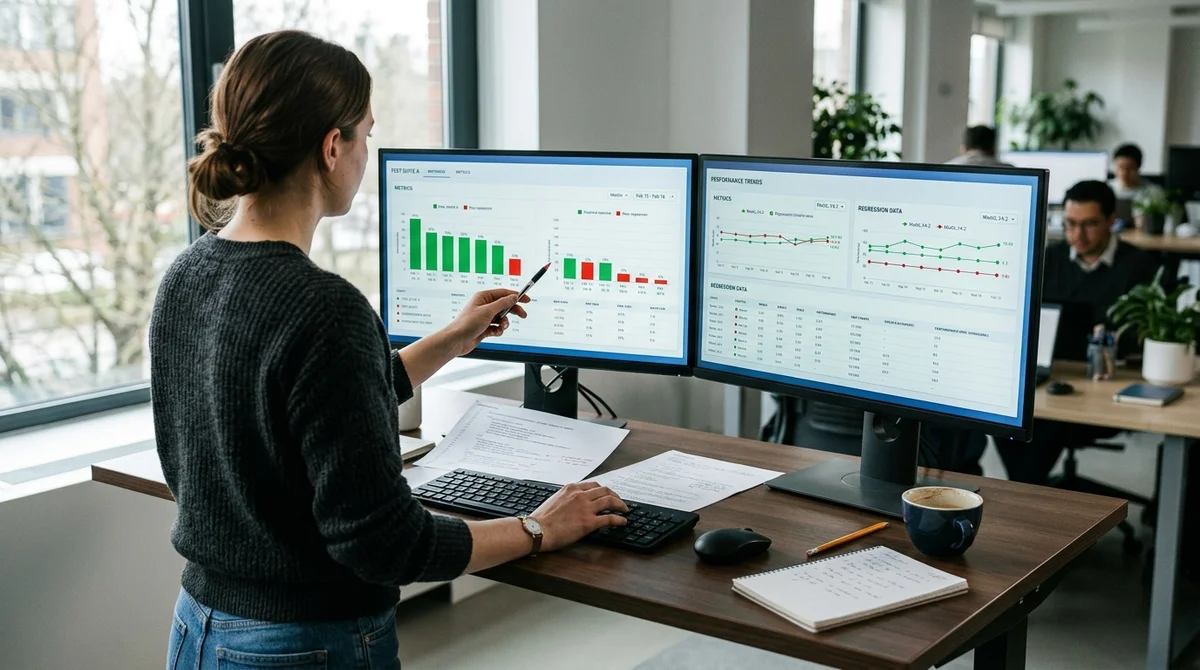
A startup New Computer aumentou em 50% a precisão da busca no sistema de memória de seu agente de IA com a ferramenta de observabilidade LangSmith. O mérito não está em uma arquitetura nova, mas em uma metodologia disciplinada de teste de prompts.
Por que agentes precisam de memória de longo prazo
O produto da New Computer é um assistente pessoal de IA que realmente lembra do usuário: preferências, conversas passadas, hábitos e contexto de vida. Essa abordagem diferencia radicalmente o assistente de um chatbot comum, que começa do zero a cada conversa.
Implementar memória de longo prazo é uma tarefa tecnicamente nada trivial. Não dá para simplesmente salvar tudo o que foi dito e enviar ao contexto do modelo toda vez: o volume de dados cresce, e o custo das requisições inviabiliza essa abordagem. Em vez disso, os sistemas de memória se baseiam em busca: da base acumulada, só os trechos relevantes são extraídos.
É aí que entra a métrica de recall (abrangência da busca): com que frequência o sistema encontra exatamente as memórias de que precisa naquele momento. Um recall baixo significa que o agente "não lembra" de detalhes importantes mesmo quando eles estão na base. Para um assistente pessoal, isso é um problema crítico.
O que o LangSmith trouxe
O LangSmith é uma ferramenta de observabilidade da LangChain: registra cada etapa do funcionamento de um aplicativo com LLM, permite criar datasets de teste e comparar versões do sistema em uma interface clara. A equipe da New Computer montou um processo iterativo em torno de algumas funções:
- Comparison View — comparação visual de duas execuções: dá para ver quais cenários melhoraram e quais pioraram
- Rastreamento de regressões — detecção automática de casos em que a nova versão do sistema perde para a anterior
- Ciclo rápido de iterações — mudar o prompt → rodar o teste → comparar resultados → aceitar ou reverter
- Registro de conversas — o histórico completo de requisições ajudou a identificar padrões em que a busca na memória falhava
O principal insight: sem comparação estruturada, as regressões ficavam invisíveis. Quando um prompt melhorava alguns cenários, ele quebrava outros sem ninguém notar. O LangSmith tornou essas quebras visíveis na hora, antes de as mudanças chegarem à produção.
Da intuição a resultados mensuráveis
Antes do LangSmith, a equipe trabalhava no esquema "testamos, parece melhor". Avaliações subjetivas não permitiam comparar versões com segurança: variáveis demais, dados mensuráveis de menos.
Depois da adoção dos testes comparativos, cada mudança de prompt passou a rodar por um conjunto de cenários de teste. Os resultados eram registrados e comparados com a versão anterior, e as mudanças só eram aceitas após uma melhora confirmada. A regressão deixou de ser um "algo quebrou" aleatório e virou um problema diagnosticável e controlável.
O resultado foi um aumento de 50% no recall: o agente passou a encontrar memórias relevantes de conversas passadas uma vez e meia com mais frequência. Para um assistente pessoal, cujo valor se mede pela qualidade da memória, é uma melhoria fundamental do produto.
O que isso significa
O caso da New Computer mostra que a qualidade de um produto de IA hoje não é definida apenas pela arquitetura ou pela escolha do modelo base, mas também pelo sistema de observabilidade. Equipes que enxergam suas regressões em tempo real iteram mais rápido, e isso se converte diretamente em métricas.
Ferramentas como o LangSmith tiram o desenvolvimento de aplicações com LLM do modo "parece que funciona" e o levam para melhorias mensuráveis e reproduzíveis.
Perguntas frequentes sobre a notícia
Por que agentes precisam de memória de longo prazo?
O produto da New Computer é um assistente pessoal de IA que realmente lembra do usuário: preferências, conversas passadas, hábitos e contexto de vida. Essa abordagem diferencia radicalmente o assistente de um chatbot comum, que começa do zero a cada conversa. Implementar memória de longo prazo é uma tarefa tecnicamente nada trivial. Não dá para simplesmente salvar tudo o que foi dito e enviar ao contexto do modelo toda vez: o volume de dados cresce, e o custo das requisições inviabiliza essa abordagem. Em vez disso, os sistemas de memória se baseiam em busca: da base acumul
O que o LangSmith trouxe?
O LangSmith é uma ferramenta de observabilidade da LangChain: registra cada etapa do funcionamento de um aplicativo com LLM, permite criar datasets de teste e comparar versões do sistema em uma interface clara. A equipe da New Computer montou um processo iterativo em torno de algumas funções: Comparison View — comparação visual de duas execuções: dá para ver quais cenários melhoraram e quais pioraram Rastreamento de regressões — detecção automática de casos em que a nova versão do sistema perde para a anterior Ciclo rápido de iterações — mudar o prompt → rodar o teste → com
O que se sabe sobre Da intuição a resultados mensuráveis?
Antes do LangSmith, a equipe trabalhava no esquema "testamos, parece melhor". Avaliações subjetivas não permitiam comparar versões com segurança: variáveis demais, dados mensuráveis de menos. Depois da adoção dos testes comparativos, cada mudança de prompt passou a rodar por um conjunto de cenários de teste. Os resultados eram registrados e comparados com a versão anterior, e as mudanças só eram aceitas após uma melhora confirmada. A regressão deixou de ser um "algo quebrou" aleatório e virou um problema diagnosticável e controlável. O resultado foi um aumento de 50% no rec
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.