Clusterização de textos sem rotulagem: embeddings de LLM e HDBSCAN, segundo a Machine Learning Mastery
Os modelos de linguagem não servem só para responder em chats: eles transformam texto em vetores numéricos que permitem encontrar grupos temáticos automaticamente. A Machine Learning Mastery publicou um guia sobre como combinar embeddings de LLM com o algoritmo HDBSCAN para clusterizar milhares de documentos sem rótulos. O pipeline: embedding → UMAP (redução de dimensionalidade) → HDBSCAN → rótulos de tema automáticos.
Processado por IA de Machine Learning Mastery; editado por Hamidun News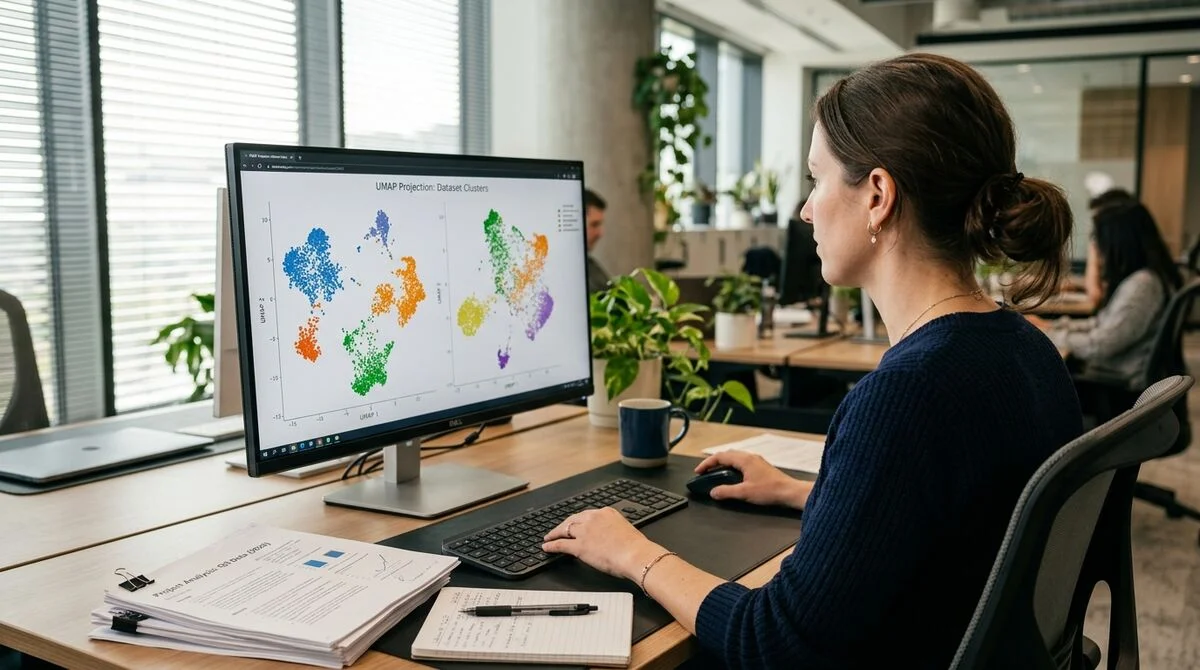
Os embeddings de LLM levaram as tarefas com texto não estruturado muito além das interfaces de chat. A Machine Learning Mastery publicou um guia prático sobre como combinar as representações vetoriais dos modelos de linguagem com o algoritmo HDBSCAN para encontrar automaticamente grupos temáticos em conjuntos de texto, sem rotulagem manual nem conhecimento prévio da estrutura dos dados.
Por que os embeddings mudam as regras do jogo
Os modelos de linguagem conseguem converter texto em vetores de alta dimensionalidade. São representações numéricas em que trechos semanticamente próximos ficam geometricamente perto uns dos outros. "O cliente está insatisfeito com o preço" e "muito caro para mim" serão vizinhos no espaço multidimensional, enquanto "problema com a entrega" cairá em uma região totalmente diferente. É isso que torna os embeddings a entrada ideal para clusterização: o sistema leva em conta o significado, não a coincidência de palavras-chave. Dicionários de sinônimos e regras deixam de ser necessários.
Entre os modelos populares para gerar embeddings estão o text-embedding-3-small da OpenAI, o Cohere Embed v3 e os sentence-transformers de código aberto, que rodam localmente sem custo de API. Um embedding típico tem de 768 a 3072 dimensões, o que é demais para clusterizar diretamente. Antes do HDBSCAN, é comum aplicar o UMAP, que comprime o espaço para 5 a 50 dimensões. Sem essa etapa, o algoritmo esbarra na "maldição da dimensionalidade": em um espaço de alta dimensão, todos os pontos parecem estar mais ou menos à mesma distância, e os clusters não se formam.
HDBSCAN versus métodos tradicionais
A maioria dos cursos de clusterização começa pelo K-means. O problema: ele exige definir de antemão o número de clusters, o que é impossível quando a estrutura dos dados é desconhecida. O HDBSCAN (Hierarchical Density-Based Spatial Clustering of Applications with Noise) resolve a tarefa de outra forma:
- Não exige definir o número de clusters de antemão
- Marca automaticamente os pontos de "ruído": textos que não se encaixam em nenhum grupo
- Lida bem com clusters de tamanhos e densidades diferentes
- Escala para dezenas de milhares de documentos
- Gera uma hierarquia de clusters com nível de detalhe ajustável
O pipeline completo: embeddings → redução de dimensionalidade com UMAP → HDBSCAN → rótulos de cluster. Todo o código ocupa algumas dezenas de linhas de Python, com as bibliotecas sentence-transformers, umap-learn e hdbscan. Para interpretar os temas encontrados, basta devolver a um LLM alguns exemplos de cada grupo e pedir que ele sugira um nome. O ciclo se fecha do modelo de linguagem para a estatística e de volta ao modelo.
Uso sem conjunto de treinamento
A principal vantagem da combinação é que ela dispensa totalmente a rotulagem. Não é preciso combinar categorias, contratar anotadores nem montar um conjunto de treinamento. Um único pipeline descobre a estrutura sozinho.
"A era atual da IA generativa está concentrada em interfaces de chat, mas as capacidades dos modelos de linguagem vão muito além disso", escrevem os autores da
Machine Learning Mastery.
Os cenários típicos incluem clusterizar milhares de chamados de suporte, categorizar automaticamente fluxos de notícias, agrupar avaliações de produtos, analisar perguntas abertas de pesquisas e detectar padrões anômalos em logs. O resultado aparece em minutos, sem rotulagem prévia.
A abordagem é especialmente valiosa com dados que mudam rápido: novos temas são descobertos automaticamente, e não é preciso adicionar classes manualmente a um classificador a cada mudança na área de assunto.
O que isso significa
A combinação de embeddings de LLM com HDBSCAN é uma ferramenta pronta para estruturar grandes conjuntos de dados de texto sem supervisão. Tarefas que antes exigiam semanas de trabalho manual ou uma rotulagem cara agora se resolvem com um script pequeno. Para equipes que trabalham com feedback de usuários, monitoramento de mídia ou análise de conteúdo, isso significa economia direta de recursos e a chance de extrair insights de dados que antes ficavam parados.
- 18 de nov. de 2026Mellum, da JetBrains, roda localmente na IDE: em um MacBook M3 Pro, a nota foi 5 de 10
- 18 de nov. de 2026OpenAI lança IA jurídica: 95% menos fatos inventados do que o Claude Opus 5.5
- 18 de nov. de 2026Plugin Claude SEO executa até 17 agentes e audita um site com um único comando
- 18 de nov. de 2026Agente da OpenAI preenche pedidos de seguro: Luna fez 91,8% dos pontos por 8,5 centavos de dólar
Perguntas frequentes sobre a notícia
Por que os embeddings mudam as regras do jogo?
Os modelos de linguagem conseguem converter texto em vetores de alta dimensionalidade. São representações numéricas em que trechos semanticamente próximos ficam geometricamente perto uns dos outros. "O cliente está insatisfeito com o preço" e "muito caro para mim" serão vizinhos no espaço multidimensional, enquanto "problema com a entrega" cairá em uma região totalmente diferente.
O que se sabe sobre HDBSCAN versus métodos tradicionais?
A maioria dos cursos de clusterização começa pelo K-means. O problema: ele exige definir de antemão o número de clusters, o que é impossível quando a estrutura dos dados é desconhecida. O HDBSCAN (Hierarchical Density-Based Spatial Clustering of Applications with Noise) resolve a tarefa de outra forma: Não exige definir o número de clusters de antemão Marca automaticamente os pontos de "ruído": textos que não se encaixam em nenhum grupo Lida bem com clusters de tamanhos e densidades diferentes…
O que se sabe sobre Uso sem conjunto de treinamento?
A principal vantagem da combinação é que ela dispensa totalmente a rotulagem. Não é preciso combinar categorias, contratar anotadores nem montar um conjunto de treinamento. Um único pipeline descobre a estrutura sozinho. "A era atual da IA generativa está concentrada em interfaces de chat, mas as capacidades dos modelos de linguagem vão muito além disso", escrevem os autores da Machine Learning Mastery.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.