AWS SageMaker ganha monitoramento completo de LLMs em produção
A AWS embutiu o monitoramento completo de LLMs no SageMaker AI. Os novos dashboards do Grafana acompanham o uso de GPU, a velocidade de processamento de tokens e a qualidade das respostas. O recurso é voltado a produção com modelos populares, como Llama, Mistral e Claude.
Processado por IA de AWS Machine Learning Blog; editado por Hamidun News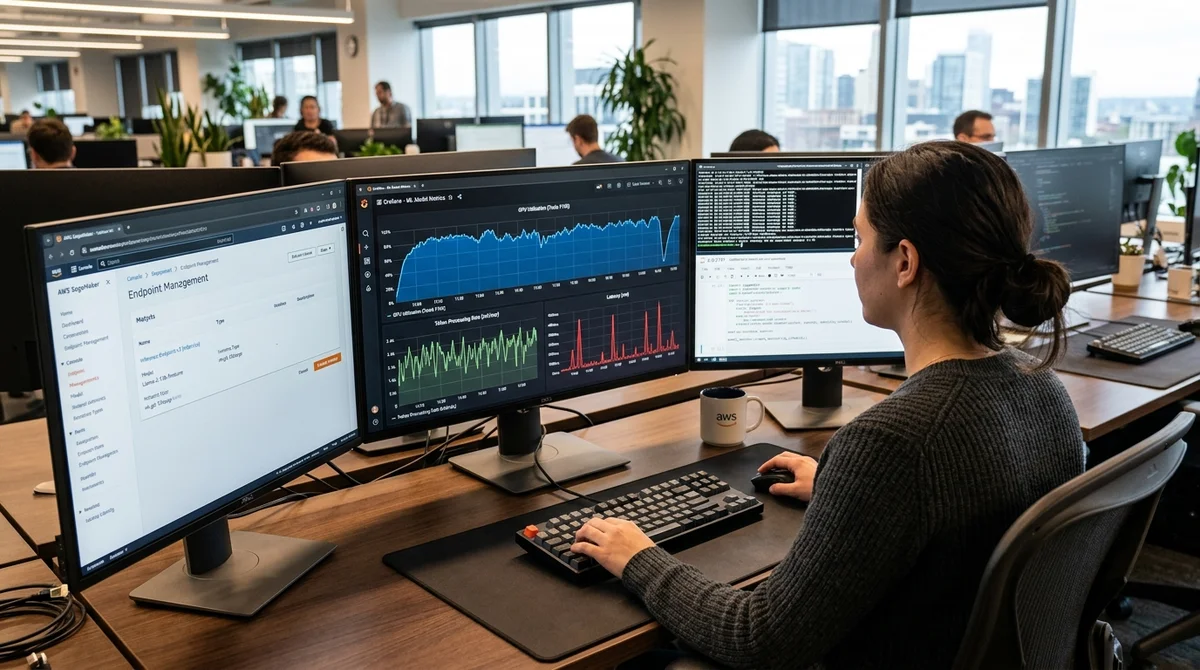
A AWS adicionou monitoramento abrangente para LLMs executados na plataforma SageMaker AI. Com o Amazon Managed Grafana, agora é possível acompanhar tanto métricas técnicas (uso de GPU, latência) quanto indicadores de qualidade (precisão das respostas, alucinações).
O que é monitorado
A AWS definiu duas categorias de métricas. A primeira são os recursos: utilização das placas de vídeo, uso de memória e número de tokens processados por segundo. A segunda é a qualidade do modelo: latência de resposta, precisão da geração, presença de alucinações e aderência às instruções originais.
Os novos dashboards coletam automaticamente dados dos endpoints do SageMaker e os exibem em tempo real. Isso importa: em produção, não basta ver que "o servidor está funcionando"; é preciso saber também que "o modelo está respondendo corretamente".
As métricas embutidas incluem:
- Utilização de GPU e uso de memória
- Velocidade de processamento de tokens de entrada e de saída
- Latência (o atraso entre a requisição e a resposta do modelo)
- Toxicidade e alucinações na saída
- Aderência às instruções e métricas de compliance
Por que isso importa
Um LLM em produção não é apenas um hardware que foi ligado e está funcionando. O modelo pode carregar e o processador pode estar ativo, mas a qualidade das respostas pode ser baixa. O modelo pode dar respostas erradas, ser lento ou aprender um comportamento indesejado.
Antes, os engenheiros precisavam integrar manualmente o registro de logs ao Prometheus, ao ELK ou a outros sistemas de monitoramento. Isso exigia tempo e um conhecimento profundo das métricas. Agora a ferramenta está embutida diretamente no SageMaker.
A AWS oferece templates de dashboard prontos para modelos populares: Llama, Mistral, Claude e outros. O engenheiro pode implantar o monitoramento em poucos cliques, sem escrever código customizado.
Quando é útil
O monitoramento completo é crítico quando um LLM atende usuários reais ou sustenta processos de negócio importantes. Exemplos: um chatbot de atendimento ao cliente, um assistente de IA para análise de documentos, um gerador automático de conteúdo e um assistente de busca em base de conhecimento.
Se o modelo começa a dar respostas mais longas, estranhas ou menos úteis, isso aparece nas métricas antes de as reclamações dos usuários chegarem. Uma queda inesperada na utilização de GPU pode indicar problemas na fila de requisições ou esgotamento de memória.
A AWS destaca que a observabilidade não é uma solução temporária, mas
a base para uma implantação confiável de LLMs em produção.
O que isso significa
Monitorar LLMs está se tornando, aos poucos, um padrão, como já acontece com aplicações web comuns. A AWS torna isso mais acessível ao embutir ferramentas de observabilidade prontas diretamente na plataforma SageMaker.
Para as equipes de engenharia, isso significa menos tempo escrevendo scripts de integração sob medida e mais foco na qualidade dos próprios LLMs. Isso deve acelerar a implantação de soluções de IA em produção.
- 31 de out. de 2026Worldwide Express entrega contas contestadas a agentes de IA e reduz dívida em 75%
- 30 de out. de 2026AWS dá a agentes de código uma prévia ao vivo do site direto da sessão isolada
- 30 de out. de 2026MoEngage abre 400 APIs privadas a agentes de IA via AgentCore Gateway, sem servidores MCP próprios
- 29 de out. de 2026NVIDIA Nemotron 3.5 Super VL: 120 bilhões de parâmetros, 12 bilhões ativos, com implantação na AWS
Perguntas frequentes sobre a notícia
O que é monitorado?
A AWS definiu duas categorias de métricas. A primeira são os recursos: utilização das placas de vídeo, uso de memória e número de tokens processados por segundo. A segunda é a qualidade do modelo: latência de resposta, precisão da geração, presença de alucinações e aderência às instruções originais. Os novos dashboards coletam automaticamente dados dos endpoints do SageMaker e os exibem em tempo real. Isso importa: em produção, não basta ver que "o servidor está funcionando"; é preciso saber também que "o modelo está respondendo corretamente". As métricas embutidas incluem:
Por que isso importa?
Um LLM em produção não é apenas um hardware que foi ligado e está funcionando. O modelo pode carregar e o processador pode estar ativo, mas a qualidade das respostas pode ser baixa. O modelo pode dar respostas erradas, ser lento ou aprender um comportamento indesejado. Antes, os engenheiros precisavam integrar manualmente o registro de logs ao Prometheus, ao ELK ou a outros sistemas de monitoramento. Isso exigia tempo e um conhecimento profundo das métricas. Agora a ferramenta está embutida diretamente no SageMaker. A AWS oferece templates de dashboard prontos para modelos
Quando é útil?
O monitoramento completo é crítico quando um LLM atende usuários reais ou sustenta processos de negócio importantes. Exemplos: um chatbot de atendimento ao cliente, um assistente de IA para análise de documentos, um gerador automático de conteúdo e um assistente de busca em base de conhecimento. Se o modelo começa a dar respostas mais longas, estranhas ou menos úteis, isso aparece nas métricas antes de as reclamações dos usuários chegarem. Uma queda inesperada na utilização de GPU pode indicar problemas na fila de requisições ou esgotamento de memória. A AWS destaca que a o
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.