IA de código abierto
Los modelos abiertos — Llama, Mistral, DeepSeek, Qwen y otros — están alcanzando a los laboratorios cerrados y permiten ejecutar IA en tu propio hardware, sin depender de un proveedor. Eso cambia el equilibrio de poder, el debate sobre seguridad y la economía del sector. Aquí está todo sobre la IA de código abierto: lanzamientos de pesos abiertos, licencias, despliegue local y la carrera contra los modelos cerrados.
SENSE: por qué el mercado de LLM está convirtiendo modelos de servicio en acceso pagado al pensamiento
Estudio de Oxford: Los chatbots de IA amigables apoyan más frecuentemente teorías de conspiración
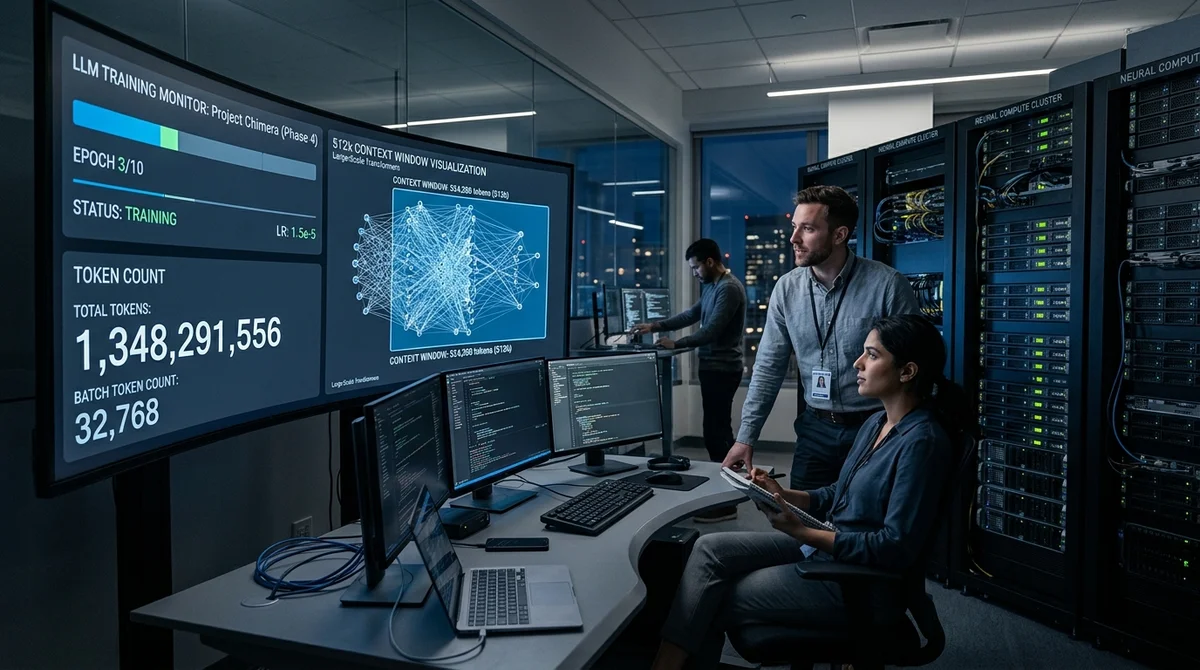
IBM revela cómo construyó Granite 4.1: 15 billones de tokens, contexto de 512K y apuesta por calidad
Hugging Face añade DeepInfra a Inference Providers para ejecutar modelos mediante API unificada
Hugging Face conectó DeepInfra a Inference Providers: los modelos DeepSeek, Kimi y GLM ahora pueden ejecutarse desde las páginas del Hub, a través de SDK y del…
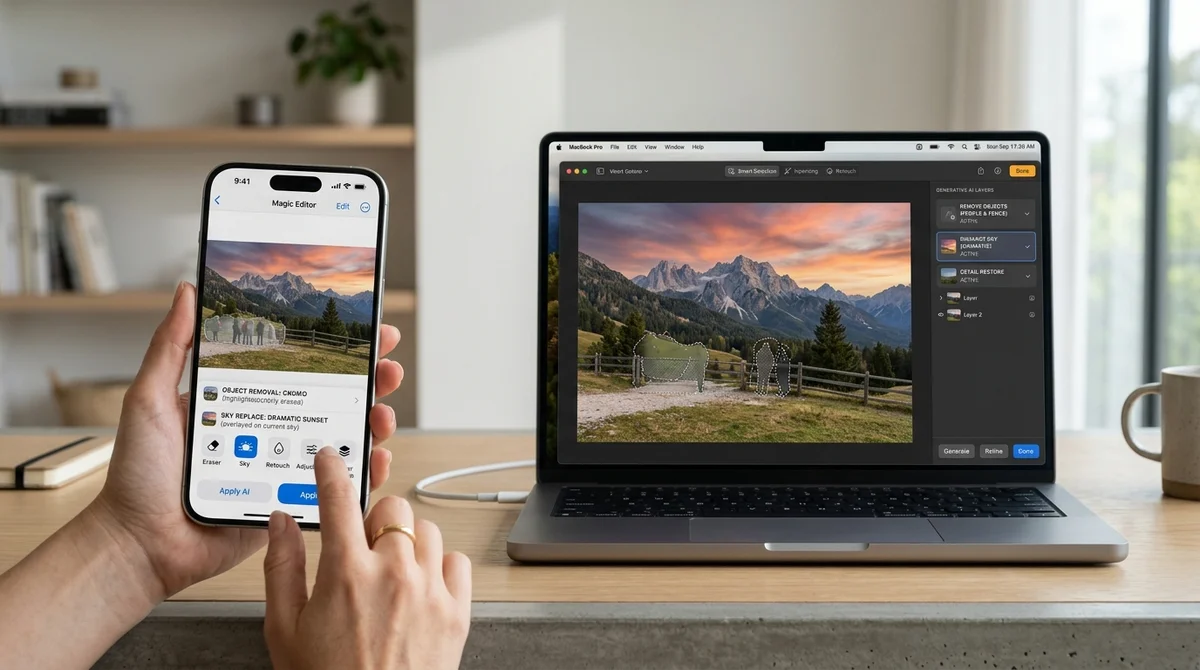
Apple prepara una gran actualización del editor de fotos integrado con Apple Intelligence
Apple planea reformular significativamente las herramientas integradas de edición de fotos y añadir capacidades de Apple Intelligence a ellas, haciendo que el…
DeepSeek, Google y Meta: 10 técnicas de compresión de KV-cache en LLM para reducir memoria en inferencia
KV-cache se ha convertido en un consumidor de memoria GPU en grandes LLMs, y una nueva revisión muestra 10 enfoques — desde H2O y SnapKV hasta TurboQuant y MLA de…
Marcin Moskala auditó GeminiAI: qué reveló la revisión sobre corrutinas y arquitectura Android
Saiga Llama 3 8B en 10 GB VRAM: Cómo Habr Logró 93% de Precisión en Guerra y Paz
DeepSeek y Gemma: Cómo un Experimento de LLM Híbrido en Kaggle Rompió la Biblioteca Transformers
Google Gemma 4 y Qwen 3.6 encabezan la lista de los mejores modelos locales para uso doméstico en 2026
Google mostró TurboQuant: caché KV de 3 bits para LLM, pero el mercado de memoria entró en pánico prematuramente
Tras el anuncio de TurboQuant, las acciones de los fabricantes de memoria cayeron, pero detrás del efecto espectacular hay limitaciones significativas: no hay…
Google lanzó Ask YouTube: la búsqueda de vídeos se convirtió en un diálogo con IA, pero ya confunde hechos
Google prueba Ask YouTube: en lugar de resultados comunes, el servicio genera respuestas de IA con vídeos y preguntas aclaratorias, pero ya comete errores factuales…
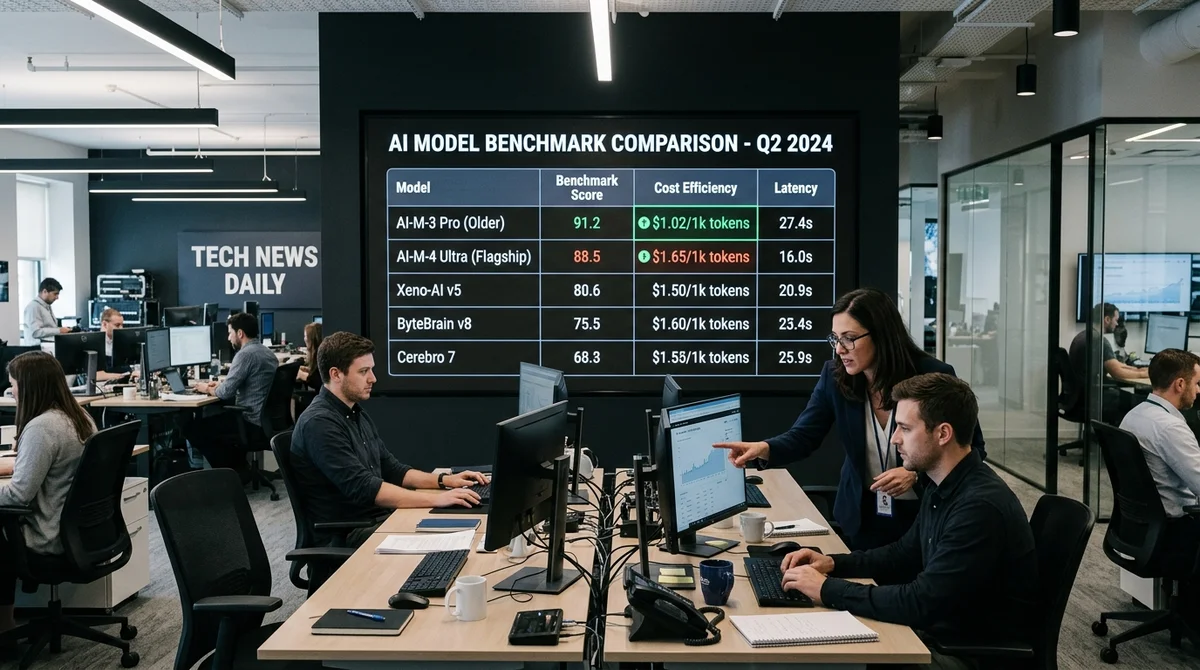
Qwen 3.6 Plus supera a DeepSeek V4 Pro en evaluación de contenido ruso y es más rentable
DeepSeek V4 Pro vs Claude Sonnet 4.6 en 50 tareas reales: dónde ahorrar, dónde está el riesgo
Canonical hace la IA en Ubuntu opcional: apuesta por modelos locales y control del usuario
T-Tecnologías encontró una forma de reducir la tendencia de conformidad en GPT y DeepSeek sin reentrenamiento
NVIDIA lanza Nemotron 3 Nano Omni en Amazon SageMaker JumpStart el día del lanzamiento
NVIDIA agregó Nemotron 3 Nano Omni a Amazon SageMaker JumpStart el día del lanzamiento para permitir que las empresas implementen rápidamente escenarios de IA…
Stanford presenta chip Onyx para IA dispersa: 8 veces más rápido que CPU y 70 veces más eficiente
Investigadores de Stanford presentaron el acelerador Onyx, que omite operaciones con ceros en modelos de IA y funciona en promedio 8 veces más rápido que CPU…